25GB 内存的笔记本,去跑 744B 参数的 GLM-5.2,乍看像一句很适合放在标题里的话。
完整 int4 权重约 372GB。上下文缓存、运行时内存、操作系统占用都还没算进去,25GB 和 372GB 之间也没有什么优化技巧能直接抹平。照过去部署本地模型的习惯,答案就是装不下。
开源项目 Colibrì 换了个问法。既然一个超大 MoE 模型并非每一刻都要用到全部权重,能否只把眼下会用到的那一小撮留在快存储里,其余部分放到 NVMe SSD,需要时再取?
项目及其相关报道给出的结果颇有吸引力:约 25GB RAM 的机器可以尝试运行 GLM-5.2,32GB RAM 起可挑战 2.8T 参数的 Kimi K3。这里的关键词是「尝试运行」,不是「获得和云端一样顺滑的体验」。这两者差得很远,也正是 Colibrì 最值得聊的地方。
它没有让 SSD 变成显存。它是在承认 SSD 很慢以后,尽量少去碰它。
744B 这个数字,不能直接拿来判断内存需求
GLM-5.2 的 744B 指完整模型的总参数量。对于稠密模型,这个数字和部署压力往往紧紧绑在一起,因为每次生成 token 时,大部分参数都会参与计算。
Mixture of Experts(专家混合,MoE) 模型的工作方式不同。模型里有很多专家网络,Router(路由器)会在每一次生成时判断该叫哪几个专家来处理。总参数仍然很大,真正激活、参与当前计算的部分却小得多。
公开材料以 GLM-5.2 为例,称它每个 token 约激活 40B 参数。这个数字会随模型版本、量化方式与具体实现而变,不过它足以说明问题:绝大多数路由专家在某个瞬间并不干活。
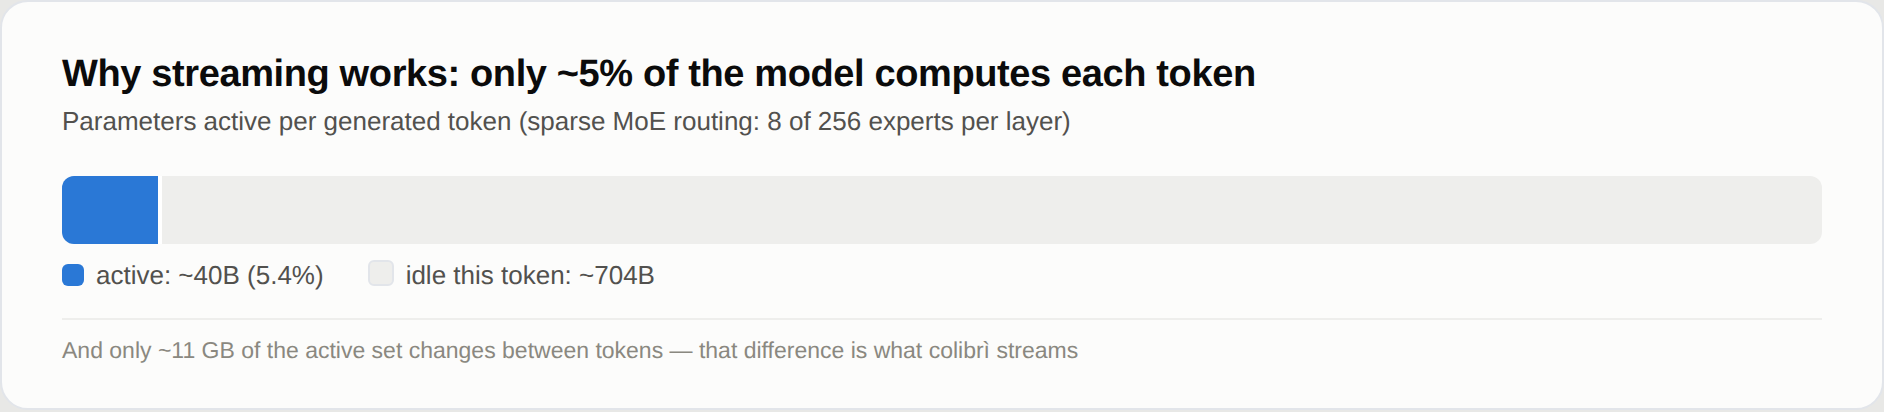
图源:Colibrì 官方仓库,展示 GLM-5.2 的 MoE 稀疏激活思路。
此前大家会先想办法把整个模型搬进显存或内存,装完才开始推理。对于 MoE,这个前提其实可以松一松。没有被 Router 点名的专家,既不计算,也不一定非要挤在 RAM 里占位置。
Colibrì 的做法就围绕这个判断展开。Attention、Embedding、共享专家等高频组件常驻 RAM;被点名的路由专家优先从 RAM 或 VRAM 中找;缓存没命中,才去 NVMe SSD 拿。运行久一点后,常用专家会尽量留在更快的那层。
想象一下餐馆后厨会更容易理解。灶台边放的是每天都用的油盐和锅具,常点的食材放在冰箱近处,仓库里那批不常用的原料不会一开始全搬出来。Colibrì 做的是类似的分工,只不过它调度的是模型权重。
把 SSD 叫作显存,反而看不清它的代价
「SSD 当显存」确实好记,但这个说法会误导人。
显存、系统内存和 NVMe SSD 的带宽、延迟和访问模式根本不在一个级别。权重躺在 SSD 里,不会让它突然拥有显存速度。它带来的只是一个新的可能性:机器不必因为装不下完整权重而直接退出游戏,但生成时要接受更多等待。
公开材料称,在一台 12 核 CPU、25GB RAM 的开发机上,GLM-5.2 冷缓存速度约为 0.05~0.1 token/s。这个水平足以启动、观察和研究,却很难拿来做长时间聊天或实时编码。等模型吐一段完整答复,喝一杯咖啡都不一定够。
所以 Colibrì 的核心难题从来不是「怎样把更多模型塞进 SSD」,而是「怎样避免每个 token 都从 SSD 找东西」。项目公开描述中提到三种常见却很关键的办法。
LRU(最近最少使用)缓存负责留下刚用过的专家,下一次又选到它们时,省掉一次磁盘读取。访问频率统计负责识别长期热点,让真正高频的专家更愿意留在 RAM。预取则更冒险一点,利用相邻层路由选择可能存在的相关性,在当前层计算还没结束时,先把下一层可能需要的权重读进来。
这套思路并不新奇。操作系统会做页缓存,数据库会区分冷热数据,CDN 也依靠缓存把远端资源尽量拉近用户。Colibrì 有意思的地方是,MoE 的 Router 让它多了一张「未来可能会读什么」的提示纸条。
不过,这张纸条不是保证。预取猜错了,会白白占用 I/O 带宽和缓存空间;热点分布不稳定,LRU 也未必帮得上忙。最终的体验高度依赖模型路由特征、SSD 性能、内存大小和任务本身。
真正需要计算的,是一笔硬件账
如果只是问「这台电脑能不能启动模型」,答案会比较简单。可一旦打算真正用起来,就得看一组互相牵连的条件。
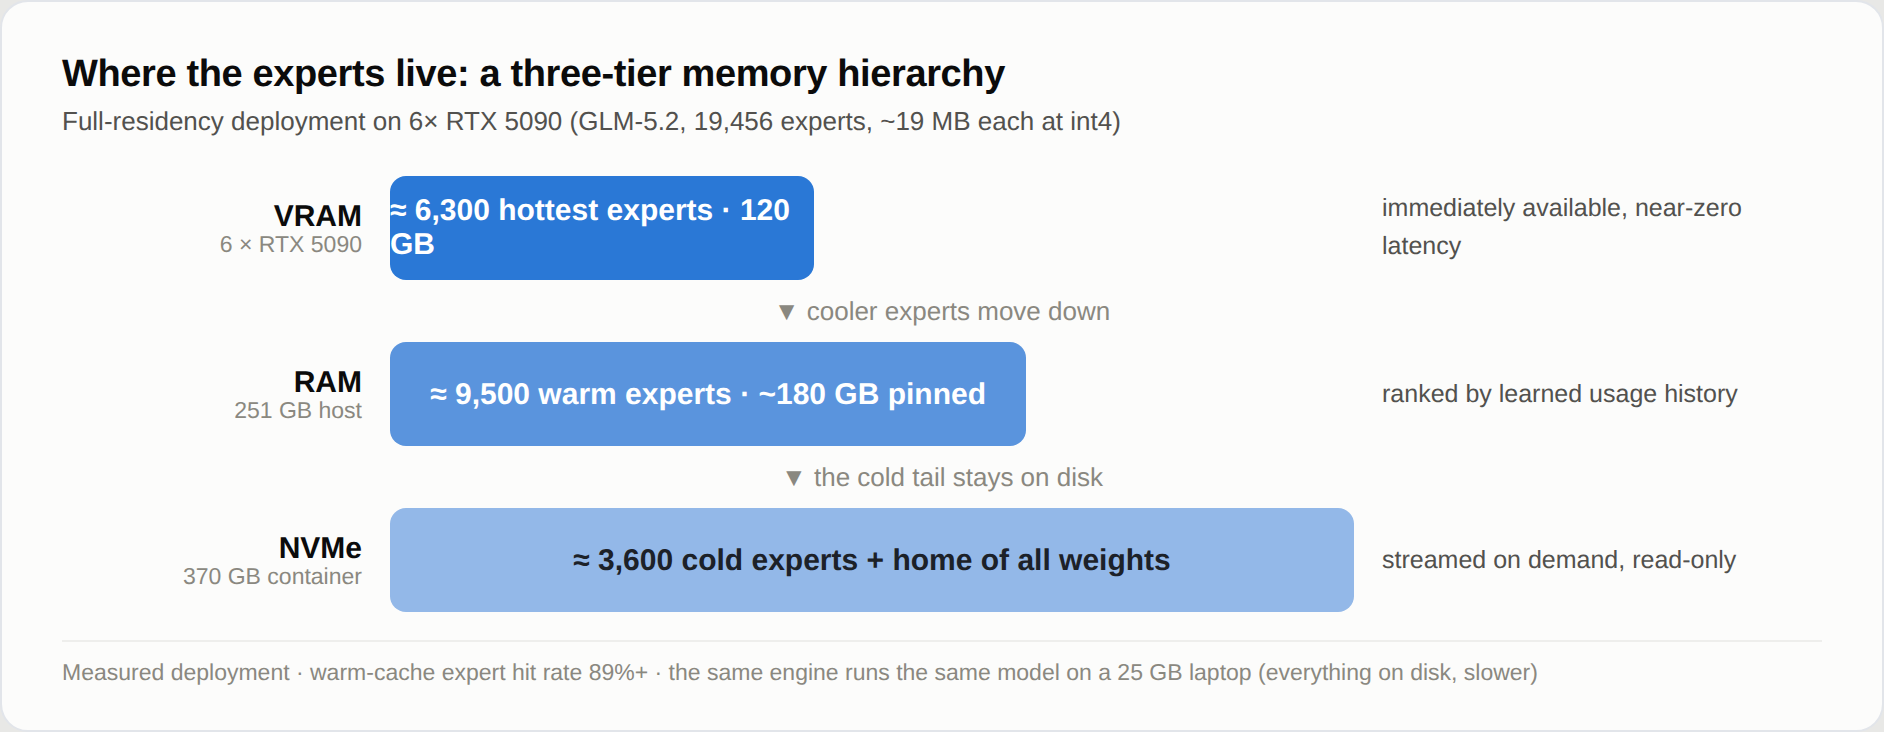
图源:Colibrì 官方仓库,展示项目所称的 AI memory multitiering(AI 内存多层化)。
| 存储层 | 在 Colibrì 式设计里的角色 | 现实限制 |
|---|---|---|
| VRAM | 放最怕延迟、最常访问的一小部分权重 | 容量贵,显卡门槛高 |
| RAM | 常驻共享组件,缓存热点专家 | 容量有限,也会和系统及其他程序争资源 |
| NVMe SSD | 保存完整的长尾专家权重 | 容量相对便宜,读取延迟依然很高 |
因此,升级路线也多了一点层次。增加内存,可能让更多热点专家留得住;换更快的 SSD,或者使用多块盘分摊读取,可能减少长尾权重的等待;加 GPU,则能把最热的一部分路径再往前推。
它们都不是免费午餐。预取更积极,可能增加无用读取;缓存开得更大,可能挤压系统可用内存;SSD 够快,模型权重本身仍要占数百 GB 甚至数 TB。你买到的不是一个「跑得动 744B」的开关,而是不同预算下完全不同的交互体验。
这也是 MoE 对本地部署带来的变化。过去大家看显卡时,习惯先问显存够不够;今后还得问:活跃参数有多少?路由专家是否可预测?哪些权重值得常驻?这些问题听着偏底层,最后都会落到屏幕前最直观的感受上:首 token 要等多久,中途会不会卡,能不能稳定完成一项任务。
先别急着下载 2.8T 的模型
Kimi K3 的例子尤其能让人冷静下来。按公开材料的说法,它的权重需要约 1.6TB 磁盘空间,32GB RAM 只是尝试启动的下限之一。下载、校验、格式转换、临时文件和备份都会继续吃空间。即便模型成功跑起来,也不代表它能替代一个日常使用的在线服务。
我觉得在动手前可以先把需求说清楚。
如果你的目标是离线处理敏感文档,或者研究 MoE 权重调度,等待更久可能是值得的。如果只是想获得一个更大、更强的聊天模型,云端服务往往仍然简单得多。还有一种情况是做本地 Agent 的离线批处理,例如让模型夜里慢慢扫一批文档、代码或日志。此时低吞吐并不一定致命,容量和隐私反而会排到前面。
Colibrì 不负责替你选答案。它只是把过去「显存不够,没法谈」的局面,拉成了一张可以权衡的表:存储、时间、隐私、下载成本、电费、维护复杂度,外加你对慢的容忍度。
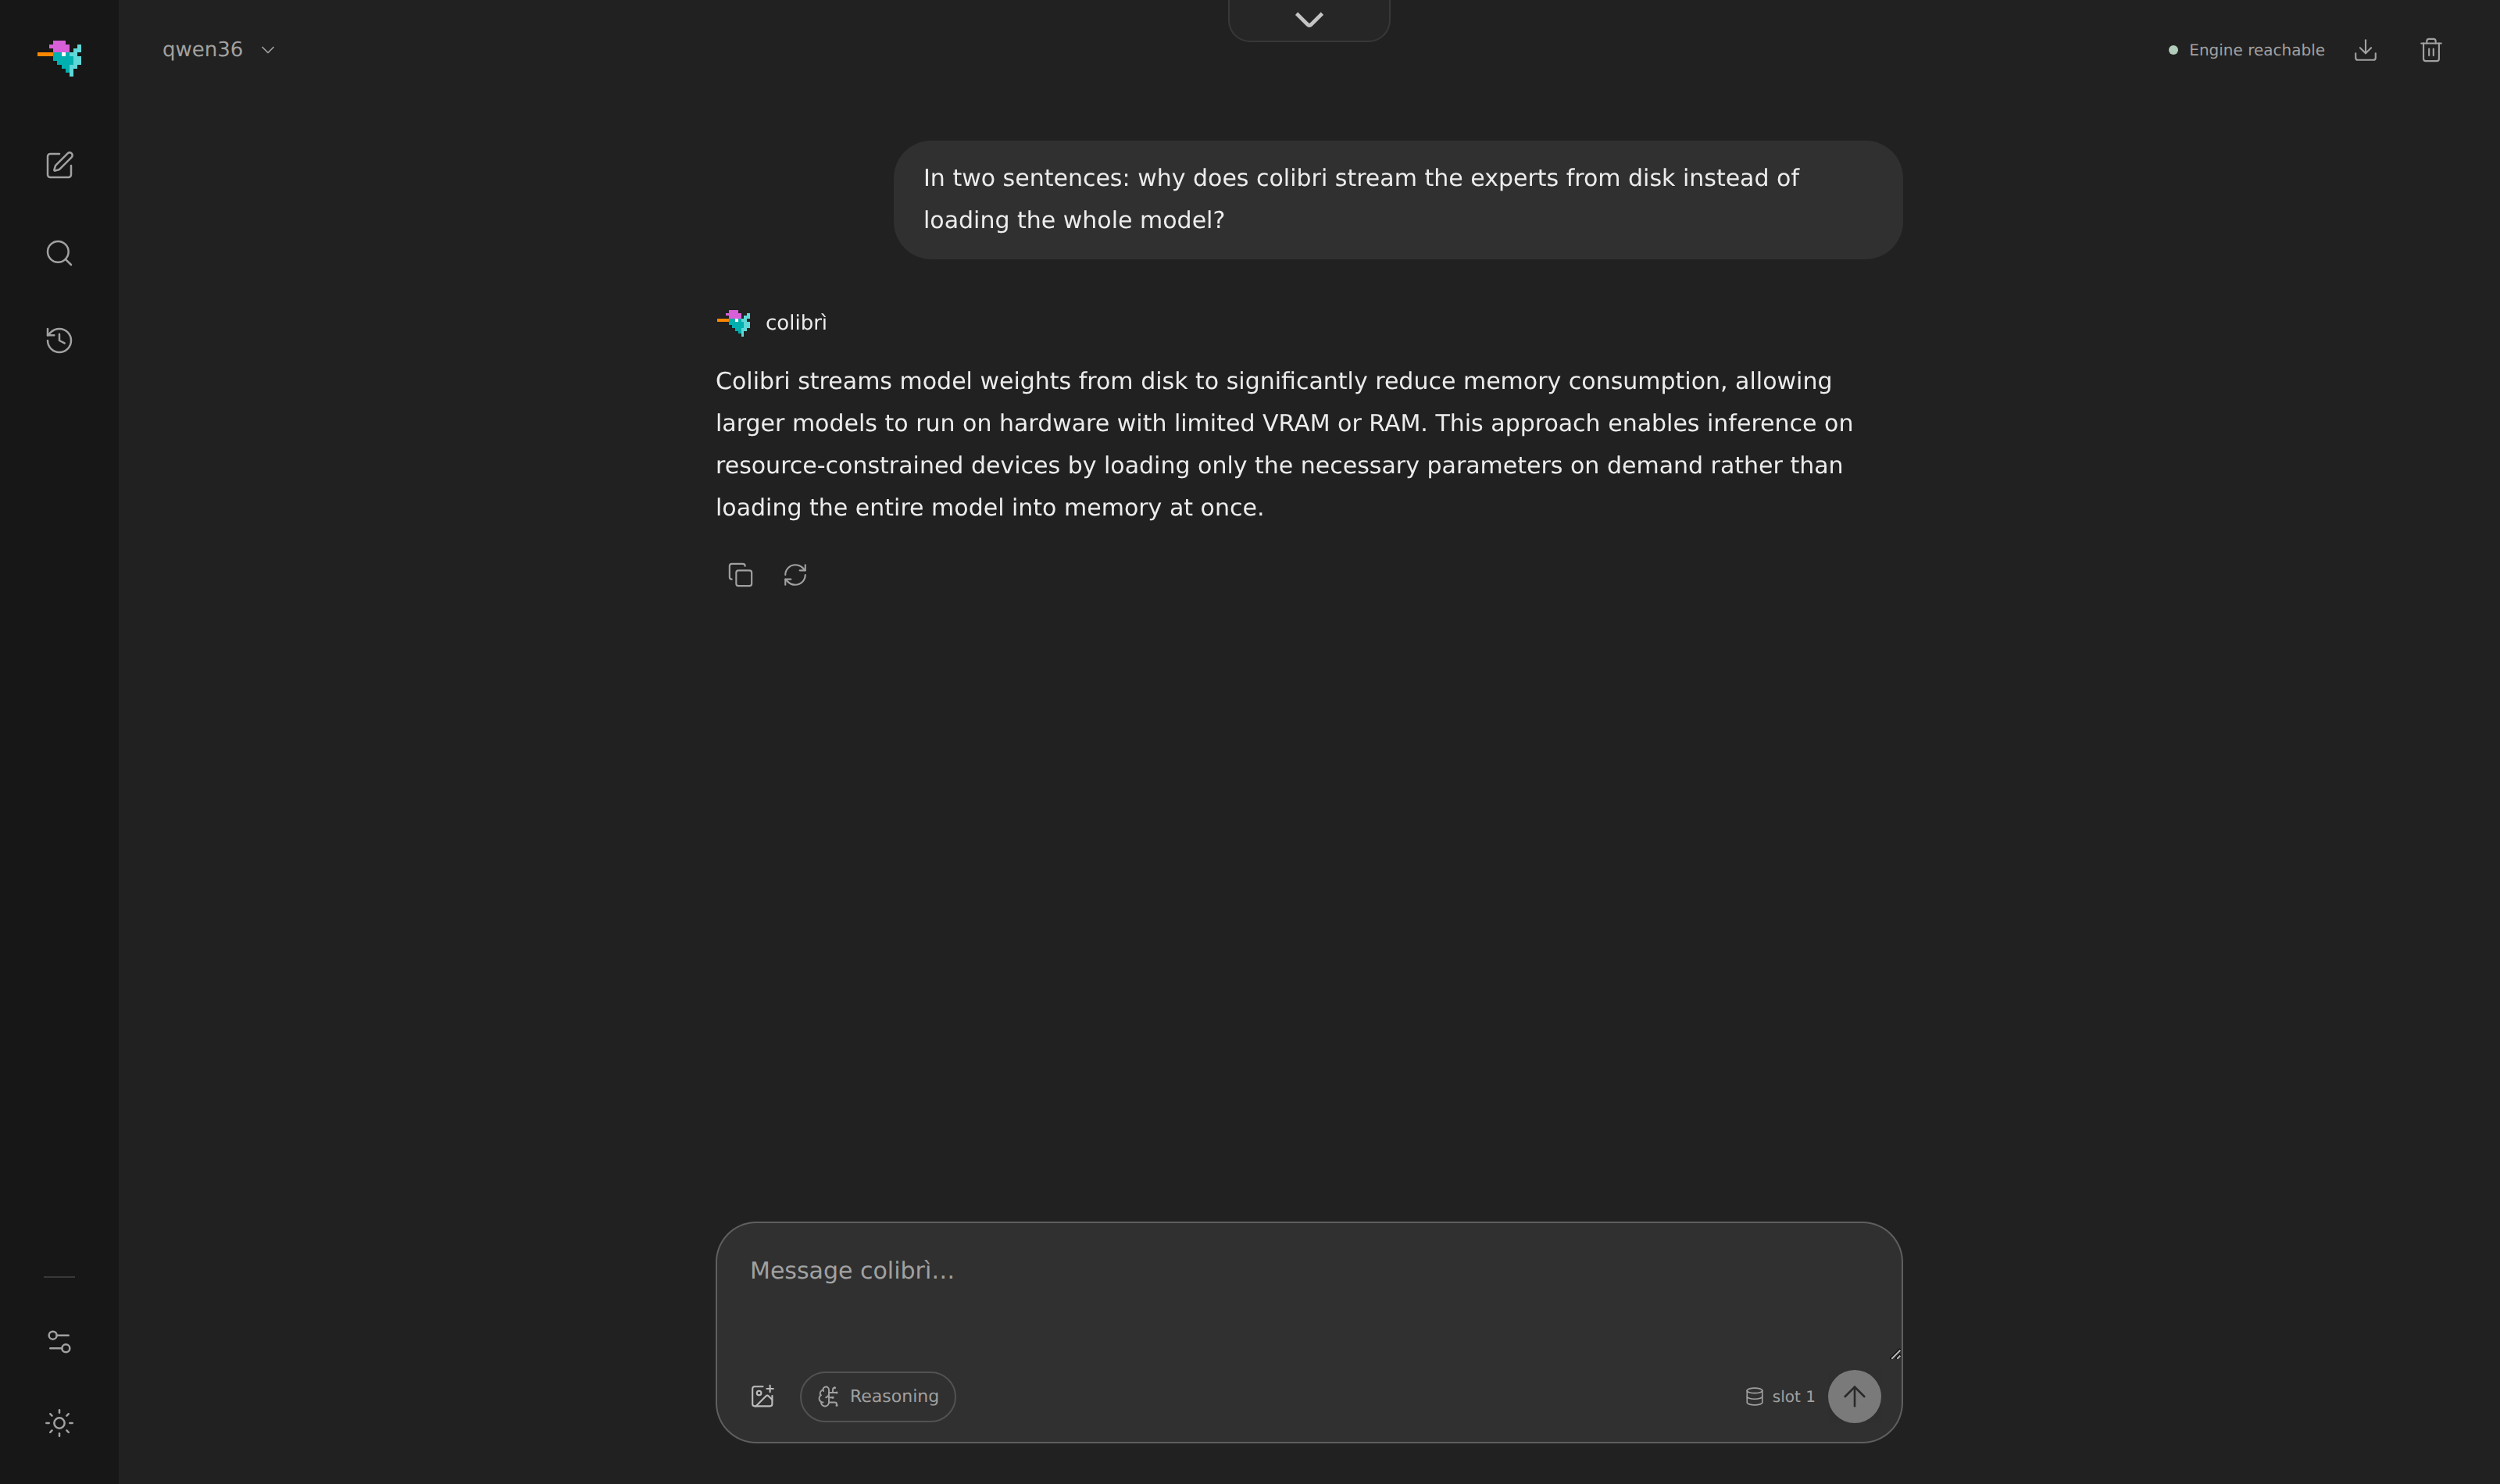
图源:Colibrì 官方仓库,项目 Web Dashboard 截图。
大模型不只是一块要塞进显卡的文件
看 Colibrì,很容易把注意力停在 744B、25GB、无 GPU 这些数字上。但它留下的启发比数字更长久。
大模型在本地跑起来,至少有三件事在同时发生。总参数决定你要保存多少权重;活跃参数决定一次推理实际搬动和计算多少;存储层级决定这些权重抵达计算单元的速度。过去显存容量把三件事压成了一个问题,现在 MoE 和分层调度开始把它们拆开。
这不意味着个人电脑很快就能平替数据中心。更多时候,它意味着本地 AI 系统会越来越像数据系统:要知道什么数据应常驻,什么数据可以延迟读取,缓存命中后是否真的有收益,出错或资源不足时又该退到哪一层。
Colibrì 把这套逻辑放在模型权重上。以后本地 Agent 面对的或许还有文档库、代码仓库、长期记忆和多个模型。届时,VRAM、RAM 与 SSD 之间怎么分工,很可能和上下文窗口怎么分配一样,成为普通开发者也绕不开的设计题。
参考来源
- Colibrì GitHub 仓库(官方图片与项目说明,Apache 2.0)
- 智源社区转载量子位:笔记本跑 7000 亿参数 GLM,无 GPU 也行?
以上来源用于核对项目公开描述与媒体转述的配置、性能数字,并不等同于独立基准测试。若准备购买硬件或用于生产环境,仍应对照项目仓库、模型卡和自己的工作负载复验。