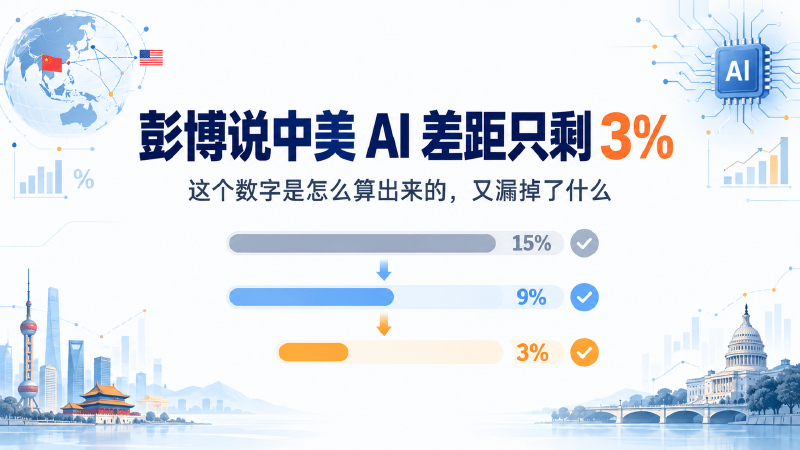
彭博行业研究测算,DeepSeek V4.1 Flash 发布后,中美顶尖模型基准分差缩至 3%,年初还是 15%。但 3% 是两家旗舰在单一榜单上的分差,LiveBench 前 15 名里只有 3 个中国模型,Agent 能力榜单更是另一幅图景。这份报告该怎么读,比数字本身更值得琢磨。
ARC-AGI-3 递给大模型的不是画面,而是一张 64×64 的数字表。何恺明团队的 VISTA 只做了三件事:把数字换回图片、给模型一本随时能翻的相册、再带上两页笔记。同一个 Claude 就从 40 分打到满分。智能的瓶颈,可能不在参数里。
Apple 宣布将为 macOS 全盘访问增加更明确的授权控制。结合 Meta Muse 的消息读取争议,讨论一次系统授权为何回答不了长期读取、主动建议和聊天另一方隐私的问题。
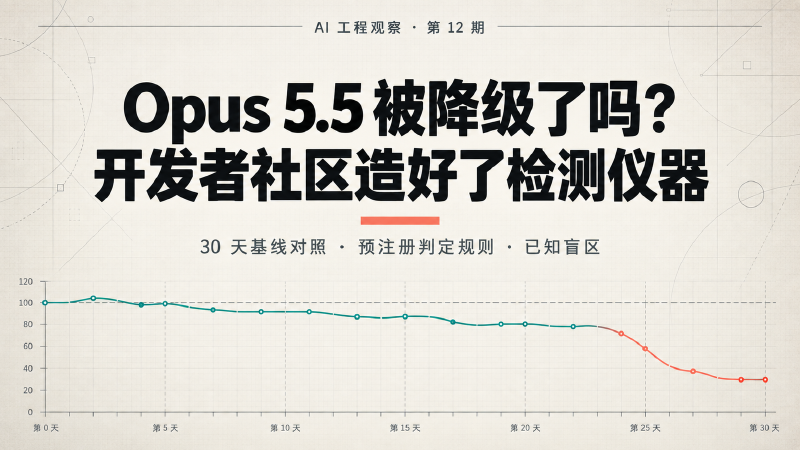
r/ClaudeAI 一周内两条万赞热帖指向 Claude Opus 5.5 静默降级。真正的变化不是抱怨变多,而是有人开源了 livenerf——每天跑 78 道题、预注册判定规则、用纯函数打分,30 天后给出结论。
《人工智能拟人化互动服务管理暂行办法》7 月 15 日施行。它管的不是 AI 说了什么,而是 AI 表现得像不像人——这是全球第一份把「关系本身」当作管制对象的技术法规。