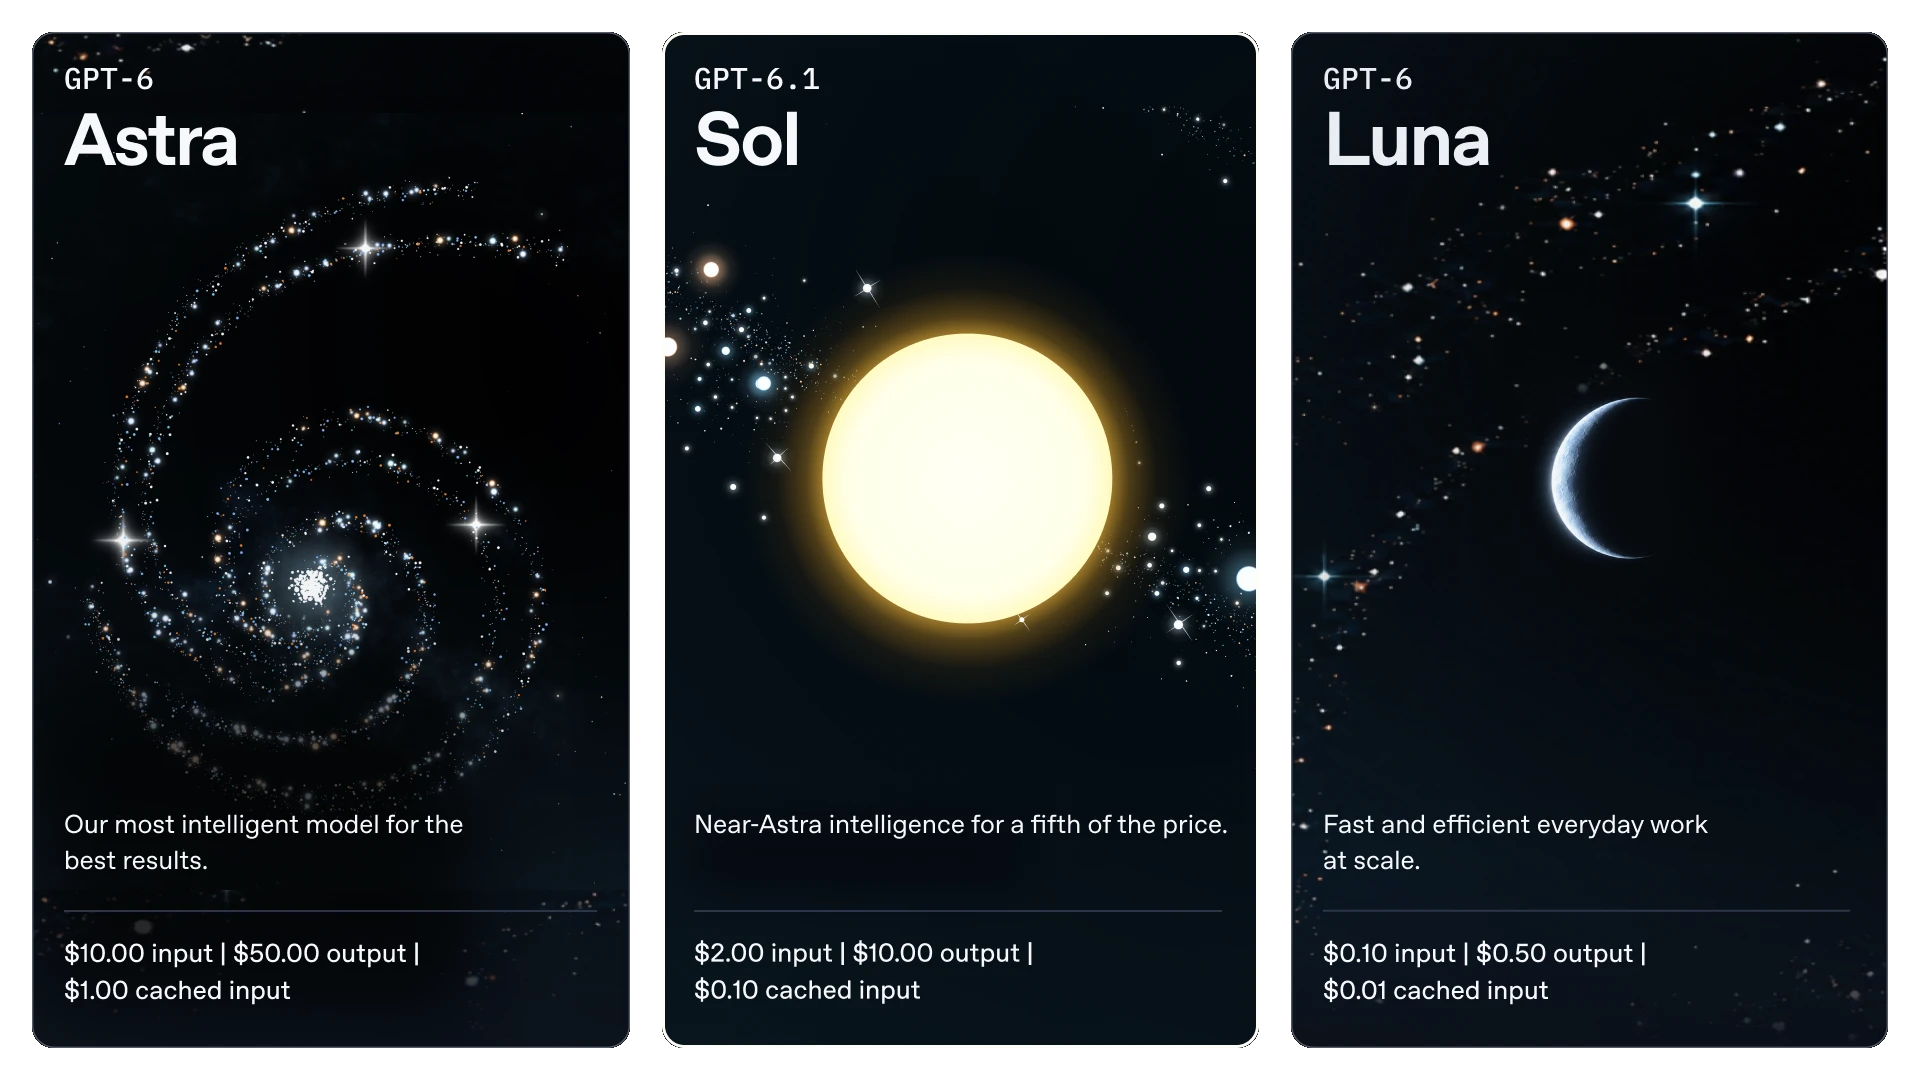
OpenAI 在 9 月 30 日发布 GPT-6.1 Sol。按公告给出的定位,它适合智能体编程、计算机操作和专业工作任务,能力接近 GPT-6 Astra,标准输入和输出的价格约为 Astra 的五分之一。API 的价格是每百万 token 输入 2 美元、缓存输入 0.10 美元、输出 10 美元。
看到这种消息,最直接的反应往往是,模型又便宜了,拿来聊天或写代码能省一笔钱。这个判断没有错,只是放到 Agent 身上,账要从别处开始算。
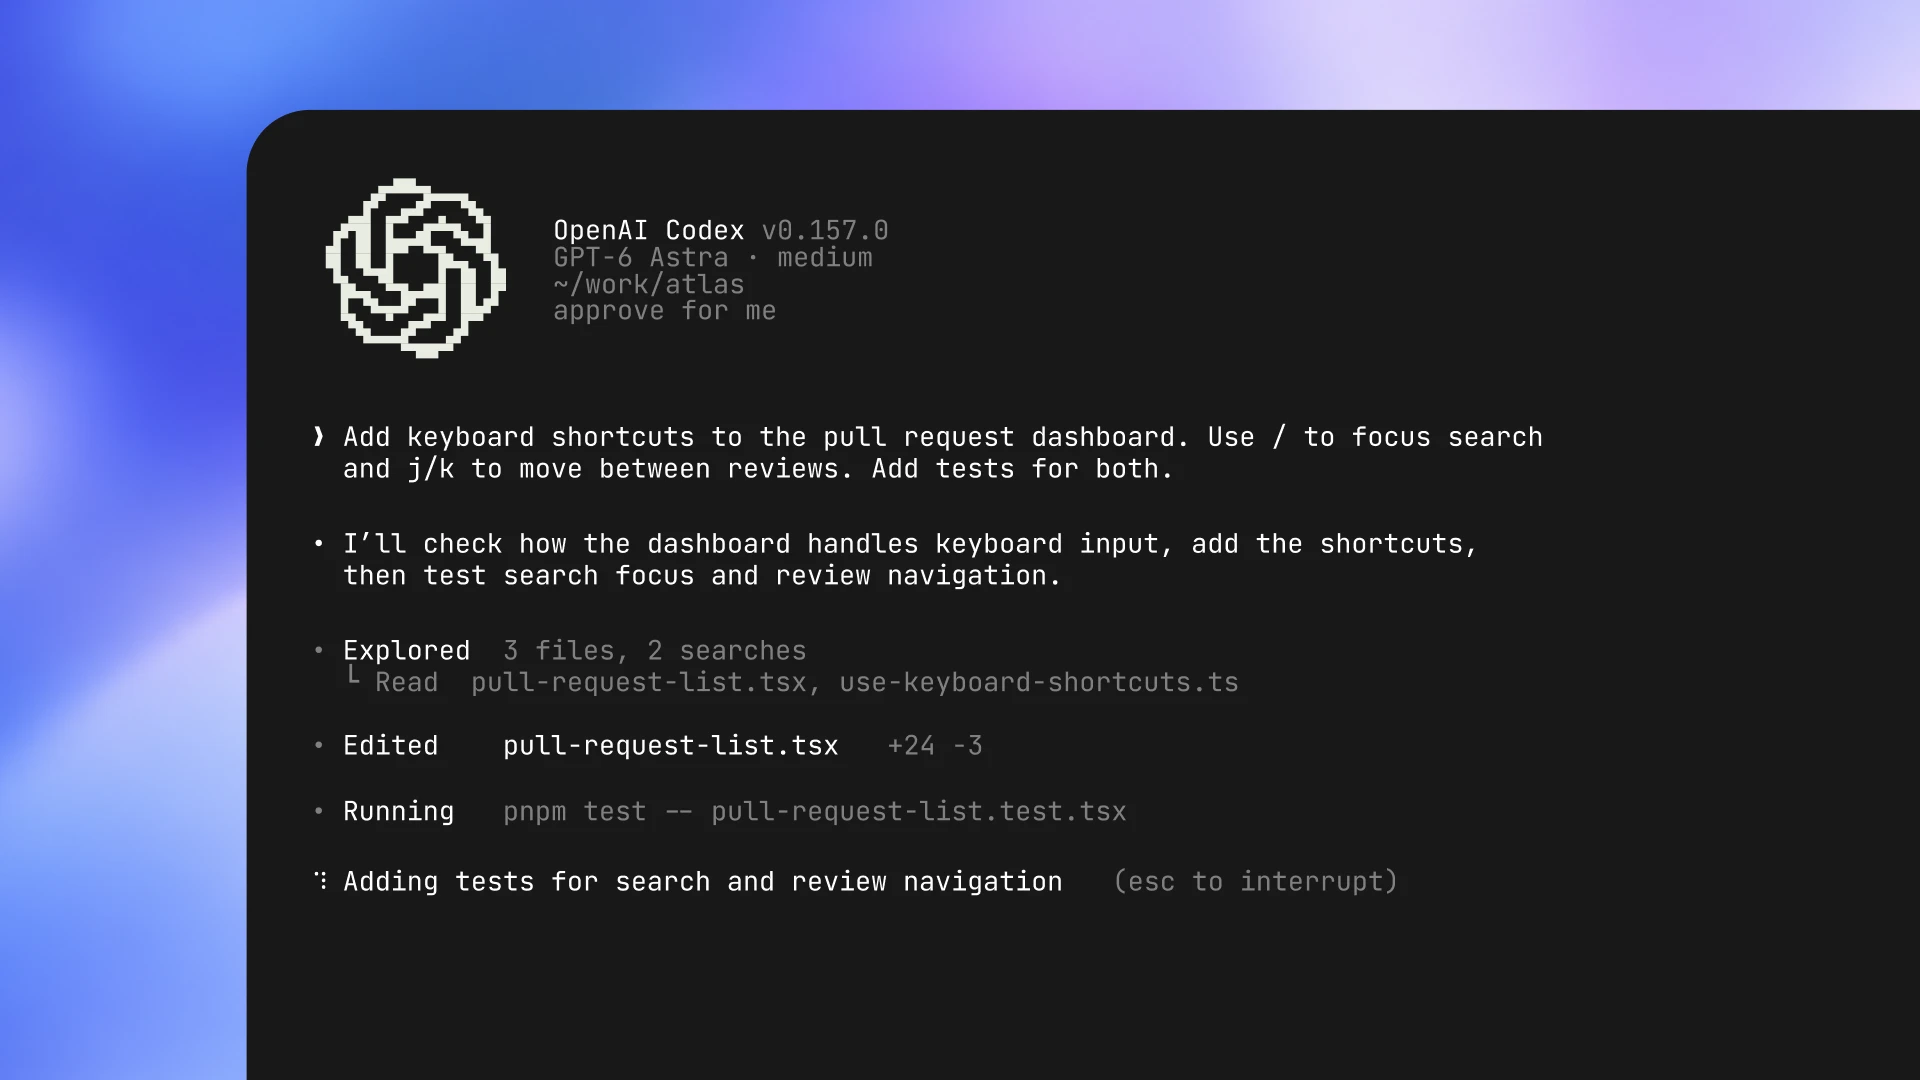
一个会读仓库、改文件、跑测试、开浏览器、调用工具的 Agent,很少是一轮就结束。它第一次改错了,要不要再跑一次。测试红了,要不要把完整日志送回去。页面看着像能用,是否还要让它真的点一遍。结果不放心,是换一档模型复核,还是开发者自己接手。
这些动作原来经常被压缩掉。模型调用贵,长上下文也贵,任务跑到七八成像是能交了,人就把它接过来收尾。省下的是一轮推理费,后面花掉的是排查、返工和复查的时间。
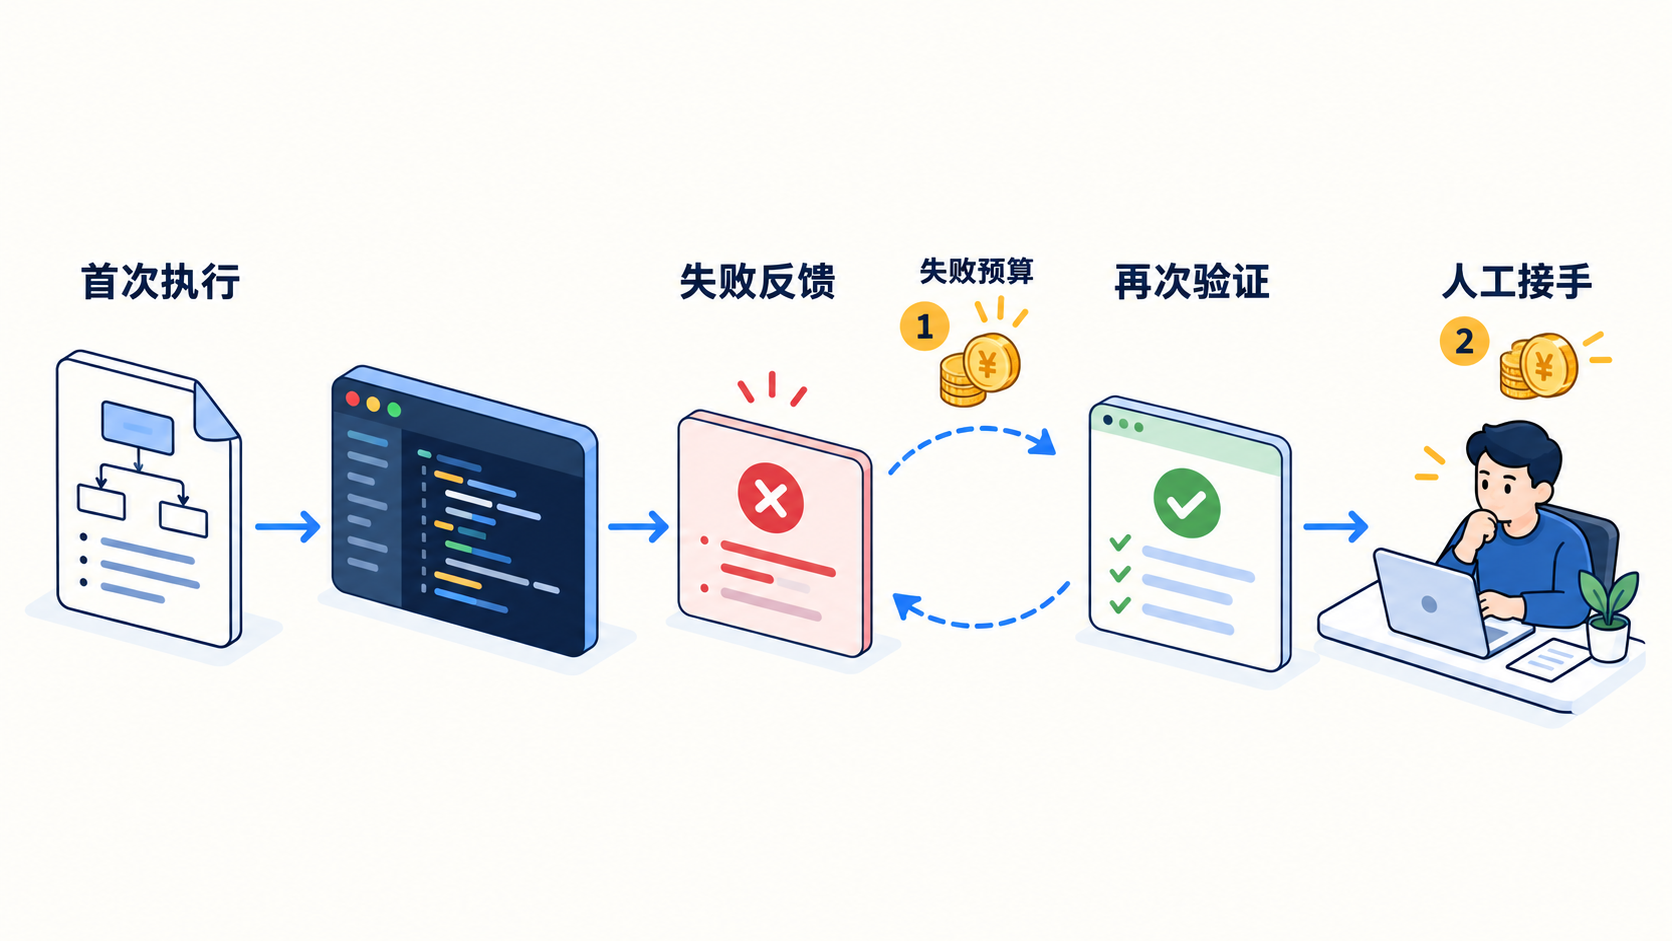
我想把这部分钱叫作失败预算。团队要预先承认,机器第一次交出来的结果可能有问题,并为后续验证和修正留出次数、时间与成本。
账单从第一次回答以后才开始
一个真实功能通常不是“生成代码”四个字能说完的。
Agent 先看项目说明和相关文件,给出计划,改代码,运行测试。报错以后,它读日志、再改一轮。涉及界面时,它还得打开页面,点一下关键按钮。某些任务最后要看 diff,有些任务要检查数据库迁移,有些任务必须由人确认。模型最后吐出的那段代码,只是整个过程里最显眼的一笔。
上下文也会跟着任务变长。需求、文件片段、命令输出、失败日志、测试结果和截图分析,会一轮轮回到模型面前。长任务还得保留一些不该变的东西,比如仓库规则、接口约束、允许动哪些目录、验收条件和已经确认过的结论。
OpenAI 给 GPT-6.1 Sol 的缓存输入价格是每百万 token 0.10 美元,比标准输入低 95%。这个价格不会保证所有 Agent 任务都便宜。输出 token、推理强度、浏览器、沙箱、数据库和第三方服务仍会继续计费。不过它让团队少了一个很常见的顾虑。上一轮已经核过的规则和证据,不必因为输入太贵就急着从上下文里删掉。
有些工作流会把上下文切得很狠。任务刚开始时很轻快,跑到第二轮就把前面的约束丢掉,让 Agent 再猜一次项目结构。账单上的输入少了,Agent 却可能重新查已经排除的问题,或者忘掉一个接口限制。开发者看着它不停调用工具,知道它其实在绕圈。
成本至少落在三个地方。
模型调用是其中最容易看到的一项。输入、输出、推理强度和缓存,都会写在供应商账单里。
执行也会花钱。测试跑多久,浏览器开多少次,搜索、数据库、沙箱和外部 API 怎么收费,每一种都可能增加支出。
最后是人工接手。开发者读 diff,复现问题,补测试,回滚变更,再向同事解释这次为什么不能合并。这部分往往没出现在模型账单上,却经常比 token 更贵。
GPT-6.1 Sol 不会把后两项变没。它降低的是第一项,于是团队有条件把验证留得更完整一点。
多一次重跑,可能比第一次更值钱
AI 编程演示最容易跳过失败的部分。输入一句话,代码生成,测试通过,任务结束。真实项目里,第一次失败以后才开始考验流程。
一个普通的小改动,也可以走得规矩一些。Agent 在隔离分支里修改,先跑单元测试,再跑集成测试。改到界面时,打开页面走一遍关键路径。失败信息回到任务里,给它一次修正机会。第二次仍然没有把问题缩小,再交给人。
这套做法不新鲜。软件团队本来就在做,只是过去很少有人把它和模型单价放在同一张账单里。
强模型价格高的时候,团队会自然缩短循环。第一次结果看起来差不多,人工马上开始收尾。测试只跑最关键的一组。上下文一长,先清掉再说。失败日志也不敢全塞回去,怕下一轮继续烧钱。这类取舍通常由成本推着走。
OpenAI 在公告中称,GPT-6.1 Sol 在 DeepSWE v1.1 的复杂软件工程任务中,以约五分之一的成本达到 GPT-6 Astra 的表现;在 AutomationBench 的多步骤业务工作流评测里,官方报告它以中等推理强度超过 Opus 5.5 2.2 个百分点。具体项目里能跑出什么结果,仍要自己测试。不过这组价格和评测放在一起,能让团队认真考虑一件很具体的事。原来只跑一轮的任务,现在是否值得多走一遍完整的验证。
一个只改两三个文件的需求,第一次实现后先跑测试。失败了,就把错误反馈回去。第二次还不通过,人再接手。模型贵时,这个阈值会压得很低。模型成本下来后,Agent 可以多拿一次从错误里修正的机会,人也少接到一份还没走完验证的半成品。
失败预算说的就是这件事。任务开始前先定好,愿意为它留多少时间、多少调用成本、几次重跑。预算用完或者问题没有继续缩小,人就介入。
便宜不等于可以一直跑
低价模型也有一个很实际的风险。多跑几次看起来不贵,于是很容易把“再试一次”说成默认选项。
长任务不一定会自己收敛。它可能沿着错误方向继续改,测试失败后去动不相关的模块。接口没有权限,它换一条更危险的命令试。页面没有通过,它把断言删掉。每一轮都在花 token,也在扩大改动范围。
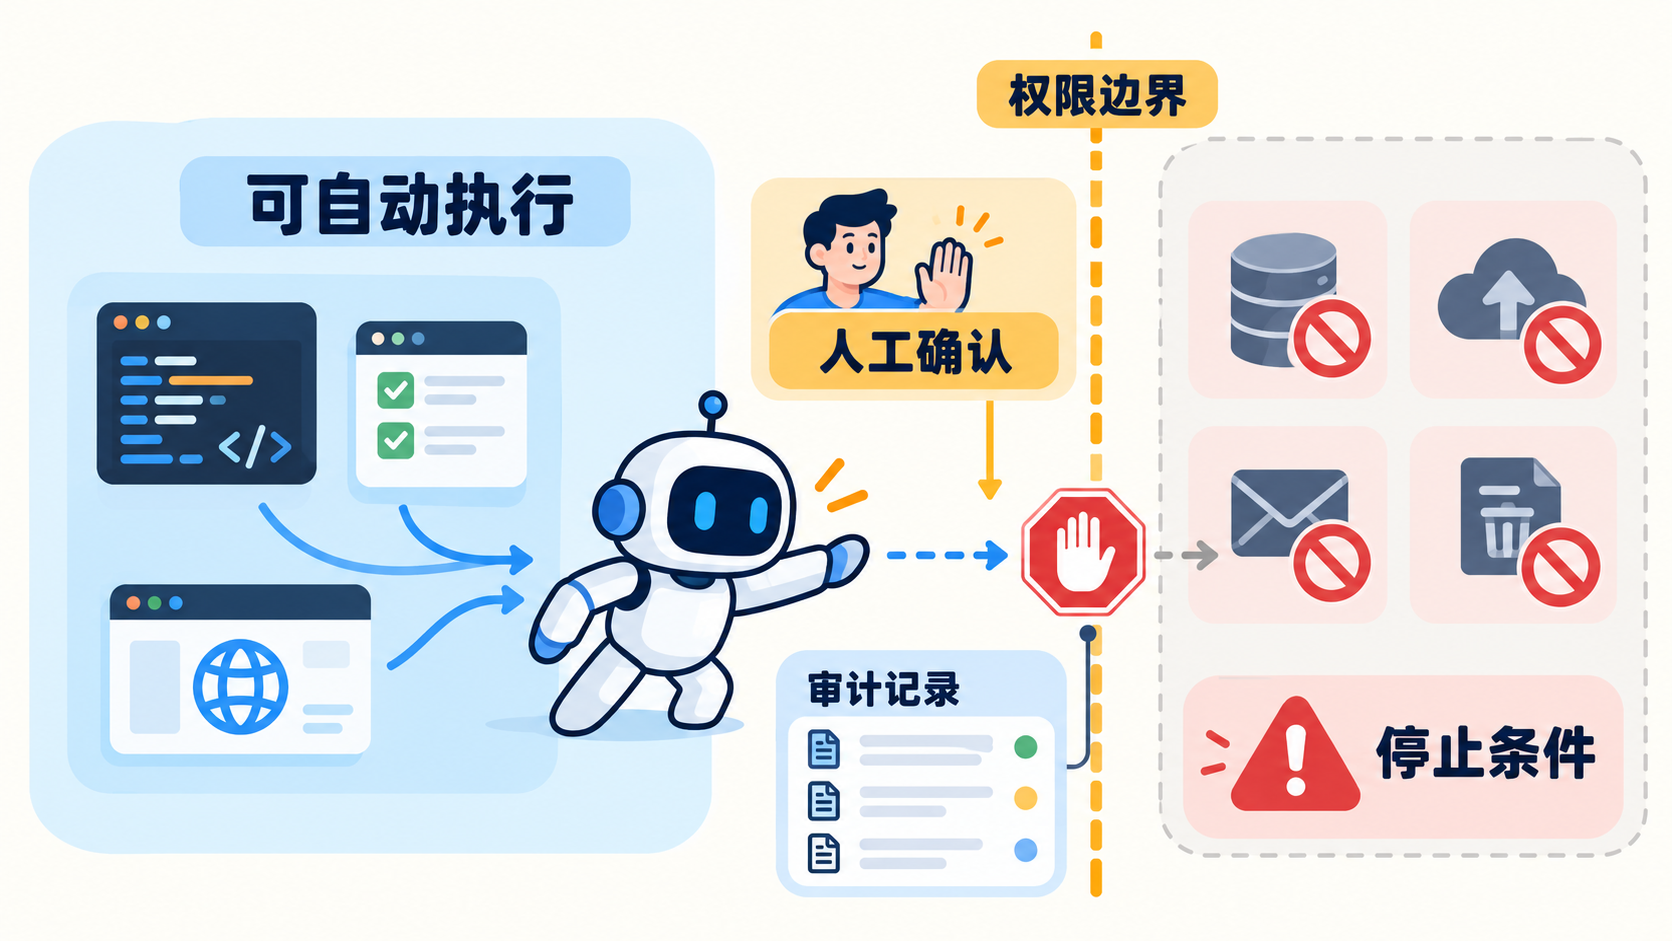
失败预算需要配停止条件。
低风险任务可以给更宽的尝试次数。补文档、改样式、生成测试样例,失败以后多试几次通常没有太大代价。改认证、迁移数据库、删除文件、发邮件和触发部署,情况完全不同。Agent 可以分析和准备,真正执行前依然要有权限边界和人工确认。
完成标准也要写得能检查。代码任务写清测试命令和验收路径。页面任务写出打开哪个地址、点哪个按钮、期待出现什么结果。数据任务要交代输入范围、输出格式和异常怎么处理。Agent 说自己完成了,只能算一条信息,不能当验收结果。
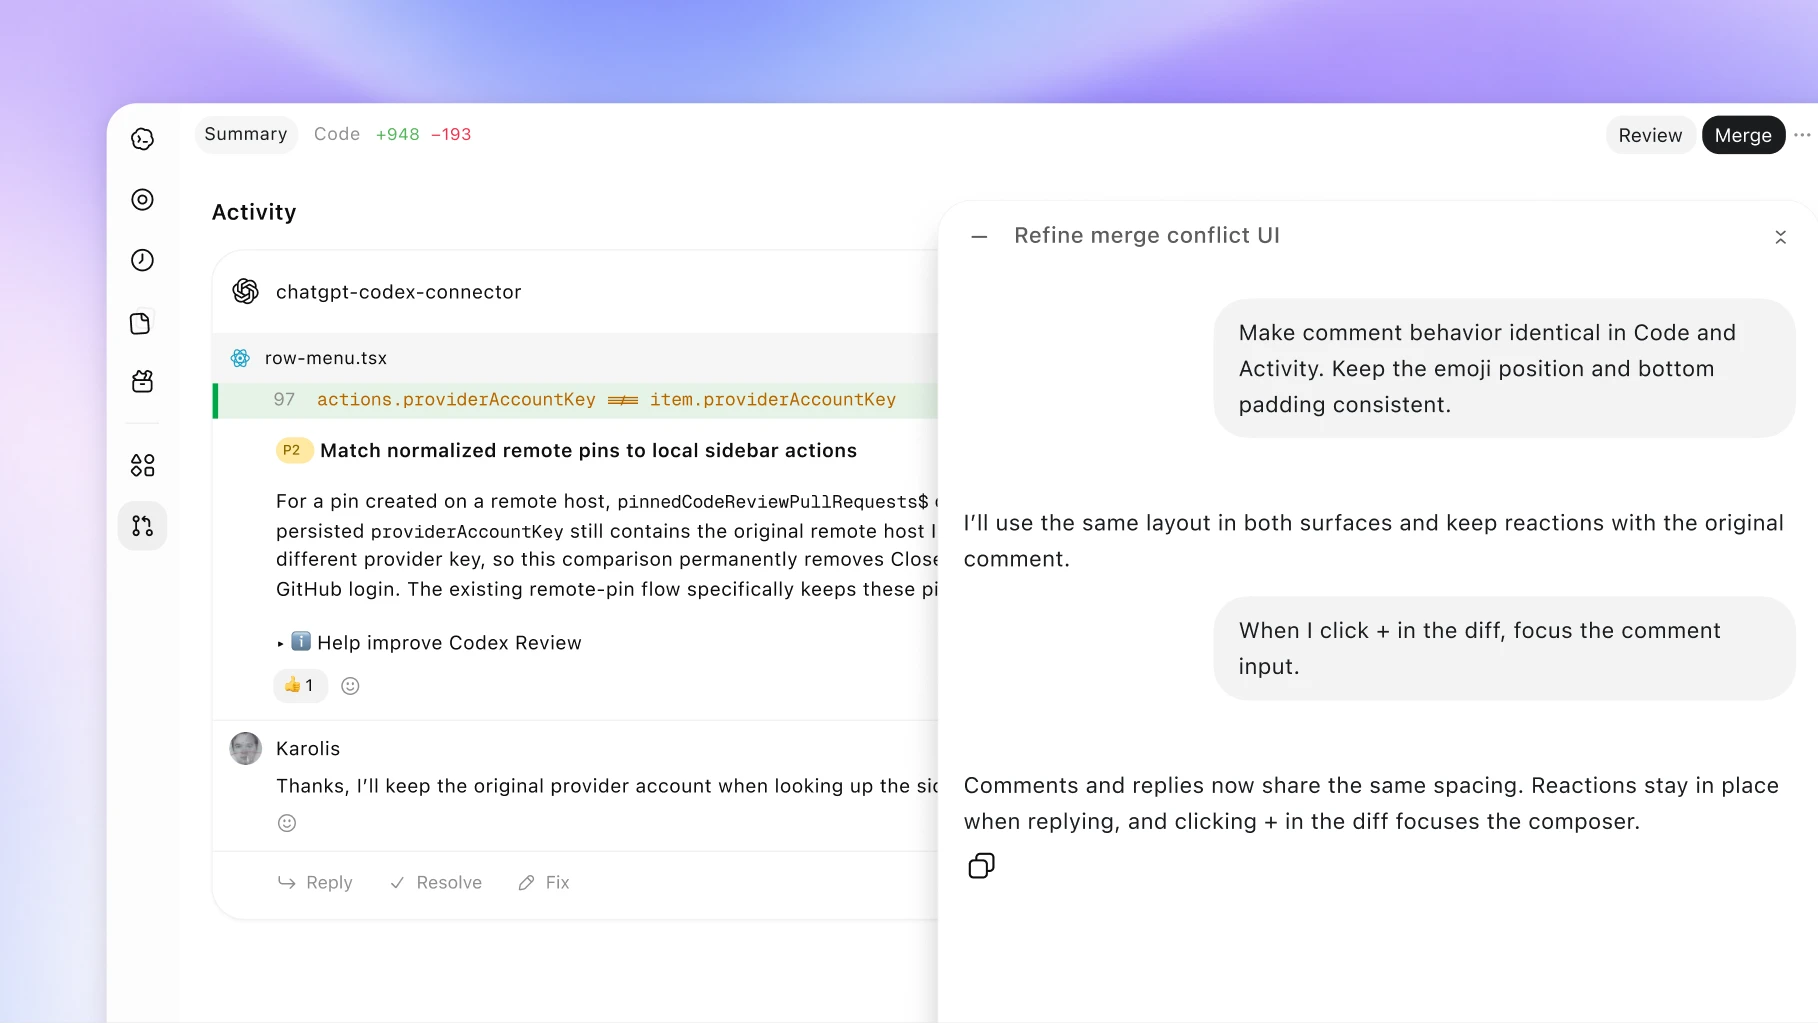
停止条件也不复杂。连续两次修复都没让失败范围变小,停下来交给人。变更文件突然变多,暂停。准备调用高权限工具,暂停。测试过了,关键路径却复现不了,也暂停。
这些限制不会浪费低价模型,反而让它的便宜有用。团队花更少的钱,多拿一些可验证的证据,而不是让错误在后台越滚越大。
缓存输入能留下什么
公告里 0.10 美元的缓存输入价格,乍看只是一个价格栏里的数字。对长任务 Agent 而言,它影响的是另一件事,哪些信息能留在任务里,不必每轮重新解释。
项目规则、编码约定、允许修改的目录、不能动的模块、测试命令、部署限制、已知缺陷和验收标准,都属于这类信息。它们不会因为任务多跑一轮就失效。保留得更完整,Agent 猜错的地方就少一些。
这不表示上下文越长越好。过期日志、已经推翻的方案和无关聊天记录照样会干扰判断。缓存价格下降以后,团队仍要整理上下文,把约束、证据和当前状态留下,把噪音拿掉。模型不会替人做这件事。
发布页上的安全分数,还不能替你把关
OpenAI 在安全部分称,GPT-6.1 Sol 在损坏搜索工具、遵守明确限制和避免未授权结果等挑战性评测里,失败率低于 GPT-6 Sol。系统卡补充材料也写得很清楚,这些任务专门用来诱发失败,不能代表日常使用中的失败率。
这个限定没有削弱公告,反而划出了它能说明的范围。模型能更可靠地承认工具失效,或者更少违反明确限制,当然有价值。部署到具体系统里,是否会越界,还得看外层流程怎么设计。
搜索工具坏了以后,Agent 能否继续下判断。它准备换数据源时是否需要确认。它想执行会影响用户的动作时,谁来审核。模型在评测里表现更好,不会自动替团队回答这些问题。
模型成本降低后,Agent 会更频繁地进入日常流程。权限、审计和回滚也会从临时护栏变成经常用到的东西。失败预算的一边,是允许机器在边界内多试几次。另一边,是边界之外让它停下来。
先拿一个小任务算账
团队要评估 GPT-6.1 Sol 或其他低价高能力模型,不妨先挑一个每周都会重复出现、又不涉及高权限动作的小任务,连续跑两周。
别急着看它写了多少行代码。先看第一次结果通过验收的比例。再看每个任务平均重跑几次,重跑以后问题是在缩小还是变大。人工接手花了多久,接手时能不能看懂 Agent 做过什么。最后把模型调用、工具执行和人工时间放进同一张表。
这些数据可能不漂亮,却会比“AI 写了多少代码”更接近团队真正得到的东西。
低价模型有时能让测试循环跑得更勤,也可能在缺少验收机制时制造更多需要人收拾的半成品。差别在工作流里。
GPT-6.1 Sol 的价格和能力组合,会让团队重新算一次账。模型调用只是其中一项。无效重跑、没有证据的完成宣言,还有人类在最后关头替机器收拾半成品的时间,同样需要算进去。
模型负责生成、推理和调用工具。失败预算规定尝试次数、每次要拿到的证据,以及何时应该交回给人。模型变便宜以后,团队能把验证做得更扎实。测试、权限和停止条件把这部分空间收住,才会得到一套可以长期用下去的工作流。
参考来源
- OpenAI 发布 GPT-6.1 Sol
- GPT-6.1 Sol system card addendum
- DeepSWE 1.1
- AutomationBench 1.0.6
- OpenAI DevDay 2026 Recap(文中 Codex CLI 与 Code Review 官方图片来源)
以上来源用于确认发布口径、定价和评测设置。模型在具体代码库和工具链里的表现,仍需按团队自己的任务与验收标准测试。