xAI 的模型能力,圈内很少有人怀疑。真正挡在它面前的,一直是另一件事:企业客户怎么签约、怎么合规、怎么把请求接进自己的系统。
9 月 28 日,AWS 宣布 Grok 4.7 正式上架 Amazon Bedrock。对个人用户来说,这只是模型列表多了一行;企业采购那边是另一回事——直连 xAI 意味着法务要评一家新供应商,安全团队要接一套新鉴权,而走 Bedrock,这些流程大部分可以直接复用。合规审查、跨区域路由、IAM 权限、内容护栏、调用日志,这层东西平时不显眼,却往往决定一个模型能不能进采购清单。
图源:AWS ML Blog:Grok 4.7 is now available on Amazon Bedrock(2026-09-28)
先看 Grok 4.7 本身带来了什么
按 xAI 9 月 21 日发布公告的说法,Grok 4.7 是其编程与知识工作方向最强的模型。xAI 给它的定位关键词是耐久:在困难任务上工作得更久,并在推进前更仔细地检查自己的输出。
图源:xAI:Introducing Grok 4.7(2026-09-21)
训练侧的变化有两个落点。一是更强的自验证,模型会在继续之前核对已有结果;二是更有效地利用 500K token 的上下文窗口。对于做 Agent 的开发者,前者尤其值得留意——长轨迹任务里,早期的错误会顺着后续每一步放大,一个会在中途自检的模型,失败方式通常没那么灾难性。
独立评测机构 Artificial Analysis 的数据也值得看一眼:
| 指标 | Grok 4.7 | Grok 4.6 |
|---|---|---|
| Intelligence Index | 46 | 44 |
| Coding Agent Index | 56 | 47 |
| AA-Briefcase 长程知识工作(Elo) | 1,657 | 1,546 |
| AA-Omniscience 幻觉率 | 29% | 34% |
| 每任务输出 token | 约 81k | 约 38k |
进步是真实的,编码 Agent 和长程任务提升最明显。但最后一行要看仔细:每任务输出 token 翻了一倍多。这些数字是在 xhigh 推理强度下测得的,模型想得更深,账单也更长。把默认档位原样搬进生产,成本可能先给你一个惊喜。
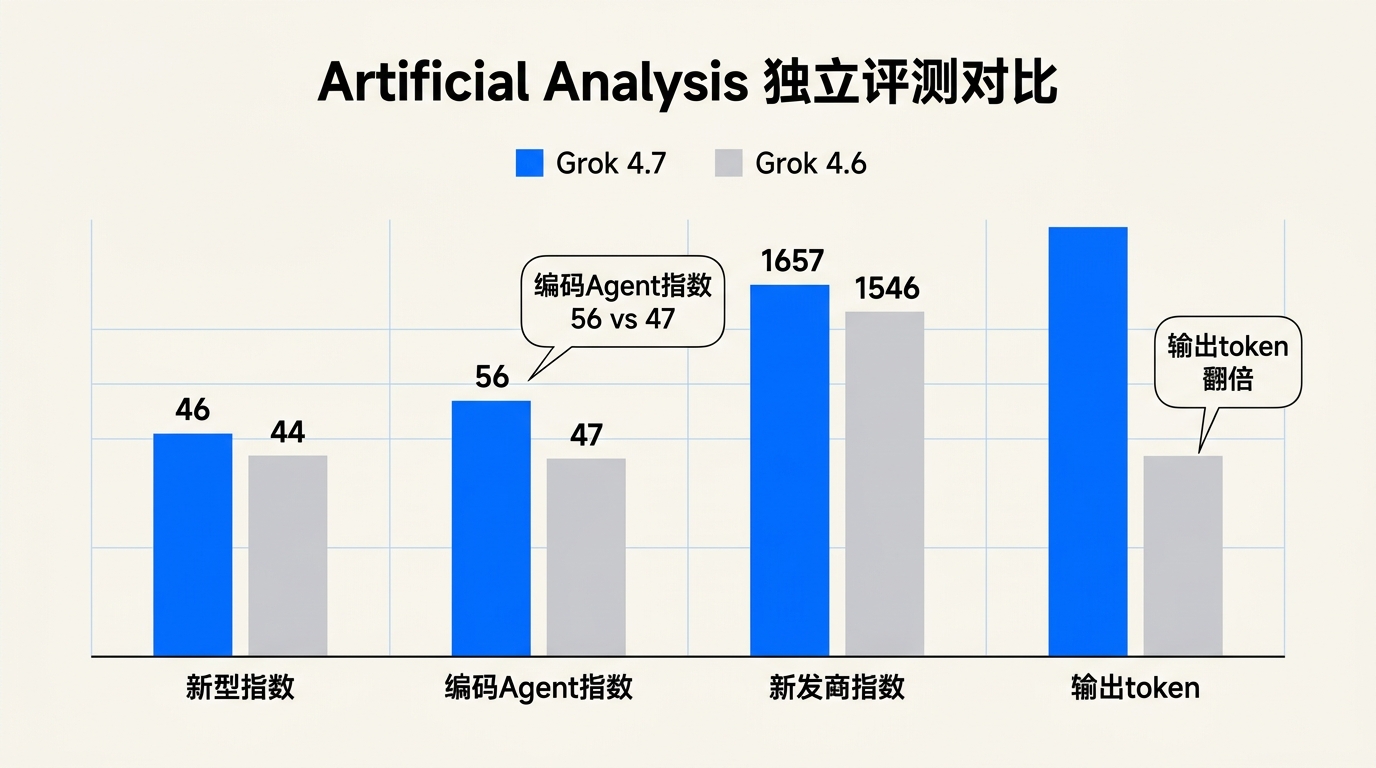
图源:本文按 Artificial Analysis 公开数据整理(评测链接见文末)
在 Bedrock 上,它长什么样
Bedrock 上的 Grok 4.7 有几个接入层面的细节,比模型本身的跑分更影响日常使用。
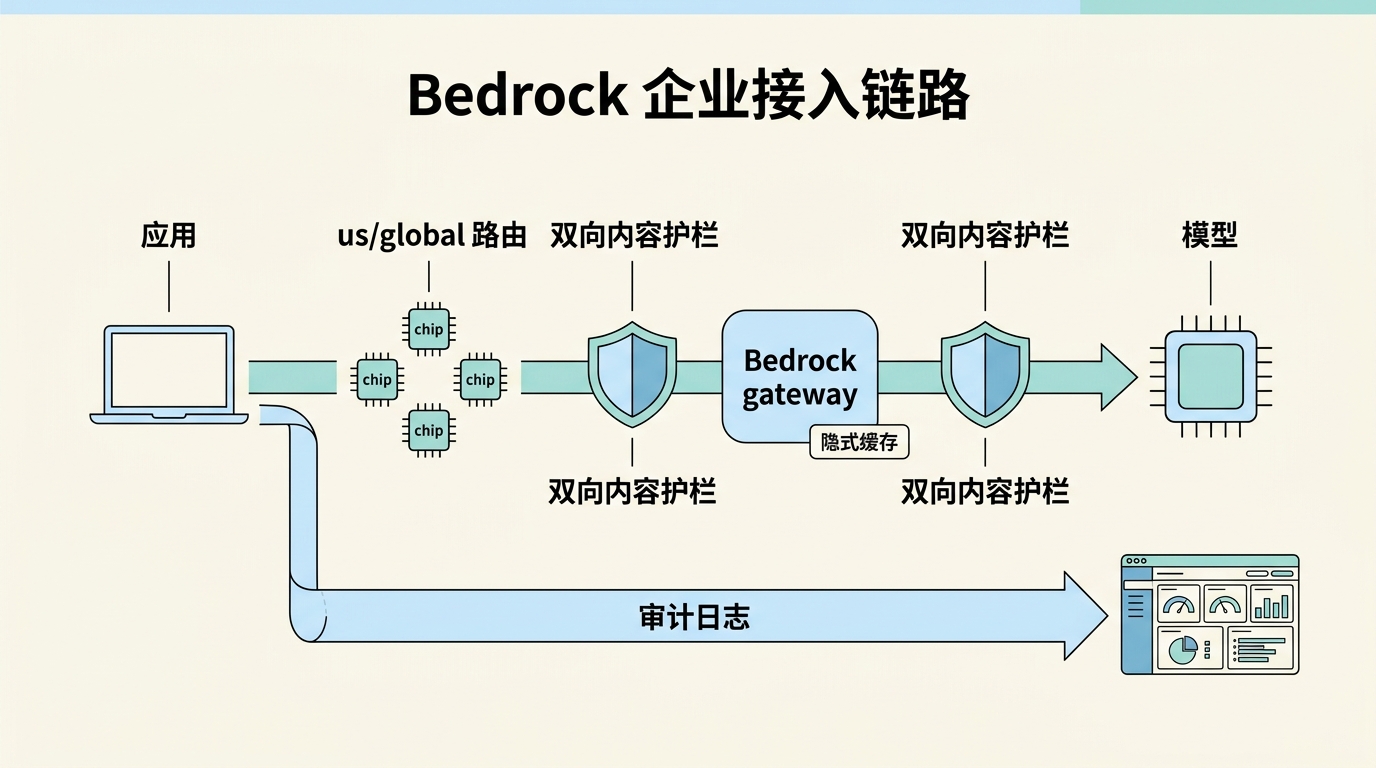
图源:本文按 AWS 官方博客与 Bedrock 文档整理
请求不直接指向模型 ID,而是走跨区域 inference profile:us.xai.grok-4.7 把处理留在美国地理区域内,满足数据驻留要求;global.xai.grok-4.7 在全球商用区之间调度,价格更低、吞吐更好,代价是延迟波动和对请求落地的控制变弱。驻留合规选前者,成本敏感选后者,这个取舍 AWS 没有替你做。
API 形态上有三条路。模型是 OpenAI 兼容的,现有集成用 OpenAI SDK 指向 /openai/v1 路径就能迁移,bearer token 可以是 Bedrock API key,也可以用 IAM 凭证换取的短期 token;想要全账户统一的消息格式、调用日志和标准事件流,就走 AWS SDK 的 Converse API。还有一个小坑值得提前知道:推理始终开启,Converse 返回的第一个 content block 是推理过程,正文在后面的块里,遍历查找比按下标取值可靠。
回到开头说的分发问题,这些企业功能才是这次上架的分量所在。隐式 prompt caching 对重复的 system prompt 前缀自动生效,Agent 每轮重发大上下文的场景直接受益;Bedrock Guardrails 按 ID 挂载,内容过滤、敏感信息脱敏对请求和响应双向生效,对可能无人值守跑很多步的模型,这层保险不是摆设;结构化输出能约束成 JSON Schema;调用日志连推理 token 计数一起写进 CloudWatch,长 Agent 任务终于有完整的审计轨迹。
计费档位也是成本杠杆:Standard 按量付费,Priority 花钱买优先处理,Flex 用低价换时间容忍度。批处理和离线任务走 Flex,交互业务走 Standard,这是以前直连 xAI API 时没有的调度空间。
十分钟跑通第一句
探索阶段在 Bedrock 控制台生成一个长期 API key,配好环境:
|
|
然后就是熟悉的 Chat Completions:
|
|
生产环境建议放弃长期 key,改用 IAM 凭证换取的短期 bearer token,探索用的 key 用完就从控制台删掉。AWS 官方博客对这一点的措辞相当直白。
对多模型选型意味着什么
Bedrock 的模型目录里,现在同时躺着 Anthropic 的 Claude、xAI 的 Grok、Amazon 的 Nova,外加一批开源模型。这对国内开发者有个很实际的影响:过去「换一家模型供应商」往往意味着换一套鉴权、一套 SDK、一套限流逻辑,现在很多切换只是在代码里改一个 profile 字符串。
选型的时候,真正拉开差距的已经不太是榜单名次,而是几个配置决策:推理强度开到哪一档,请求走 us 还是 global profile,批处理要不要用 Flex 计费。同样的模型,这几项配法不同,成本和延迟能差出数倍。Artificial Analysis 那张表里输出 token 翻倍的事实也提醒我们,跑分领先和账单友好经常顾不全。
Grok 4.7 的强项在长程任务和编码 Agent,自验证行为适合无人值守的工作流;如果你的负载是高频短交互,它的输出 token 消耗就需要用 low/medium 档位去压。没有普适答案。好在这个验证现在便宜了:改一个模型 ID,拿自己的真实负载跑一遍,比读十篇评测都有用。
至于模型强弱之争,短期内不会有终局。但对采购的人来说,顺序其实是反的:先看买不买得到、接不接得进、审不审得过,再谈谁更强。Grok 4.7 进 Bedrock,补上的就是前一半。
参考来源
- AWS ML Blog:Grok 4.7 is now available on Amazon Bedrock
- xAI:Introducing Grok 4.7
- Artificial Analysis:Benchmarking Grok 4.7
- unite.ai:AWS Adds xAI’s Grok 4.7 to Amazon Bedrock
以上来源中,模型能力与安全表述来自 xAI 官方口径,独立评测数据来自 Artificial Analysis,接入细节以 AWS 官方博客为准。价格与区域可用性请以 Amazon Bedrock 定价页和你的账户实测为准。