本文基于新智元报道(36氪授权转载)与 VISTA 论文的公开信息写成。文中成绩数字均来自论文与 ARC Prize 官方平台的转述,我未独立复现实验;arXiv 原文链接见文末参考来源。十一期间挂上 arXiv 的这篇论文在 X 上已经吵翻了,中文讨论大多还停在转述成绩,这篇试着把它的设计拆开看。
先说结论:过去半年,全世界最顶尖的那批大模型,很可能是被「蒙着眼睛」赶上 AGI 考场的。
同一个 Claude Opus 5,在 ARC-AGI-3 的官方标准测试里只拿了 40 分。何恺明团队(MIT)的 VISTA 系统没有训练任何新模型,没有给模型灌输任何游戏知识,只是帮它摘掉了眼罩,让它亲眼看游戏画面,再递给它一本能随时往回翻的「相册」。
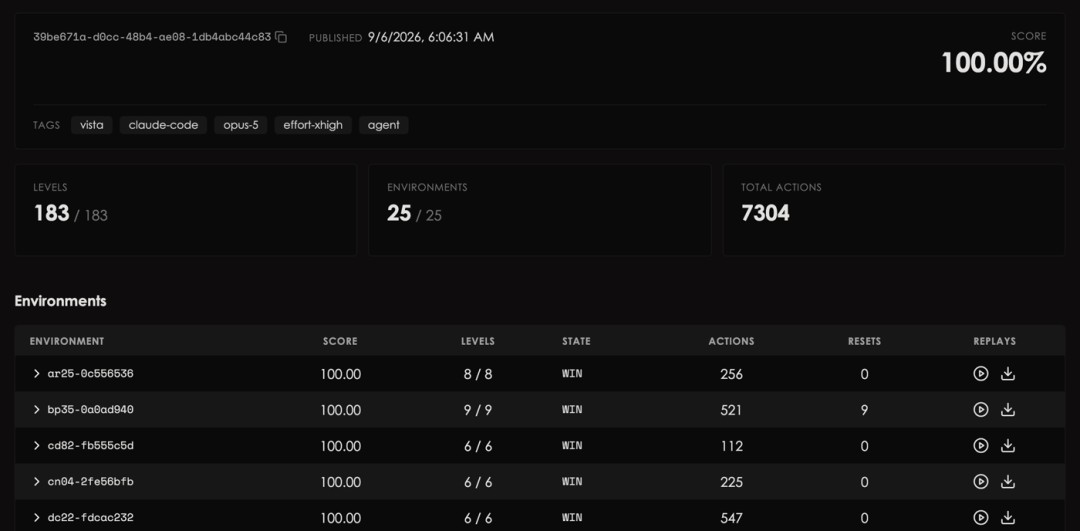
结果,论文显示 Claude 直接打通了 ARC-AGI-3 全部 25 个公开游戏、183 个关卡,每个游戏都是 100 分。GPT-5.6 Sol 拿到 99 分。一个在官方实现下几乎交白卷(1.89 分)的 320B 开源模型,套上 VISTA 后被抬到 66.93 分。
更扎心的是步数:Claude 总共走了 7302 步,只有人类首次通关步数的 0.43 倍。有个叫 m0r0 的游戏,人类平均要走 1107 步,它只用了 219 步。这些成绩在 ARC Prize 官方平台上都有记分卡,不是论文里的自说自话。
一张数字表,坑了大模型半年
要理解这事,得先看 ARC-AGI-3 是什么考场。
它是 Keras 之父 François Chollet 和 ARC Prize 基金会今年 3 月放出的 AGI 测试(ARC-AGI,抽象与推理基准的第三代),内容是一堆交互式像素小游戏:开局没有任何说明,没有规则介绍,全靠玩家自己试错摸索。计分方式也苛刻,官方找来近 500 名人类玩家实测,AI 不光要通关,步数还不能比人类多,才能拿满分。
问题出在递考卷的方式上。官方给大模型的,不是游戏画面,而是一张 64×64 的数字表。人类看到的小人、机关、行进路线,到了模型那里只剩 4096 个数字。
这相当于让人闭着眼睛,听别人报坐标去玩《超级马里奥》。
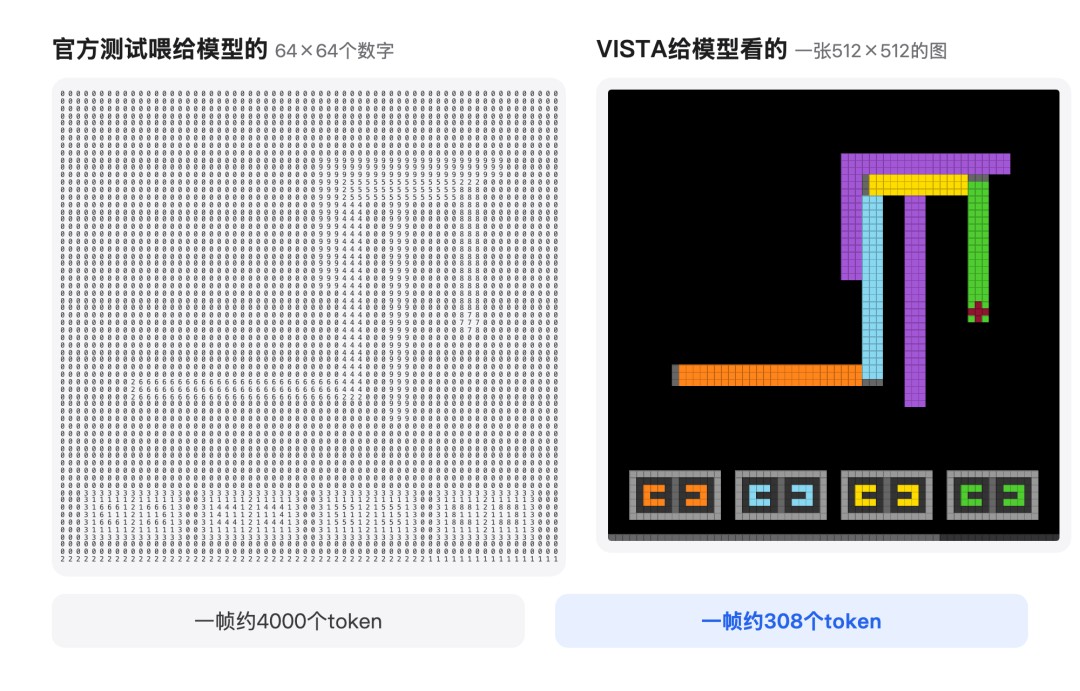
VISTA 做的第一件事朴素到不像论文:把数字表换回图片。别的什么都不改,GPT-5.6 Sol 的分数就从 13.33 跳到了 47.32。光是把「眼睛」还给模型,就捡回了 34 分。
更意外的是,看图反而更省算力。按论文的数据,一个数字格子要吃掉约 4000 个 token(词元,大模型计费和计量的最小文本单位),而一张 512×512 的图片只要 308 个。一局跑下来,文本版烧掉 7190 万 token,图片版只要 3070 万,分数还更高。我们习惯了「图像比文本贵」,在 ARC-AGI-3 这个场景里,账是反着算的。
相册:让 AI 过目不忘
光能看见还不够。
一局游戏动辄几百步,多模态模型的老毛病是:图片看一遍,上下文一满就删掉,或者压缩成几句文字摘要。等模型想回头核对某个细节时,那一帧早就没了。人类玩家会怎么干?回头看一眼回放。
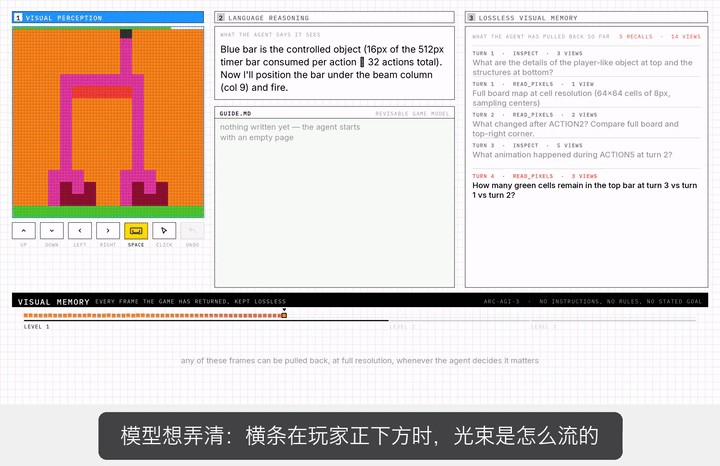
VISTA 的核心部件就是这本「无损视觉记忆相册」。游戏吐出的每一帧画面(连动画帧在内)都按编号原样存档,模型想看哪一帧,随时调用 inspect 翻出来,几帧并排对比、放大角落都行,还能用 read_pixels 读出精确颜色。关键是:翻相册不计入步数,只有真正在游戏里操作才算。
团队给这套机制起了个名字,叫「显式注意力」:翻哪一帧、看哪一块,模型自己说了算。
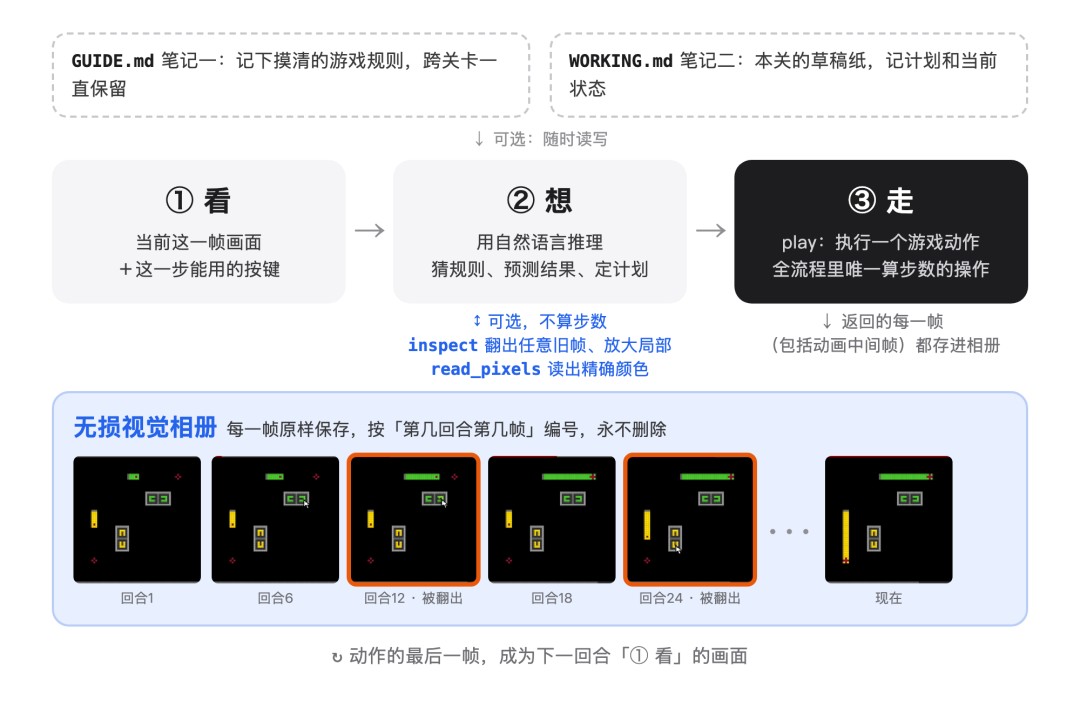
它还随身带两个笔记本:GUIDE.md 记游戏规则,WORKING.md 当草稿纸。看到这里你可能已经笑了,这不就是 CLAUDE.md 和 scratchpad 吗?没错,给游戏 Agent 用的,和给编程 Agent 用的,是同一套东西。
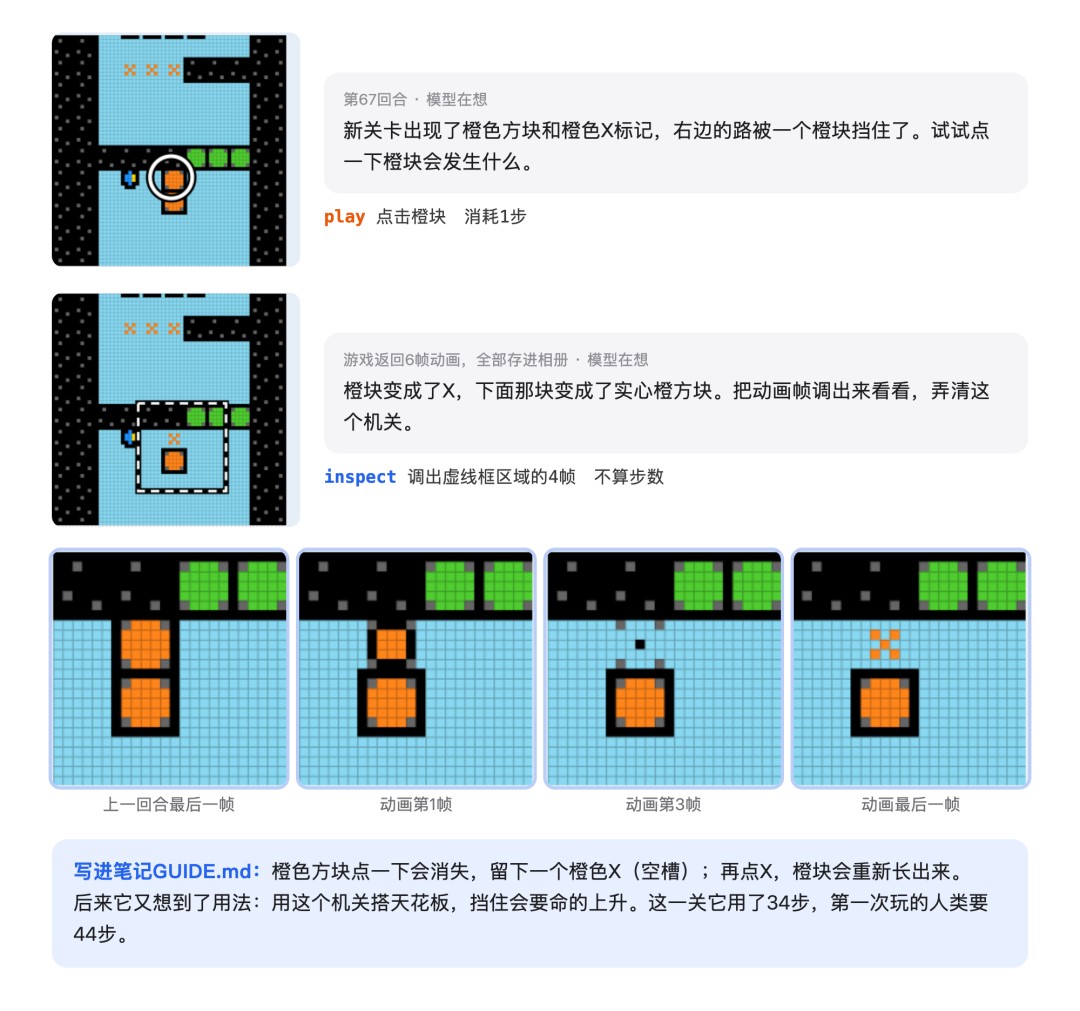
论文里记录了一个特别「像人」的瞬间。在 BP35 游戏第 3 关,画面里出现一个橙色方块,模型点了一下,橙块变成了 X。它先停下来,把上一回合的最后一帧和刚才的三帧动画调出来并排回放,看明白了才继续。几回合后它又发现点 X 能让橙块重新长出来,当场在笔记里写:「这就是我要的工具,用它搭天花板,挡住会要命的上升。」这一关,第一次玩的人类要走 44 步,它走了 34 步。
到了《吃豆人》里更绝:迷宫里的豆子吃一颗少一颗,地图会变。模型的办法是第 13 回合和第 36 回合两次强行翻回开局第一帧,重新记一遍迷宫。
反直觉:多给上下文,分数反而跌
给模型塞更大的上下文、更清晰的图片,是大多数人的第一反应。论文专门测了,两招都不灵。
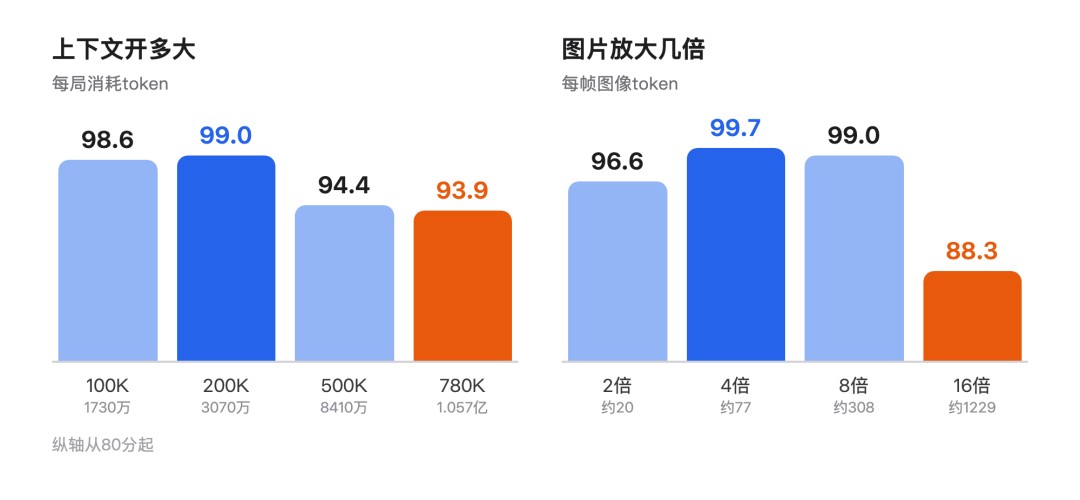
上下文窗口从默认的 200K 开到 780K,每局 token 从 3070 万涨到 1.057 亿,成绩却从 99 分退到 93.9。图片分辨率也一样:放大到 16 倍,每帧 token 涨到 1229 个,成绩只剩 88.3;只放大 4 倍反而拿 99.7,比默认的 8 倍还高。论文的解释是,图片太大,多出来的 token 白白挤占上下文,模型并没有因此看得更清楚。
多给不一定更好,VISTA 整套设计都压在这个判断上。系统里没有一个新训练的模型,每个游戏的提示词都是同一份,一共四句话,没有一个字教它具体怎么玩。
这个夏天刷榜 ARC-AGI-3 的高分方案,比如 Tycho 和 Schema,走的是另一条路:让大模型给每个游戏写一套能运行的程序,硬造一个世界模拟器来反复试错。光跳棋游戏 LF52 一个,Schema 就写了 4000 行 Python。而 VISTA 里的模型,用自然语言在笔记本上写了三句话,就搞定了同一条规则。
按论文的说法,VISTA 是第一个不靠写程序就在 ARC-AGI-3 上满分或接近满分的系统。
这一点放到游戏之外才真正要紧。真实世界里没有人会提前给你写好一套 4000 行的模拟器。代码派能赢考场,VISTA 的路线才能出门。
一年三篇,死磕一个判断
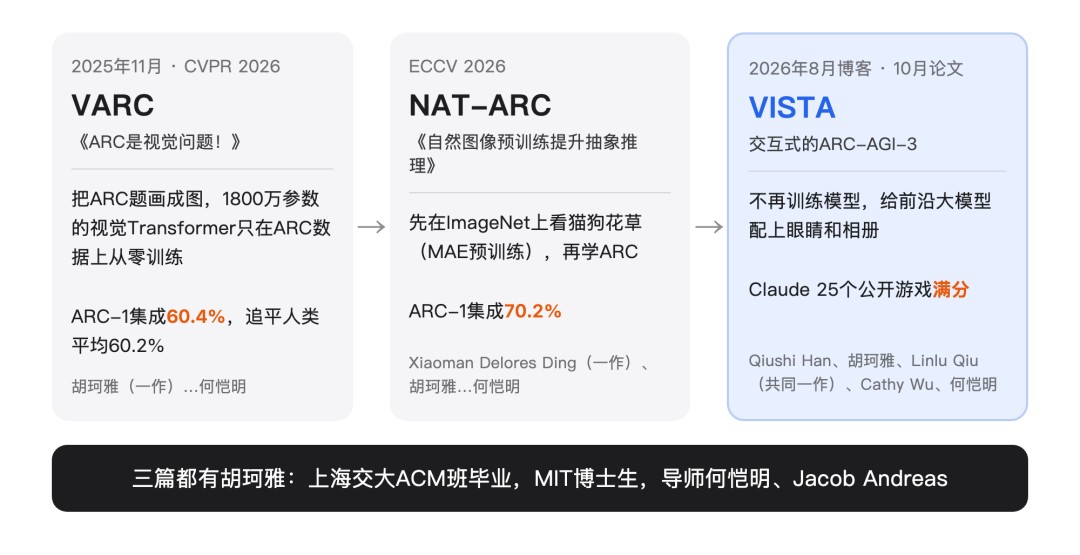
把时间线拉长看更有意思。ARC 测试的主流解法一直被文本推理垄断,但何恺明团队一年连发三篇论文,押的都是同一个判断:ARC 是视觉问题。
第一篇 VARC,用 1800 万参数的小号视觉模型从零训练,纯看图就追平了人类平均分,证明这个基准不需要语言也能做。第二篇 NAT-ARC,让模型先在 ImageNet 上看猫看狗「补课」,抽象推理能力跟着变强,证明视觉先验直接喂养推理。第三篇就是 VISTA,干脆连小模型都不训练了,直接给前沿大模型配外设。
三篇论文的路线一级级递进:先证明视觉够用,再证明视觉有益,最后证明只补视觉就够。串起三篇的是何恺明的博士生胡珂雅(上海交大 ACM 班本科),三篇里两篇一作、一篇二作;VISTA 的共同一作还有 MIT 博士生 Qiushi Han 和 Linlu Qiu,副教授 Cathy Wu 也在作者之列。
顺带说一句泛化性。这套 0 训练的机械流程塞进带透视的 3D 画面,照样拿 84.12 分;套上 GPT-5.6 Sol 去打 34 个网页游戏(包含马里奥、2048、我的世界),任务成功率 63.3%,压过人类小白的 55.3%;连静态看图题都受益,BabyVision 的一道连线题,不用 VISTA 时模型把驼鹿和兔子连反了,用上它放大一看,就答对了。
真正值得琢磨的:瓶颈到底在哪
100 分本身其实没那么重要。我更看重的是,这篇论文把一个平时藏在水面下的问题翻了出来:智能的瓶颈,到底在参数里,还是在参数外面?
过去几年,行业的默认动作是把模型做大、把推理链拉长,进步几乎全部押在模型本身。VISTA 给出的反例是:同一个 Claude,成绩从 40 分到满分,动的全是模型外面的东西,一个感知接口(数字表换图片)、一套记忆机制(相册)、两页笔记。模型一个参数都没动。
ARC Prize 联合创始人 Mike Knoop 的判断也是同一个方向:越来越多的「学习」会发生在模型权重之外。
这不是孤例。本周 Hacker News 上还有一篇热帖,标题就叫「Agent 不需要记忆,需要文档」,作者把整个记忆插件生态批了一遍,主张给 Agent 建结构化的文档工作区;BestBlogs 的每日精选里,Recursive Language Models(递归语言模型)也在重新思考上下文该装什么。学术圈打基准、工程圈调架构,两拨人最近指向了同一个词:模型外面的那层。
所以「打穿 AGI 考试」这个说法,值得咂摸一下。被 VISTA 打穿的与其说是 ARC-AGI-3 这张考卷,不如说是考卷和感知接口之间的耦合:一张数字表成了模型的全部世界,榜单测出来的其实是「读表能力」,推理能力反倒没测到。摘掉眼罩之后,模型的真实水平才暴露出来,原来早就够了。
当然,冷静一点说,这里面也有可以追问的地方。ARC-AGI-3 被视觉路线打穿之后,ARC Prize 大概率会推出更依赖抽象推理的下一代基准,就像 ARC-AGI-2 当年接管 ARC-AGI-1 一样。「满分」永远是针对某张考卷的满分。另外,游戏画面的信息密度和真实世界不在一个量级,何恺明团队自己说,下一站是充满真实画面的具身环境(embodied AI,让 AI 在物理或仿真世界中感知行动),那里没有人会提前把世界翻译成一张数字表,也没有人帮你把规则写进 GUIDE.md。
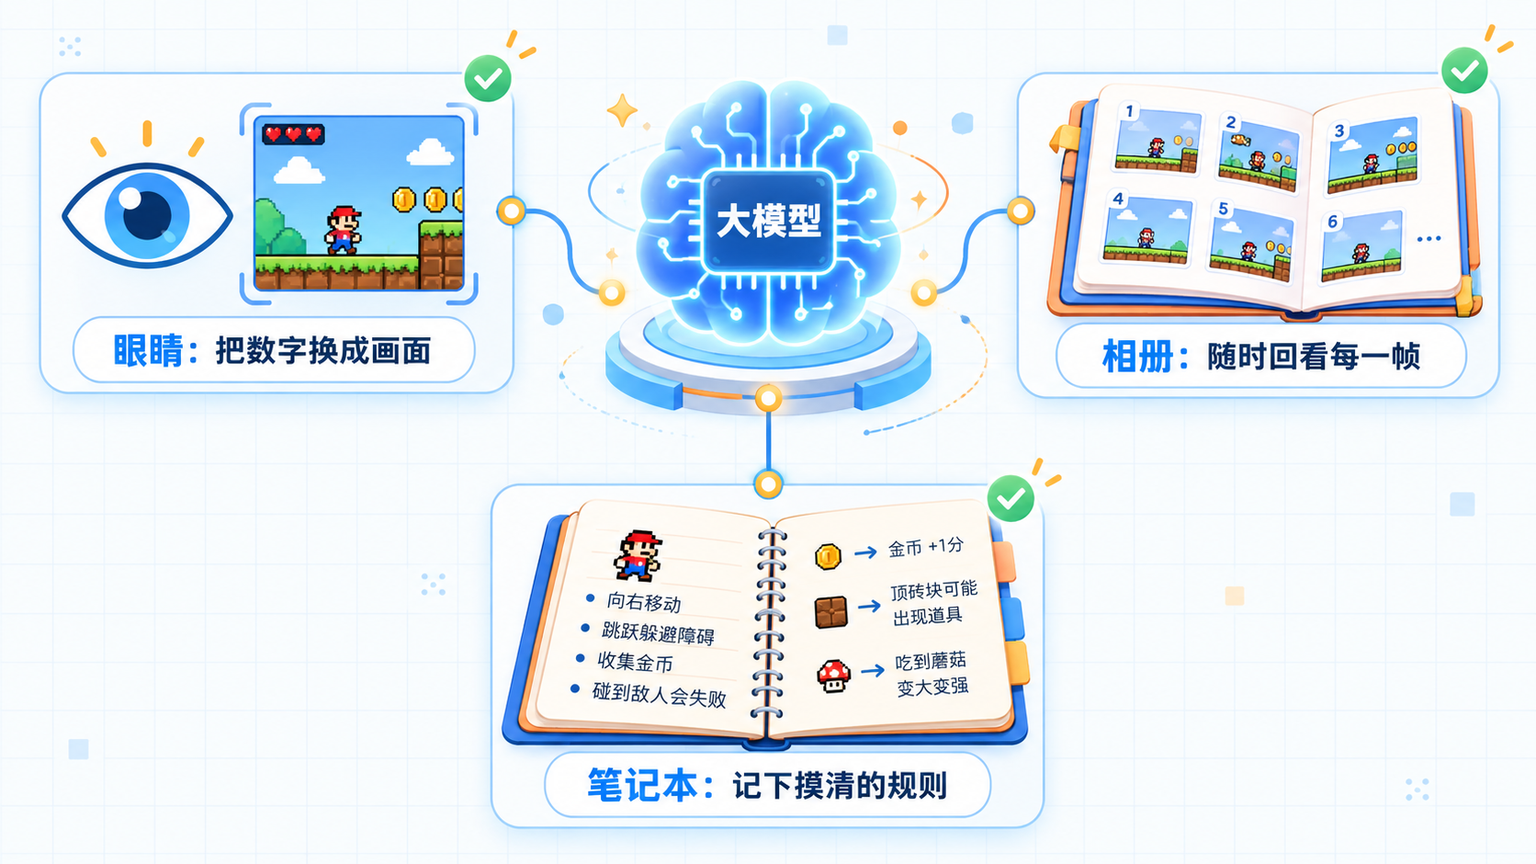
但对做应用的人来说,这篇论文有一个马上能带走的启发:Agent 表现不行的时候,先别急着换更大的模型。看看它「看见」了什么,喂进去的数据是不是被某个中间格式压扁了;再看看它能不能回看,原始材料还在手里,还是只剩下几句摘要;最后翻翻它的笔记本,规则到底写下来了没有。多数被归咎于「模型不行」的问题,往下查两层,常常会变成「输入不行」。
很多时候,脑子早就够用了,卡住它的是眼睛和记性。
参考来源
- Claude满分、GPT 99分,何恺明团队把AGI考试打穿了(新智元,36氪授权转载)
- ARC-AGI 官方基准与记分卡(ARC Prize)
- Readhub 事件聚合:何恺明团队新系统让 Claude 在 AGI 测试拿满分
- Mark Kretschmann 的推文(对 VISTA 的社区讨论)
- Agents Don’t Need Memory. They Need Documentation.(liao.gg,范式呼应)
可信度边界:本文成绩数字转述自新智元对论文的报道与 ARC Prize 平台记分卡,未经独立复现;「近 500 名人类玩家」「4000 token/格」等细节以论文原文为准,VISTA 的 arXiv 编号待查原文后补入。正文截图与动图转载自新智元报道(36氪授权发布),版权归原作者所有,仅作评述引用。