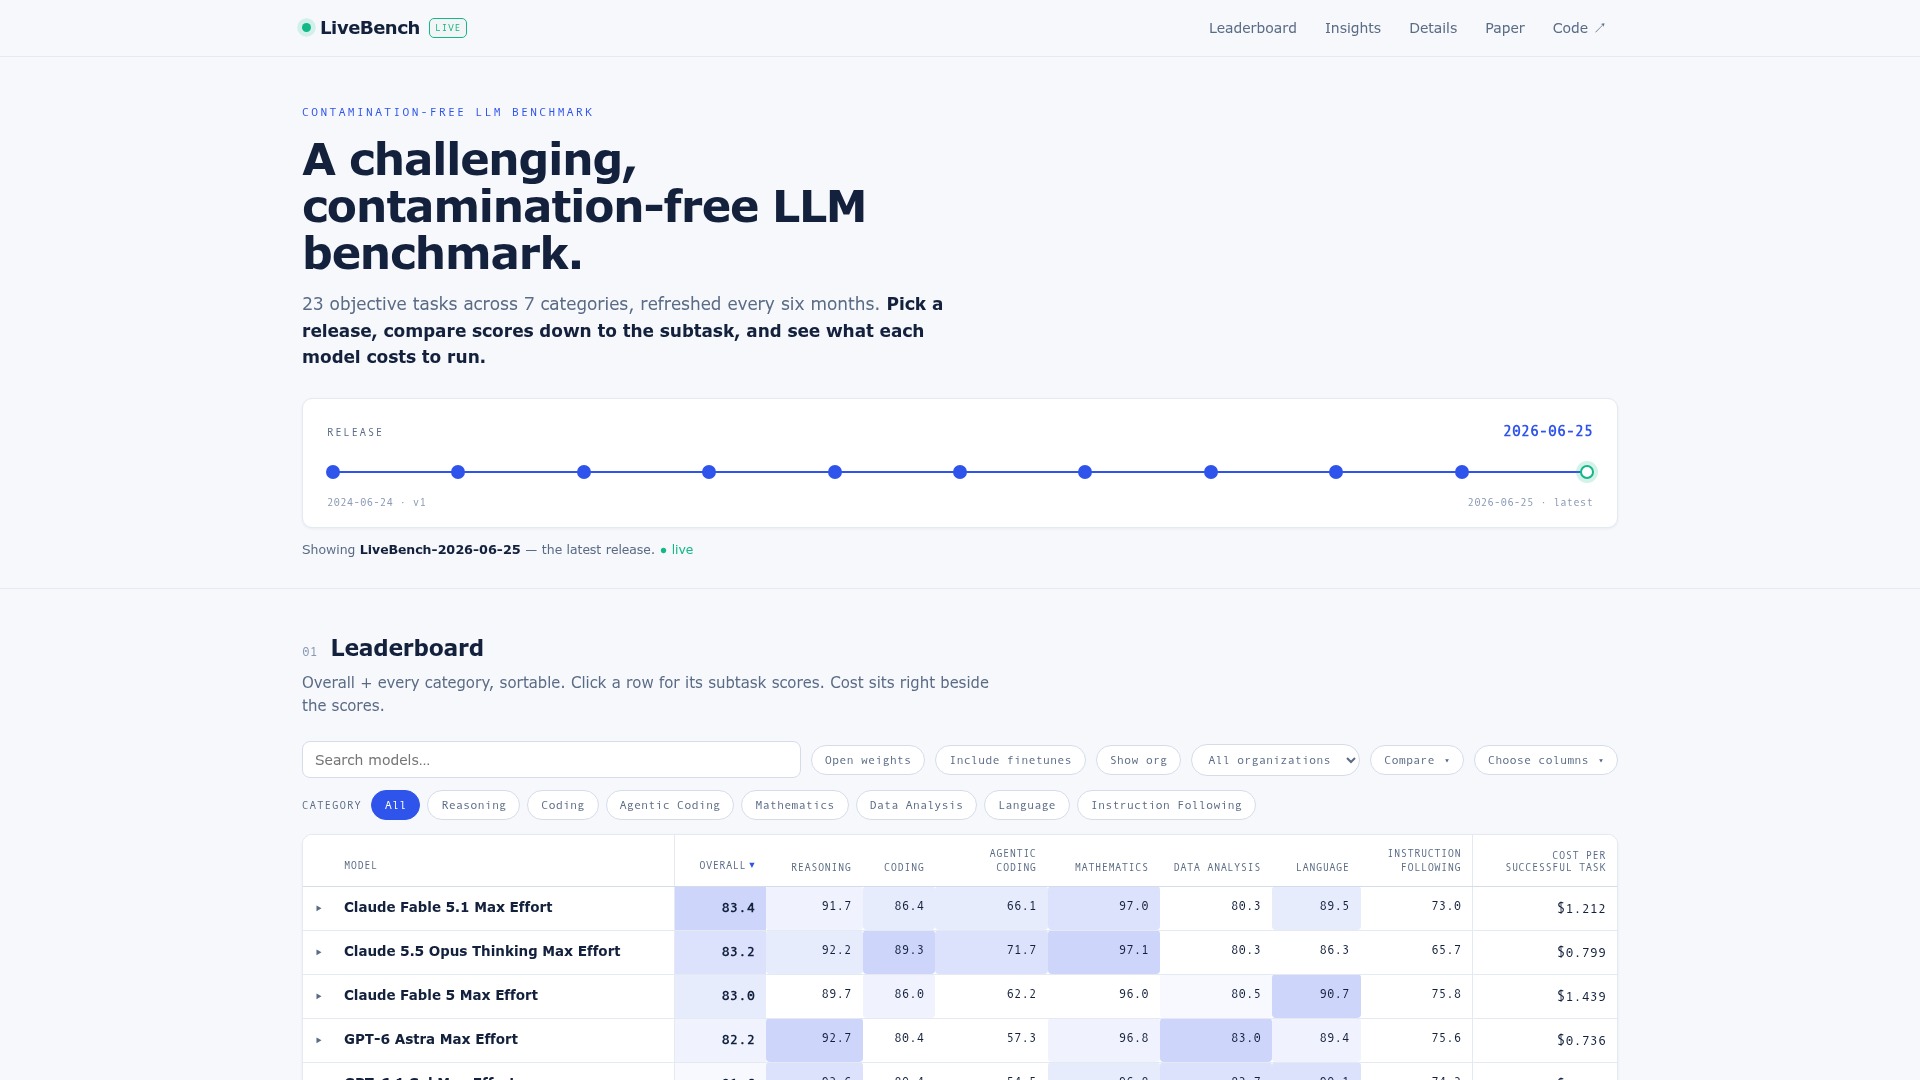
本文基于凤凰网科技对彭博行业研究报告的转述写成(彭博原报告在付费墙内,我没拿到)。文中 LiveBench 榜单数据(分数、排名、Agentic Coding 分项、每成功任务成本)由我在 livebench.ai 官网于 2026-10-05 抓取核对;榜单持续变动,不同时点快照排名可能不同——凤凰网转述的「全球第六」对应彭博报告引用的更早快照,我核到的是第 7。转述口径与原文如有出入,以彭博原报告为准。
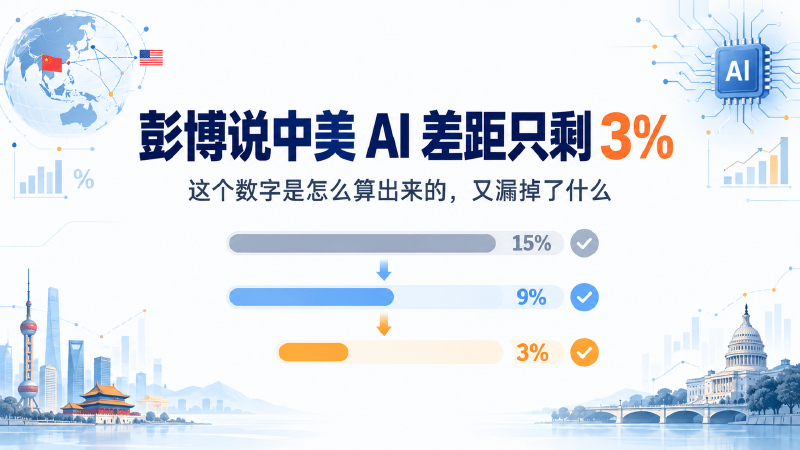
10 月 5 日周一,彭博行业研究(Bloomberg Intelligence,彭博社旗下研究部门)高级分析师 Robert Lea 发布了一份注定被反复引用的报告。据凤凰网科技转述,其核心结论一句话就能说完:DeepSeek 9 月发布 V4.1 Flash 之后,中国顶尖模型在基准测试得分上仅落后美国竞争对手 3%。
真正扎眼的是缩小的速度。Lea 给出的轨迹是:今年年初差距约 15%,5 月份收窄到 9%,现在 3%。九个月,差距缩到原来的五分之一。
具体到分数:DeepSeek V4.1 Flash 在 LiveBench(一个持续更新的大模型能力评测基准,用问答和任务表现给模型打分,思路类似测人类智商)上拿到 81.1 分;榜上最高的 Anthropic 模型是 Claude Fable 5.1,83.4 分。83.4 对 81.1,分差 2.3 分,占 83.4 的 2.8%,四舍五入就是那条新闻标题里的「3%」。Lea 的原话是,DeepSeek 的表现已经「可以与 Anthropic、OpenAI 的领先 AI 系统相媲美」。
这是自 2025 年 DeepSeek 靠推理模型 R1 一战成名以来,中国模型拿到的最高榜单位置。
数字都是真的。但我把这份报告翻来覆去读了几遍,觉得比「3%」本身更值得写的,是这个数字没说出口的另外几件事。
3% 是怎么算出来的
先看口径。3% 不是「中美所有模型平均差 3%」,而是两家旗舰在单一基准上的分差:DeepSeek 最强的 V4.1 Flash,对 Anthropic 最强的模型,在 LiveBench 一个榜单上,差了 2.3 分。
这个口径有几层要掰开看。
最明显的一层:LiveBench 测的是「答题能力」,推理、数学、coding(编程)问答这类可以标准化评分的任务。它不测 Agent(智能体)能力,不测长程任务执行,不测产品化程度。一个模型在 LiveBench 上逼近对手,和在真实工作流里逼近对手,是两回事。
再看旗舰对比这个口径本身,它天然放大追赶速度。头部实验室的旗舰互相咬得很紧是全球现象,OpenAI、Google、Anthropic 自己也常常只差一两分。旗舰分差 3%,说明第一梯队入口摸到了,离「梯队整体追平」还有距离。
还有半句,是凤凰网那篇转述里最容易被滑过去、但我读着最扎心的:LiveBench 评选的前 15 个模型中,只有 3 个来自中国。
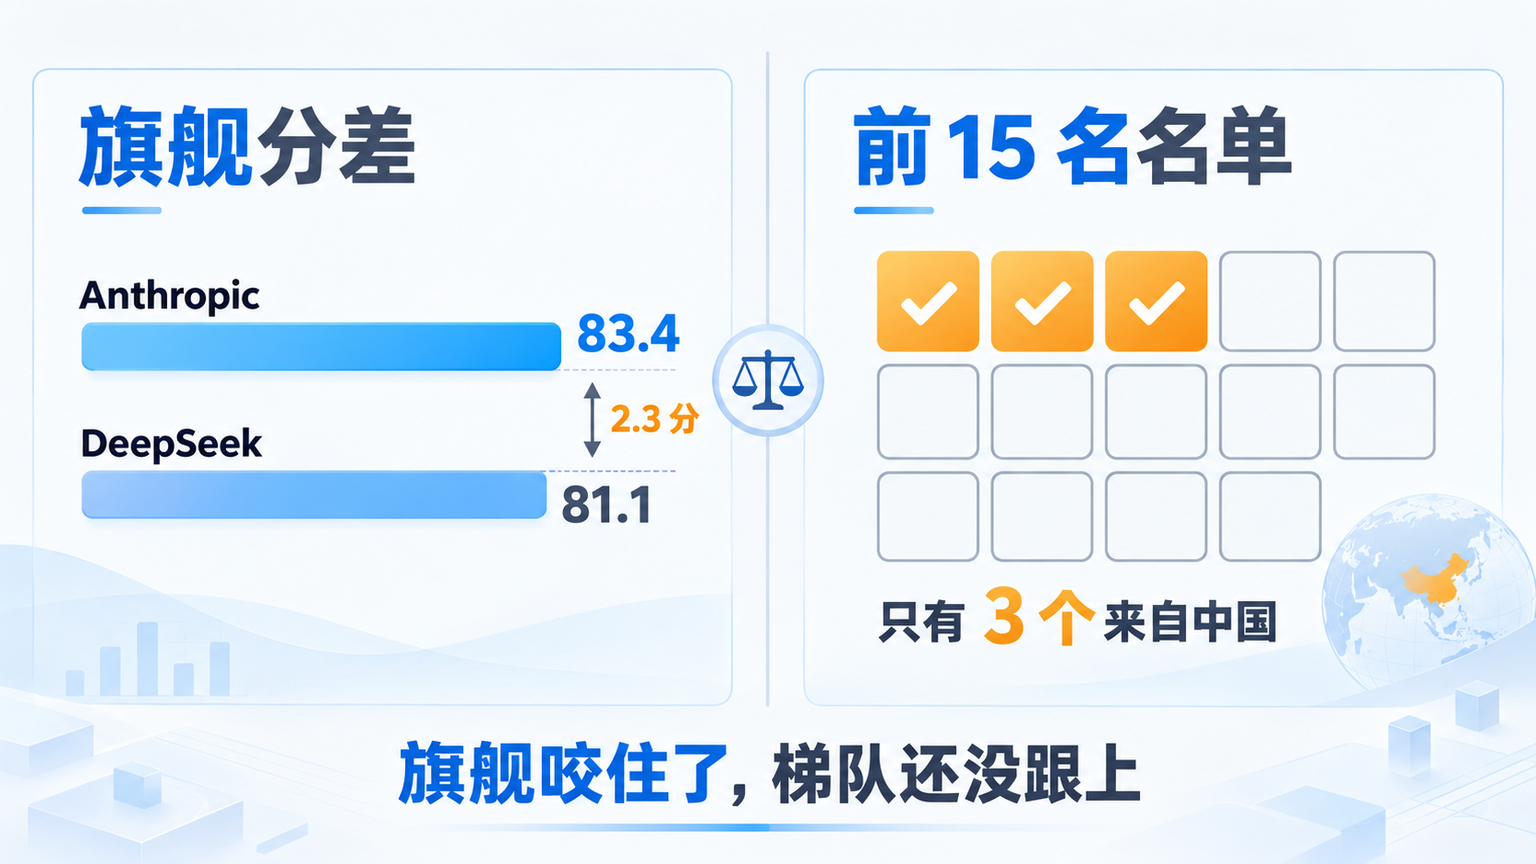
这半句和「3%」放在一起读才有味道。我去 LiveBench 官网核了当前榜单(10 月 5 日抓取),前 15 名的中国模型是三个:DeepSeek V4.1 Flash(第 7)、Kimi K3(第 12)、Qwen 3.8 Max(第 14)——和凤凰网转述的数字对得上。但同一个榜单的前 6 名里,Anthropic 占了 3 席、OpenAI 占了 2 席、Meta 的 Muse Spark 1.3 占 1 席。
也就是说,3% 这个数字描述的是「一家的头号种子」,而「3 席」描述的是「几家挤进决赛圈」。前者是深度,后者是厚度,两回事。一个队的头号种子打进了决赛圈,和一支队伍整体进了八强,是两种「差距」。
Agent 榜单上,是另一幅图景
我原本以为换个榜单会看到「中国 Agent 落后更多」,结果两次看到的是相反的答案。
先看 LiveBench 自己。榜单除了总分,还拆出 Reasoning、Coding、Agentic Coding(Agent 化编程)等七个维度。在 Agentic Coding 这一列上,DeepSeek V4.1 Flash 拿到 77.3 分,是全场最高——比总榜冠军 Claude Fable 5.1 的 66.1 高出 11 分,比 Claude 5.5 Opus Thinking 的 71.7 也高。而同一个模型在 Reasoning 列上是 86.7,明显低于 Anthropic 那几个 92 上下的模型。
再换 datalearner 的 Agent 榜(汇总 Terminal-Bench 4.0 等工具型基准),图景又反过来:国内排名最高的智谱 GLM-5.3 拿 41.82 分排总榜第 21 位,DeepSeek-V4.1-Flash 是 26.80,V4-Pro 只有 14.60——国内旗舰之间就差着近三倍。
同一个模型、同一类能力,两个榜单给出相反的结论。这恰恰说明问题:**「答题分差 3%」和「干活能力差距」不是同一个变量,而「Agent 能力」本身也不是一个变量。**你选哪个基准、哪个时间点的快照,决定你看到的是领先还是落后。2026 年 AI 商业化的主战场恰恰在后者:Agent、长程任务、工具调用,那里还没有一个大家都认的单一分数。
有意思的是,LiveBench 考「脑子」,VISTA 这周刚刚证明连「脑子」都可以靠外挂抬分;Agent 榜考「手眼配合」,那里暂时还没有外挂的神话。哪个更接近真实能力,读者可以自己掂量。
追赶是在什么约束下完成的
抛开榜单之争,这份报告里我认为最值得尊重的是追赶发生的条件。
Lea 在报告里把中国模型的进步归因于两条:AI 专业能力的深化,以及研究人员针对国产硬件优化模型的能力。翻译一下:这是在出口管制收紧、顶级芯片受限的前提下完成的追赶。年初 15% 到现在 3% 的斜率,是在「算力条数被卡着」的情况下跑出来的。
追赶是在什么约束下完成的,这件事在成本列上看得最清楚。LiveBench 榜单最后一列是「每个成功任务成本」,同一张表上:DeepSeek V4.1 Flash 是 0.029 美元,榜上最贵的 Claude Fable 5.1 是 1.212 美元——42 倍。连 OpenAI 的 GPT-6.1 Sol(0.142)和 Google 的 Gemini 3.7 Flash(0.157)都在 DeepSeek 的五倍以上。
价格能压到这个程度,说明中国团队在同等算力下榨出了更高的效率,这也是为什么「出口限制是否有效」会成为报告的质疑点:管住了芯片的条数,没管住算法的效率。
但约束同样是真实的。同一时间窗里还有另一条新闻线:朝鲜日报中文网转引路透的报道提到,市场传闻 DeepSeek 下一代模型的训练动用了英伟达最新芯片,而智谱 AI 的股价一度因此暴跌 23%。资本市场在中国 AI 叙事里同时定价着「追赶」和「卡脖子」两个方向,谁也不肯松手。训练芯片从哪里来、昇腾生态能不能接住下一代模型,这些问题的答案会直接决定下一条追赶曲线的斜率。
「差距」这个词什么时候会失效
回到标题的问题:这份报告该怎么读。
我的读法是把它拆成三个不同的「差距」,别混着谈:
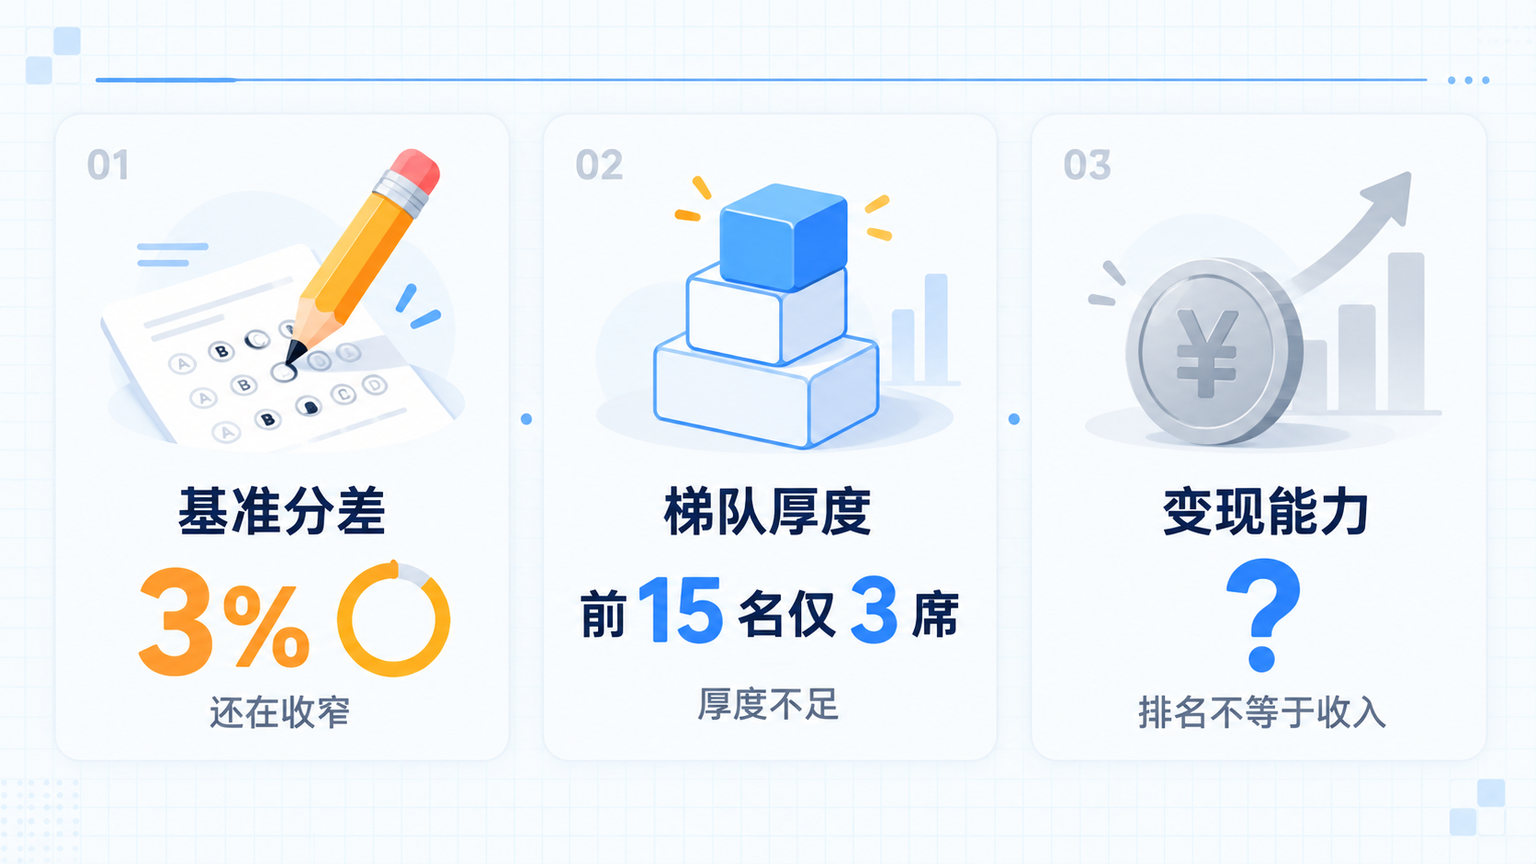
基准分差:旗舰对旗舰、单一榜单,这个差距是 3%,而且大概率还会继续收窄,因为追赶方在效率路线上还有空间,领先方的旗舰迭代节奏也没慢下来。
梯队厚度:前 15 名里 3 个中国模型,这个差距远没有 3% 那么乐观。头部一家的突破带不动整个名单,而生态厚度决定了容错率:一家公司的节奏波动,不该变成一个国家的排名波动。
变现能力:Lea 自己在报告结尾提醒,无论排行榜怎么排,「变现都可能很困难」。这句话对两边都成立。分数领先不等于收入领先,任务成本 42 倍的差距既是效率的证明,也是定价权的现实——一个模型再强,如果单次任务贵 40 倍,商业化就是另一道题。基准榜上的「抹平」和财报上的「抹平」之间,还隔着一整个商业化。
所以「中美 AI 差距只剩 3%」这个说法,准确的版本应该是:**在 LiveBench 这张答题榜上,两家旗舰的分差是 3%。**它是真的,值得记录,但它丈量的只是一条边。
什么时候「差距」这个词会失效?大概是当一篇报告不得不同时交代三件事:旗舰分差、前十五名名单,以及谁靠这东西赚到了钱。而读者不再只记住第一个数字的时候。
参考来源
- 彭博:DeepSeek新模型发力,中美顶尖AI跑分差距缩至3%(凤凰网科技,已入库)
- LiveBench 官方榜单(一手数据源,2026-10-05 抓取)
- 彭博報告:美中AI差距縮小到只剩3%(世界日报)
- US Lead in AI Over China Narrows After DeepSeek Gains, BI Says(Bloomberg,付费墙)
- 大模型 Agent 能力评测排行榜(datalearner)
- 「算力资源借我一用」…拖中国AI后腿的芯片(朝鲜日报中文网)
可信度边界:彭博原报告在付费墙内,本文所有直接引语(含 Robert Lea 的表述与 15%/9%/3% 轨迹)均转引自凤凰网科技与世界日报的报道,若与原文有出入以彭博原报告为准。LiveBench 榜单数据为 2026-10-05 官网抓取快照,该榜单持续更新,排名与分数随时可能变化;榜单仅覆盖公开可测任务,不代表真实业务表现。datalearner 的 Terminal-Bench 口径与 LiveBench 的 Agentic Coding 口径不同,两者结论相反已在正文中说明,不宜直接互相换算。「市场传闻 DeepSeek 下一代模型动用英伟达芯片」为路透转引的传闻,未获官方证实。