两条帖子,一个更重要的信号
9 月 22 日,Claude Opus 5.5 发布。
10 月 1 日,r/ClaudeAI 出现一条帖子,标题是:
Opus 5.5 nerfing - how to measure, how to spot, how to sue (Opus 5.5 被降级了——怎么测量、怎么识别、怎么起诉)
⬆️1566 · 💬335。
往前两天还有一条:
Is Opus 5.5 entering a “nerfed” phase? LiveNerf baseline update (Opus 5.5 正在进入"被削弱"阶段?LiveNerf 基线更新)
⬆️2535 · 💬443。
再往前,9 月 28 日,一个看起来平平无奇的帖子开了头:Is Opus 5.5 nerfed? New benchmark called LiveNerf measures this live(一个叫 LiveNerf 的新基准在实时测量)。
Nerf 是游戏圈的词,意思是"一次让东西变弱的补丁"。放到大模型上,它指的是厂商在发布后某个时间点,用同名的一个更弱的模型悄悄替换掉原来那个。量化、换成小模型、降低 effort 等级、改路由规则,都算。
先说清楚:截至发稿,没有任何证据表明 Anthropic 真的降级了 Opus 5.5。 所有信息都来自社区观察,未经官方确认。GitHub 上那个项目自己也写得很直白——“也可能什么都没发生,只是人们在对着噪声做模式匹配”。
但这两条帖子背后有件事,比"到底降没降"有意思。社区已经不满足于互相描述感受了,他们开始造仪器。而且造得相当讲究。
为什么以前根本吵不出结果
在 livenerf 出现之前,“模型是不是变笨了"这个问题,双方都拿不出证据。
抱怨的一方说,这周明显变差了。反对的一方说,你的用法和上周不一样了。谁也说服不了谁。
作者把这话写进了 README:
“Nobody has had a clean day-0 baseline to check against, so every argument ends up as vibes versus vibes.” (没人手里有一个干净的第 0 天基线可以对照,所以每场争论最后都变成感觉对感觉。)
基线是死结。你记忆里"发布那周特别好用”,恰好是整个房间里最不可靠的仪器——那天你刚拿到新模型,正在兴奋状态,提示词写得比平时认真,而且你只记住了成功的那些。
更麻烦的是,你几乎没法把"模型变了"和"我用的东西变了"分开。Claude Code 客户端会更新,API 网关会调路由,你的项目代码在迭代,系统提示词可能被你改过。任何一环变了,产出效果都不一样。
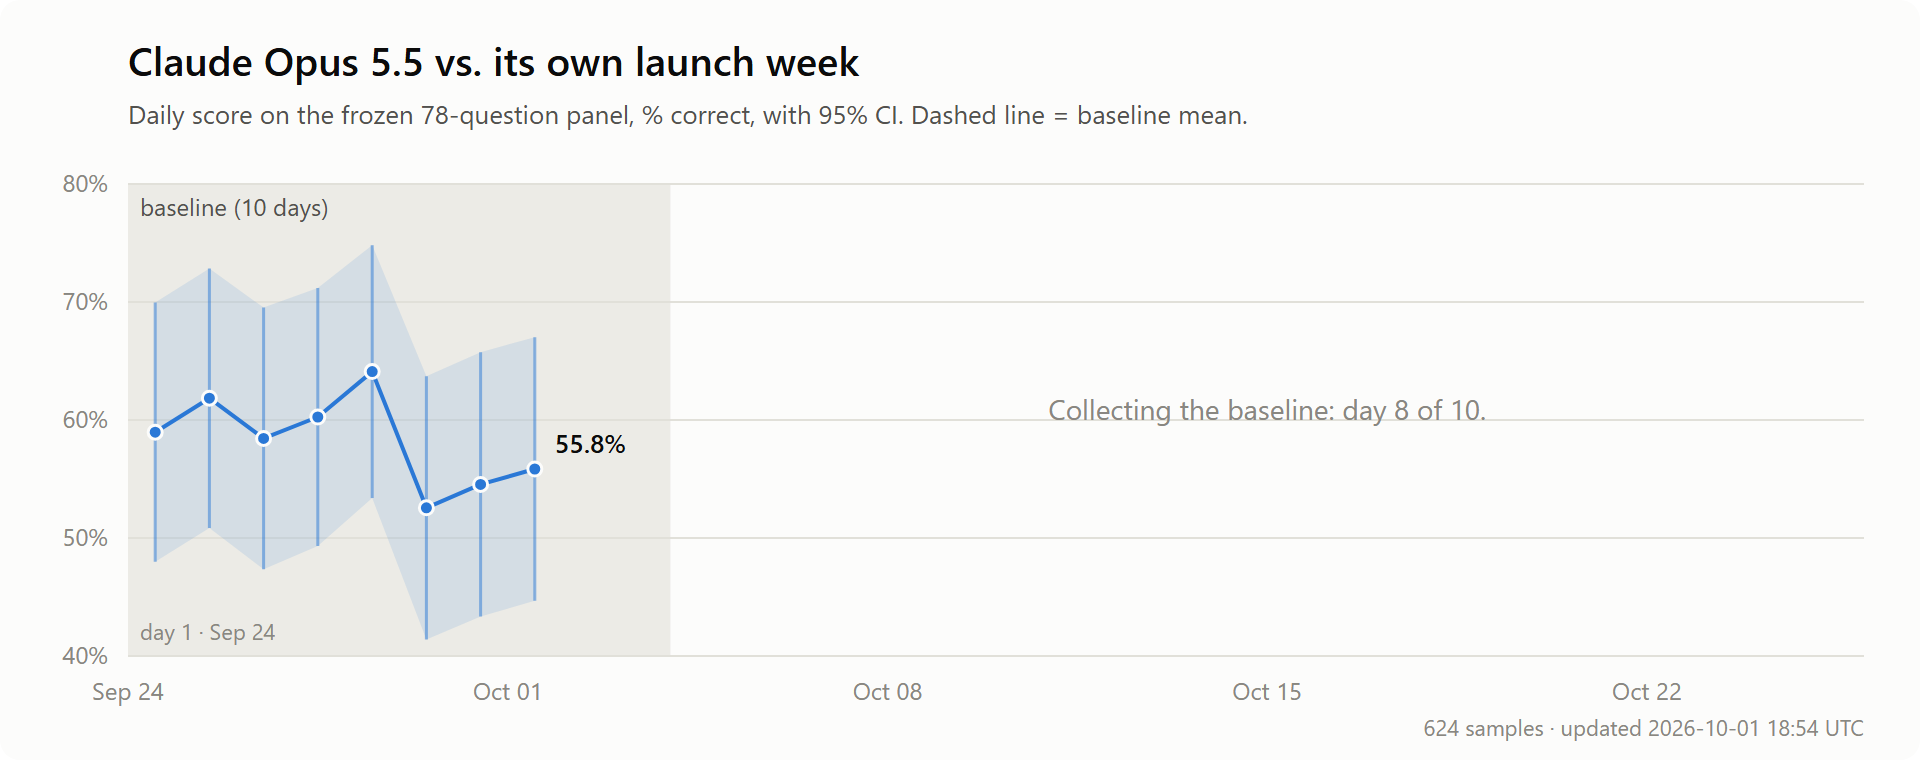
livenerf 官方每日得分曲线。横轴是运行天数,纵轴是 78 题面板的得分;灰色阴影是作为基线的第 1–10 天窗口,点是每天的实测值。到第 20 天才有第一条可判定的结果行——这也是为什么这件事必须提前 30 天开始跑,而不是等吵起来再测。
Hacker News 上关于这个项目的讨论拿了 786 分、300 多条评论,两派泾渭分明:
“Nerfing models isn’t real in the vast majority of reported cases."(绝大多数被报告的降级案例其实并不存在。)
“people are just getting used to the new level of intelligence."(人们只是习惯了新的智能水平。)
还有一位 Claude Code 用户说他现在每次都直接关掉应用内的质量反馈弹窗,因为"质量更稳定了”——然后诚实地补了一句:“完全即兴和个人经验。"(Complete adhoc and personal experience.)
这正是 livenerf 想替换掉的证据状态。
六个设计决策
作者 ninjahawk 在 Opus 5.5 发布后 2.5 天启动,承诺连测 30 天。目标只有一个:让测量本身不会说谎。代价是设计上要非常苛刻。
题库必须选"会飘"的题。 这是最关键的一条。他从 GPQA Diamond、MMLU-Pro、竞赛数学和 AIME 2025–26 里筛了 2,336 道题(每题 4 个样本),发现 Opus 5.5 首次作答准确率约 93%,其中 97% 的题是"永远答对"或"永远答错”。永远对的题测不出下降,永远错的也不行。最后能用的只剩 78 道有时对、有时错的题。一个能测出退化的题库,得先把所有不会动的题踢出去。
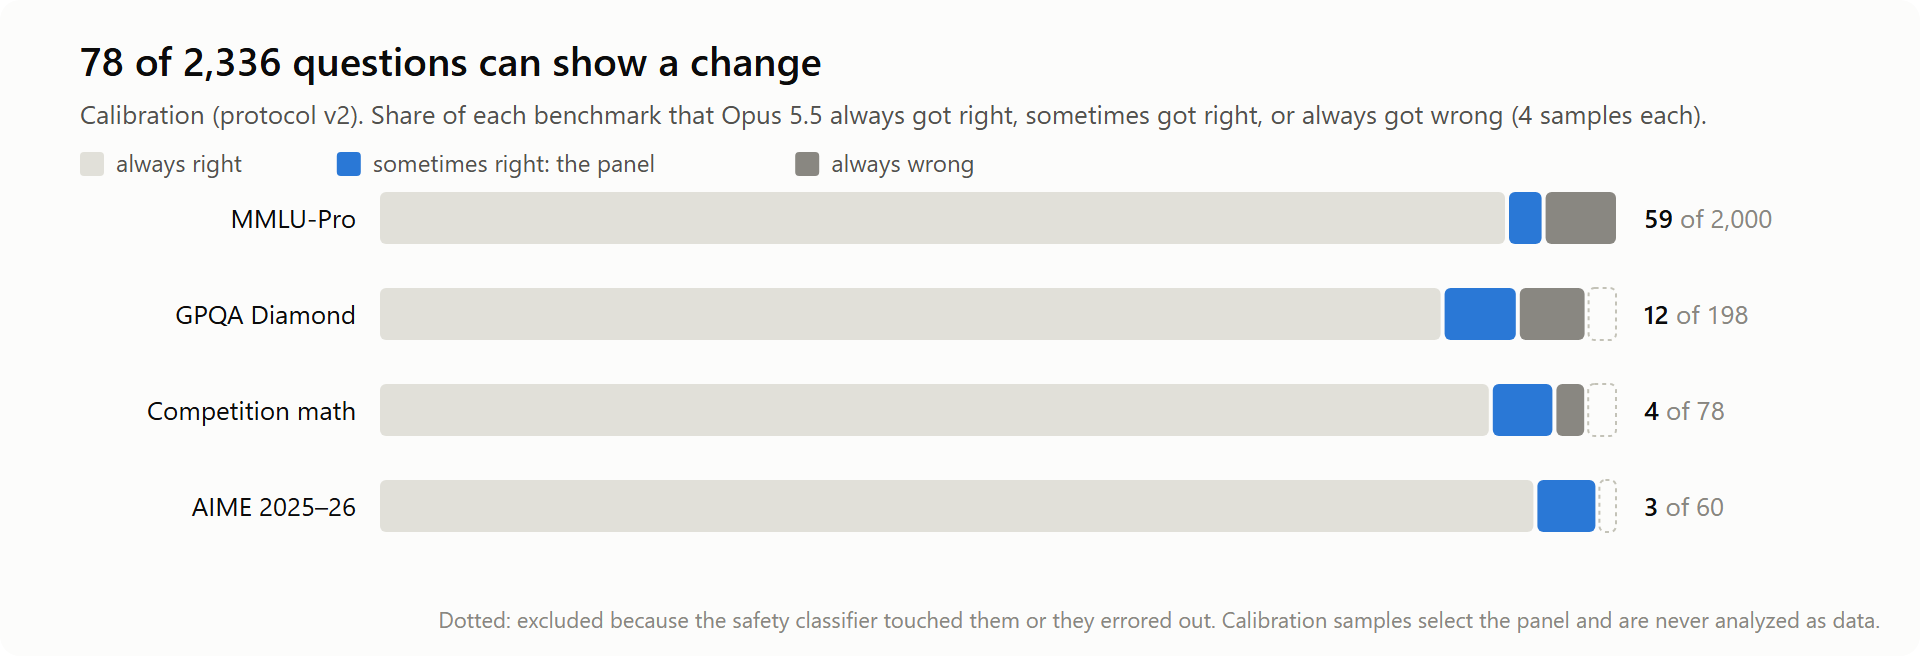
校准阶段的结果分布,按 benchmark 拆开统计。左段"总是答对"和右段"从未答对"的题目对检测退化毫无贡献,全部被剔除;只有中间那 78 道"有时对有时错"的题留了下来。
这一步还量出了一个叫选择偏差的东西:因为题目是按"有时对"选出来的,它们真实的通过率会比看起来更接近 50/50。在全新样本上复测,通过率从 54.7% 升到 62.0%,功效计算用的是后者。
永远不用 AI 打分。 评分方式是精确匹配。作者的态度是"绝不用 LLM 评委,因为评委自己也会漂移”。顾虑很实在:如果厂商有权限改评分的那个模型,那么对评委的降级,看起来就像被测对象变了。
环境全部封死。 冻结的系统提示词,无工具,无 MCP 服务器,无 CLAUDE.md。harness 也钉死:跑在 Claude Max 订阅上,走 headless 的 Claude Code(claude -p),CLI 版本固定 2.1.280。理由写得很 blunt——
“Pin the CLI. This is not optional: a Claude Code update changes the harness, and a changed harness looks exactly like a changed model.” (必须固定 CLI 版本。Claude Code 一次更新就会改 harness,而改了的 harness 看起来和改了的模型一模一样。)
用订阅而不是 API。 PLAN.md 估算完整跑一天要 55 美元,接近每月 1,600。订阅路线便宜得多,而且测的正是大多数抱怨者实际在用的东西。
双臂对照。 旧的 claude-opus-5 每天也答同一批 GPQA 题。如果两个模型一起动,那变的是 harness 或平台;只有 Opus 5.5 单独动,变化才在模型上。
判定规则提前写死。 99% 置信区间排除 0,连续两个 10 天窗口都成立,下降至少 3 个点,对照组没有同步移动。作者解释为什么要提前写:
“Writing the rule down before the data arrives is what keeps the author honest when day 20 looks exciting.” (在数据到来之前就把规则写下来,是为了让作者在第 20 天看起来很激动时还能保持诚实。)
最后一点我觉得最妙。项目建立在英国 AI Security Institute 的 Inspect 框架上,统计方法遵循 Evan Miller 的《Adding Error Bars to Evals》——这篇论文是 Anthropic 自己发的。用 Anthropic 的统计学论文,去审计 Anthropic 的模型。
先把仪器弄坏一次
检测器投入使用前应该被故意弄坏一次,看看它会不会响。作者用 Claude 的 effort 设置做了验证,结果写进 VALIDATION.md:
| 相对 high effort | 输出 token 变化 | 准确率变化 |
|---|---|---|
| medium effort | −26% | −4.2 ± 3.9 点 |
| low effort | −62% | −8.3 ± 4.5 点 |
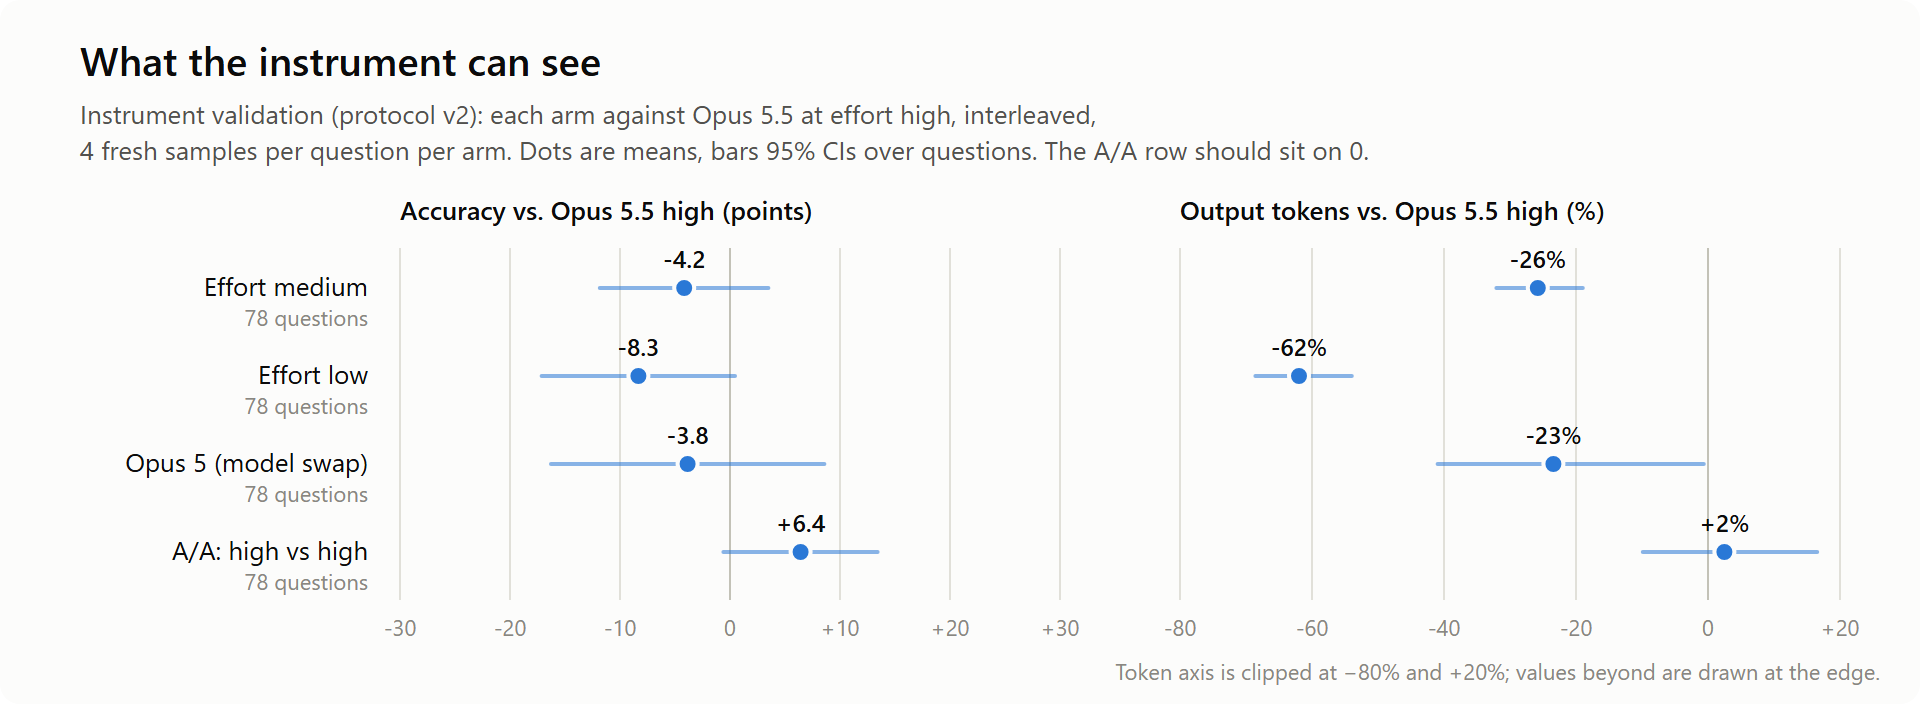
阳性对照实验结果,按 benchmark 拆开看。上排是准确率变化,下排是输出 token 变化——token 那一排的落差明显更陡,正是"token 是更早的信号"这个结论的来源。
每样本输出 token 的中位数,从 high 档的 638 掉到 medium 的 474,再掉到 low 的 293。
“Lower effort shows up much more clearly in tokens than in accuracy.” (降低 effort 在 token 上显现得比在准确率上清楚得多。)
把思考量砍掉三分之二,分数才掉 8 个点,刚刚超过检测阈值。token 呢,砍掉一半还多。
这给了一条挺实用的经验:token 数是比准确率更早的信号。 如果你的 Agent 突然对同样的活儿写得比以前短,那才是最早的警报。
它测不出什么
一个基准最值得看的部分,往往是它主动承认的盲区。livenerf 把这句写在最显眼的位置:
“Swapping in Opus 5 was not distinguishable from Opus 5.5 at 99%” (在 99% 置信度下,换成 Opus 5 无法与 Opus 5.5 区分。)
实测差距 −3.8 ± 6.3 点,token 少 23%。
也就是说,最可能的那种悄悄降级——同门降级,换成上一代——恰恰是这个仪器目前测不出来的。而用户真正担心的事情,恰恰是这种。
这次审计还顺带查出了题库自己的毛病:78 道题里有 8 道答案标错、30 道有歧义。作者标记后仍然保留,为的是让题库在 30 天内保持恒定。他的说法是,降级检测器在找到降级之前,先找到了测试集里的 bug。
还有个服务层细节:安全分类器有时会用 Opus 5 来作答,或者直接拒绝生物和部分数学题,这些样本会被从计分里剔除。
Anthropic 的立场
Anthropic 在 2025 年正面回应过类似质疑。那波质量投诉之后的工程复盘里,他们写:
“To state it plainly: We never reduce model quality due to demand, time of day, or server load. The problems our users reported were due to infrastructure bugs alone.” (明确地说:我们从不因为需求、时段或服务器负载而降低模型质量。用户报告的问题完全源于基础设施 bug。)
同一篇文章也承认用户看到的东西是真的:
“Approximately 30% of Claude Code users who made requests during this period had at least one message routed to the wrong server type.” (在此期间发起请求的 Claude Code 用户中,约 30% 至少有一条消息被路由到了错误的服务器类型。)
那 2025 年的情况是:用户对症状的判断没错,对动机的判断错了。问题出在基础设施 bug,不是厂商蓄意降级。
livenerf 的 README 认真吸取了这个教训:发布周很可能恰恰是最差的一周。负载、新服务路径、新 bug,全都在发布后达到峰值,第一周采到的基线可能是整条曲线的最低点。
截至 9 月 29 日,30 天跑完 6 天。第 1–10 天作为基线,之后是两个 10 天窗口。第一次可能下结论的时间大约在 10 月 24 日。
有个容易被跳过的设计:代码题也不让模型给自己判分。Claude 返回的是文本代码,由 harness 在沙箱里跑隐藏测试,模型全程不执行任何东西。这是"精确匹配"那条原则在代码场景下的延伸。
五个子图分别跟踪 GPQA Diamond、MMLU-Pro、竞赛数学等各 benchmark 相对自身发布周基线的配对差异,横轴从 9 月 24 日一直排到 10 月 26 日。值得留意的是这张图现在几乎是空的——它本来的样子就是这样。第 20 天之前不会有任何可判定的数据点,而横轴上标出的 “first point after the 10-day baseline” 那一竖线要到 10 月 24 日之后才会被跨过去。这正是预注册的意义:结论的形状早就定死了,剩下的只是等数据填进来。
所以今天诚实的回答是:没人知道,包括那些之前很确定的人。
你自己的 Agent 也可以这么测
真正可以偷走的部分很小,也很便宜。如果你在用 Claude Code 或 API 搭 Agent,下面五步不需要一周的工程量。
钉死版本。 API 调用用具体模型名而不是别名,CI 里钉死 CLI 版本。harness 变了和模型变了,在数据上长得一模一样。
记录每个任务的输出 token。 上面那组数据说明,降低 effort 会先在 token 上动,再在准确率上动。
留几个冻结任务。 答案要能机器精确判定,并且挑模型"有时对有时错"的。
用代码打分。 普通函数、精确匹配,评分回路里不要有模型。
先把判定规则写下来。 多大幅度的下降、持续多少天,才算数。
最小实现大概长这样:
|
|
先看这个文件,再看 Reddit。
补一句
仓库致谢里有句话我盯了很久:
“a lot of this repo is written with the help of Claude, which is the model being measured.” (这个仓库里很多代码是在 Claude 的帮助下写的,而 Claude 正是被测量的那个模型。)
Claude 帮忙造了用来检查自己是否变笨的仪器——这就是为什么评分必须是纯函数、规则必须提前写死、基线必须公开。作者最后那句要求也值得抄给所有做 AI 工具的人:你不应该需要信任作者,不管是人还是模型。
这个项目还很年轻,30 天只跑完 6 天,盲区明摆着,最关键的同门降级还测不出来。但它至少把一件事摆到了台面上——当你不确定手里的 AI 是不是你以为的那个 AI,正确的反应不是去吵,也不是去信,是去测。
它会在 10 月 24 日给出一个带时间戳、有公开规则、有已知盲区的答案。到那天可以回来看。
参考来源:
- livenerf — GitHub 仓库
- livenerf README:设计决策与盲区说明
- livenerf VALIDATION.md:effort 设置的对照实验
- Is Claude Opus 5.5 nerfed? A 30-day benchmark started the clock — The Daily Diff / DEV
- Hacker News:Livenerf: Has Opus 5.5 been nerfed yet?
- Reddit r/ClaudeAI:Is Opus 5.5 nerfed? New benchmark called LiveNerf measures this live
- Reddit r/ClaudeAI:Is Opus 5.5 entering a “nerfed” phase? LiveNerf baseline update
- Reddit r/ClaudeAI:Opus 5.5 nerfing - how to measure, how to spot, how to sue
- A postmortem of three recent issues — Anthropic Engineering
- Evan Miller: Adding Error Bars to Evals (arXiv:2411.00640)
- Inspect — UK AI Security Institute