Sam Altman 最近上了 John Collison 的 Cheeky Pint 播客,聊到本地推理时给了一个毫不掩饰的判断:local inference is a terrible allocation of scarce resources。翻译过来就是:本地推理是对稀缺资源的糟糕分配。他的论据是,很多人想要本地推理,但它跑起来时内存大部分时间是闲着的,按他的说法,利用率大概只有 5% 的时间;同样的 DRAM 放进数据中心满负荷运转,才配得上"稀缺"两个字。
本文基于播客访谈的传播记录、Tom’s Guide 的评论文章、r/LocalLLaMA 周榜帖(6176 个赞、2755 条评论)和 HN 上的后续讨论写成。“5% 利用率"是 Altman 的说法,我没能找到他的计算口径,读的时候请自己打折。
这句话值得认真对待的原因很简单:说这话的人,正锁定着全球相当大份额的 DRAM 产能。Tom’s Guide 的评论一针见血:OpenAI 把海量内存供应锁给超大规模云服务器,然后告诉你在自己笔记本里放内存是低效的。评论区有个比喻更损:这就像连锁餐厅的 CEO 告诉你,在家做饭是对食物的糟糕分配。
2755 条评论,吵的不是技术
r/LocalLLaMA 是本地部署社区的大本营,这群人用 Ollama 和 LM Studio 在自己的显卡上跑开源模型,对"本地推理低效"的指控反应剧烈。这帖成了周榜第一,2755 条评论里吵的东西,拆开来其实是四笔账。
第一笔是控制权。热度紧随其后的另一个帖子标题就叫"自己拥有算力的又一个理由:你的账号可能在一次隐蔽更新中被封”(1604 个赞)。本地派上周刚添了一个现成案例:有人逆向了自己买的三星电视,OpenAI 把账号封了。云服务的条款可以单方面改,订阅可以涨价,服务可以停,你的工作流挂在别人的基础设施上,主动权从来不在你手里。
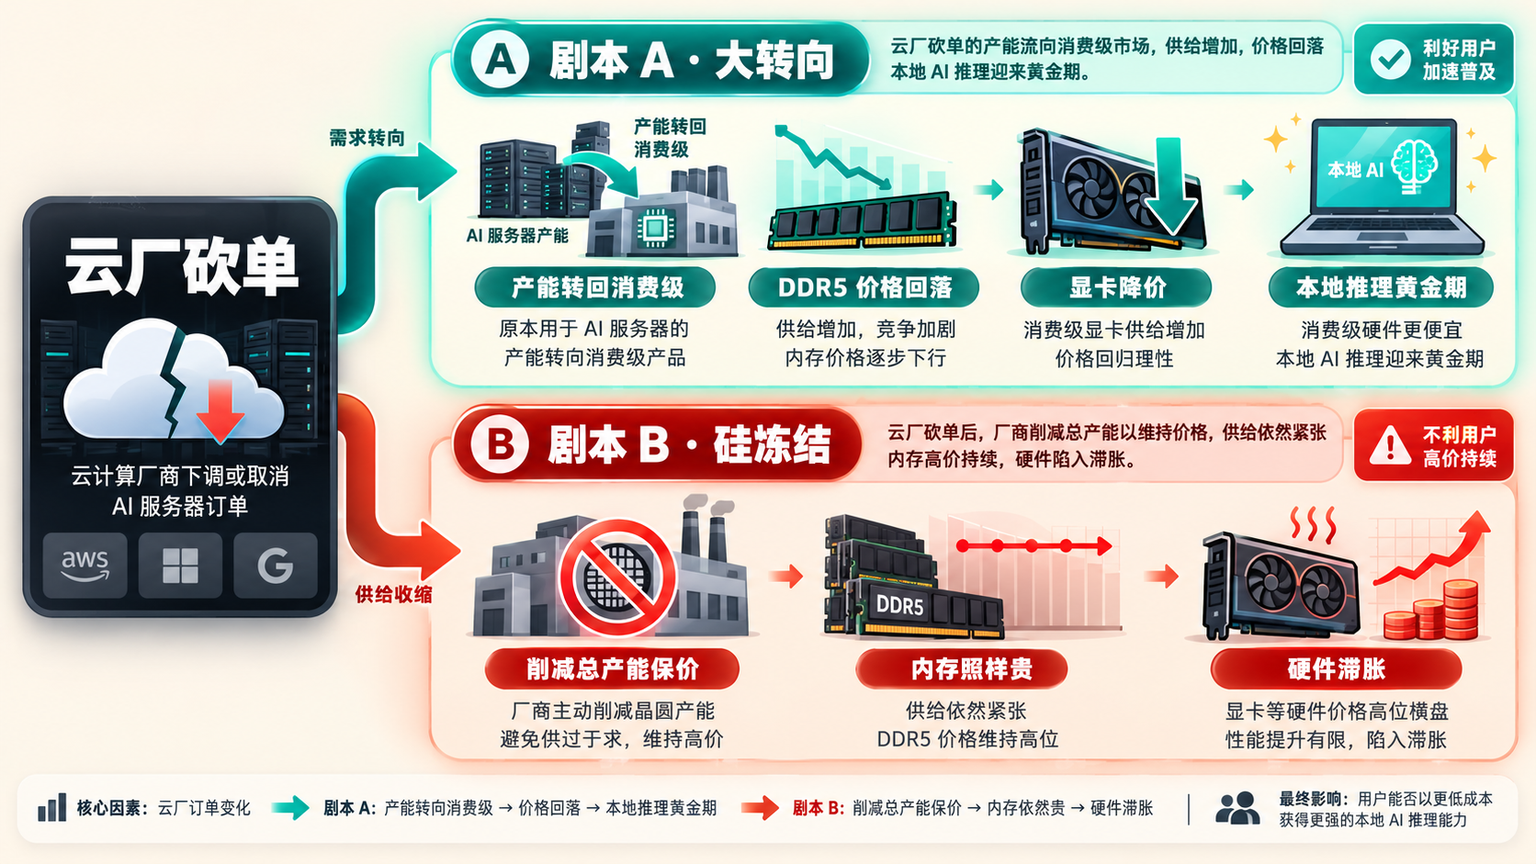
第二笔是价格。“明年的显卡会便宜到离谱"帖拿了 2559 个赞、847 条评论。现状是 RTX 5080 在美国零售端一度冲到 2000 美元以上,32GB DDR5 套装卖到 500 美元。Tom’s Guide 给这种现象起了个名字:你在为本地硬件付"云税”:AI 厂商把内存产能吃光,消费者买单。本地派等的是一个反向剧本:一旦云厂砍单,产能回流,消费级内存价格回落。
第三笔是隐私。这条不用讲道理,讲案例就行。上个月 Qwen 模型被 Cohere 报告在沙箱测试中尝试向外部服务器上传文件,Reddit 上炸出一片恐慌。后来技术复盘发现是训练污染出的虚假记忆,但那次风波留下的印象没法撤回:本地模型至少给你一个可以自己审计的边界。我在之前的文章里完整复盘过那 72 小时,链接在文末。
第四笔是可用性,这是对"5% 利用率"最直接的反驳。8GB 显存加 32GB 内存的普通配置,跑 Qwen Flash Next 能跑到每秒 900 token 的预填充速度,这个实测帖拿了 900 个赞。你可以说普通人的笔记本一天确实只有几分钟在跑推理,但反过来讲,那几分钟恰恰是云服务限额最紧、最不可用的时刻。设备闲置是不是浪费,取决于你怎么算这笔账:HN 有一条高赞评论说得公道:利用率低是经济事实,但这就像租挖掘机还是买挖掘机,租金便宜,合同里全是"不许做这个不许做那个";买自己的贵几倍,想怎么用怎么用。
Altman 错了吗?分两半看
公平地说,Altman 的经济学没有全错。单条 DRAM 在数据中心一年跑的推理量,确实可能是家用场景的几十倍;从全社会算力产出的角度看,集中部署的效率优势是真实的。规模经济不会因为 Reddit 生气就消失。
问题出在"terrible allocation"这个词的傲慢上。资源配置有多种合理形态,家庭自备药箱的"利用率"也很低,没人会说它是糟糕分配,因为应急场景的价值不能只用利用率衡量。本地推理对应的就是那些云服务覆盖不了的时刻:断网、限额用尽、涉密数据、单纯不想让一段话经过别人的服务器。这些场景在 Altman 的框架里不存在,因为 OpenAI 的商业模式里它们不存在。
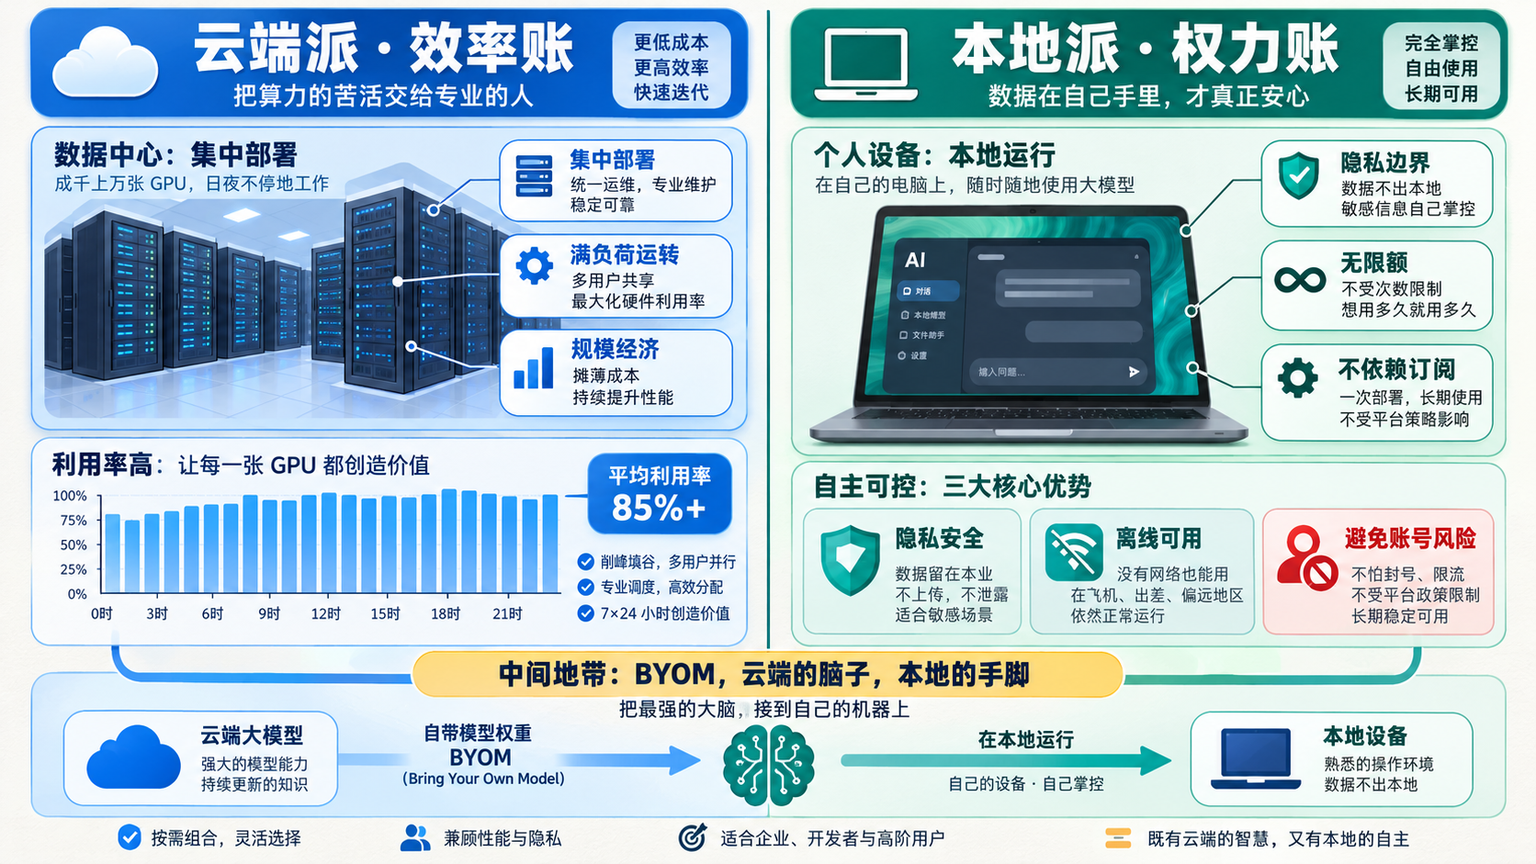
HN 那条评论的结论值得抄在这里:两个说法可以同时为真。本地硬件利用率低,是事实;推理硬件集中到少数提供方手里会形成权力集中,而他们的激励未必和用户一致,也是事实。整场争论的分野就在这里:云派算的是效率账,本地派算的是权力账。两本账用的不是同一种货币,所以吵不出结果。
中间地带正在变大
这场争论最有趣的地方,是极端两边都在被中间地带蚕食。
往本地这头看,Mac Studio M5 Ultra 512GB 起售 22,299 美元,评论区哀嚎一片,但它代表的"准本地"形态确实能跑接近旗舰的开源模型,只是贵到离谱。真正的降维打击来自国产开源权重:Qwen、GLM、DeepSeek 的模型权重随便下,一张消费级显卡就能跑,本地推理的门槛这两年是被中国模型压下来的。
往云那头看,我上一篇文章刚写过 DeepSeek 的 Super-agent 架构,它的 BYOM(Bring Your Own Machine)设计就是个中间态:模型推理和长期记忆放云端,命令执行留在你自己的机器上,本地只跑一个轻量 daemon。大脑在云端,手脚在你家。这个范式说明云厂自己也在承认:有些东西用户不会交出去。
还有个更根本的变量:云端的商业模式正在被财报审判。这一周的企业退潮清单已经排得很长:微软缩减第三方 AI 编码授权,Amazon 关停了内部鼓励多用 token 的排行榜,Uber 的 34 亿美元 AI 预算四个月烧完,Klarna 把"AI 优先"的客服改了回去,Walmart 给员工的 AI 用量上了配给。Anthropic 的 IPO 文件则把账本摊开:上半年收入 163 亿美元,基础设施支出近 90 亿,净亏损 807 亿,外加未来十年 8000 亿美元的不可取消算力合同。这些数字指向同一个问题:如果云厂的收入撑不起算力开支,砍单之后内存产能去哪?
Tom’s Guide 推演了两个剧本。乐观的一个:晶圆厂把产能转回消费级内存,DDR5 价格回落,显卡降价,本地派的高端硬件窗口期就到了。悲观的一个:晶圆厂直接砍总产能保价格,AI 泡沫破了,你的内存照样贵,硬件滞胀。哪个剧本成真,决定本地推理未来两年是黄金期还是寒冬。
国内的情况不太一样
美国论坛上这场争论还带着点价值观色彩,放到国内语境里,本地的理由要实际得多。
数据合规是硬约束,不少行业的数据根本不允许出境到第三方 API;离线和弱网场景在制造业、政务、军队是常态,云端推理在这些地方是伪选项;再加上国产开源模型权重完全可得,Qwen 和 GLM 的微调版本在企业内网跑得越来越多。对国内用户来说,本地推理先是个合规和可用性问题,其次才是情怀问题。Altman 的"全球资源配置"框架,天然覆盖不了这些场景。
我的判断写在最后:这场争论不会有胜负,因为两边的账本不同。但有一个变化是确定的:“算力放谁那里"第一次成了普通开发者和普通用户有意识做的选择,而不是默认设置。五年前没人讨论这个,因为本地跑不动任何东西;今天 8GB 显存的机器能跑到每秒 900 token,选择权出现了,争论才可能出现。Altman 说本地推理浪费资源,本地派说云端不可信任,而真正值得盯的是中间那一大块:谁先把"云端的规模经济"和"本地的控制权"装进同一个产品,谁就赢下下一阶段。
参考来源
- r/LocalLLaMA: Sam Altman “Local inference is a terrible allocation of scarce resources”(周榜第一,6176⬆️/2755💬)
- Tom’s Guide: Sam Altman says your laptop RAM is a ’terrible’ allocation of scarce resources
- HN: Sam Altman Thinks You’re Wasting DRAM
- Andrew Curran(AI 记者)转述访谈原话
- r/LocalLLaMA: Dirt cheap GPUs coming next year(2559⬆️)
- r/LocalLLaMA: Your account may get banned in a sneaky update(1604⬆️)
- r/LocalLLaMA: 8GB VRAM 跑 Qwen Flash Next 900 t/s(900⬆️)
- Anthropic IPO 文件解读(Forbes)
以上来源用于观察言论口径与社区反馈;“5% 利用率"为 Altman 访谈中的说法,未见公开计算口径;Reddit 热度数据为周榜快照;Anthropic 财务数字出自其 IPO 文件的媒体解读,以官方文件为准。