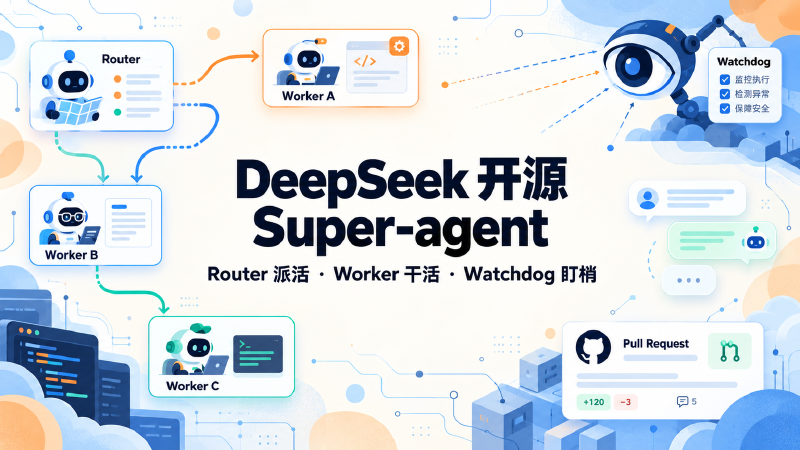
10 月 31 日晚,DeepSeek Harness 团队在公众号发了一篇不太像发布会的文章,《Super-agent 设计探索:迈向更自主的 Agent 系统》。没有预热海报,没有倒计时,随文只挂出了一个 MIT 协议的原型插件 dsh-superagent-prototype,官方还特意补了一句:这只是验证技术路线的原型,不是正式产品。
本文基于这篇官方文章、IT之家等媒体的转述,以及 GitHub 上原型仓库的公开信息写成。架构细节以官方原文为准,实验数据全部出自 DeepSeek 自己的合成负载测试,我会标注哪些数字只能说明调度能力、说明不了别的。
不过 DeepSeek 在文章里给出的判断倒是干脆:模型能力已经逼近够用,真正卡住生产力的是人的注意力。解法是一套常驻在线、AI 调度 AI 的双层架构。
为什么是 Super-agent:瓶颈不在模型,在人的注意力
现在的 Agent 工具,包括 Claude Code、Codex 这些主流选手,基本单位都是单一 Session(会话)。你开三个终端跑三个任务,就是三个互不相识的 Session,上下文各自为政。想并行推进多项工作,人就得在几个窗口之间来回切换、逐个维护状态。
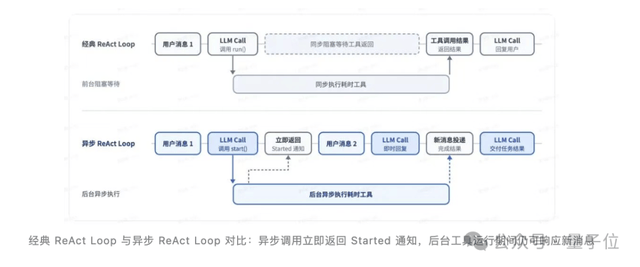
DeepSeek 团队给出的观察数字是:一个人通常只能同时跟进 3 至 5 个活跃 Session。就算你用 CLI、MCP 或者外部连接器把本地 Agent 的手脚延长,三个老问题还是躲不开:单会话同步阻塞(一个工具调用卡住,整条对话干等)、多任务上下文混乱(哪个窗口改到哪一步了)、本地设备一离线任务全停。
所以 Super-agent 被定义成一种新的 Agent 形态,四个基础特征:连续、高效、主动、持久。这四个词单独看都平平无奇,配上场景就具体了。
连续,指的是同一个 Agent 可以在即时通讯群聊和 GitHub Pull Request 评审之间无缝推进同一件事,你在哪里冒头,它就在哪里接话。主动,是它盯着群聊里的公共讨论,在没有任何人 @ 它的情况下,自己识别出一个缺陷,复现问题,提交修复 PR。持久,是它长期在线,挂了能自己爬起来。
这几个特征里最颠覆直觉的是主动。我们现在的使用习惯是 Agent 等指令,Super-agent 的预设是 Agent 自己找活干。使用方式整个反过来了,后面的整套架构都是围着这个转变搭的。
双层架构:Router 派活,Worker 干活
整套架构的核心是一个很朴素的组织学设计:管理层和执行层分离。
Router(路由层)负责承接人类交互、维护全局上下文、把任务分派下去,并且是唯一对外的发言窗口。Worker(工作层)在相互隔离的会话里并发执行具体工作,它不直接跟用户说话,干完活把状态和结果汇报给 Router,由 Router 统一对外沟通。
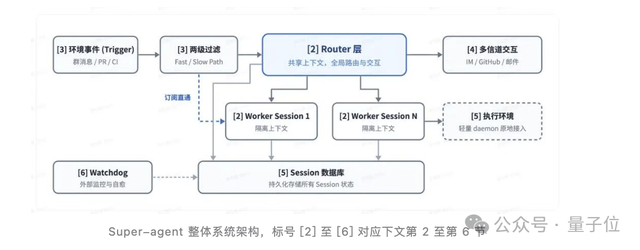
这个分工的好处是双边的。对用户来说,你不需要再在多个 Session 之间切来切去,所有对话只有一个入口。对系统来说,Worker 之间相互隔离,一个任务把 Worker 搞崩了,污染不了其他任务,也动摇不了全局上下文。
熟悉软件工程的人会心一笑:这就是微服务架构里网关加工作进程的那套思路,只不过现在的"服务"是活的模型实例,“网关"是另一个模型。用组织结构解决注意力问题,比单纯把模型做聪明要便宜,也更可预期。
事件驱动:让 Agent 自己听见世界
要让 Agent 主动找活干,前提是它能持续感知环境。DeepSeek 把群聊消息、邮件、日程提醒、代码审查评论、CI 运行结果这些外部信息统称为 Trigger(触发事件)。
这里有个容易被忽略的工程细节:两级过滤。系统先用程序规则把大量无关事件筛掉,剩下的才交给大模型做语义判断,决定要不要采取行动。这个顺序很关键,如果每条群消息都要过一遍模型,一个活跃群聊一天就能把 token 预算烧穿,Router 自己先变成瓶颈。
对已经分派了任务的事件流,Worker 可以直接订阅对应的 Thread(话题线)。后续相关事件由程序直接送到 Worker 手里,不再绕经 Router。官方的设计意图很明确:Router 只处理需要调度决策的事件,常规跟进走直通车道。
记忆与投机:先干活,再汇报
长期运行的 Agent 绕不开两个问题:上下文装不下,和等待时间太长。DeepSeek 给的答案是两个机制加一个胆子不小的策略。
上下文管理靠 Inline & Spill(内置与溢出):近期大概率要用的信息直接放进模型上下文窗口,超预算或低频的留在窗口外,模型按需读取。历史信息找回靠链式召回(Chain of Recall):Trigger、Thread、Worker Session 这些对象之间存着引用关系,模型沿着关联 ID 一步步把历史任务的来龙去脉找回来。没有向量库、没有嵌入式索引,用的是最朴素的指针链。
胆子不小的那个策略是投机执行(Speculative Execution):根据环境信号,在后台提前开工。收到会议邀约,先查日程冲突、搜背景资料、把回复草稿拟好;群里有人讨论故障,不等确认派活,先自己复现问题、找修复方案,只有确认问题真实存在并且找到了简单修法,才把结果端给用户。
这个策略有明确的赌注属性:赌对了,人类等待时间大幅缩短;赌错了,烧掉的是算力和 token。官方文章没有给出投机执行的误判率数据,这是我认为全文最需要补的一块实验。
另外一项异步 ReAct Loop 改造值得一提:耗时的工具调用被改成异步的 start() 和 stop(),Agent 发起后台任务后立刻返回 Started 状态接着聊天,结果随后作为新事件流回会话。官方说明这项机制已在 DeepSeek Harness 里实现,但尚未默认开启。不敢默认开,恰恰说明他们也清楚这套东西跑起来有多不可控。
存算分离:云端的脑子,本地的手脚
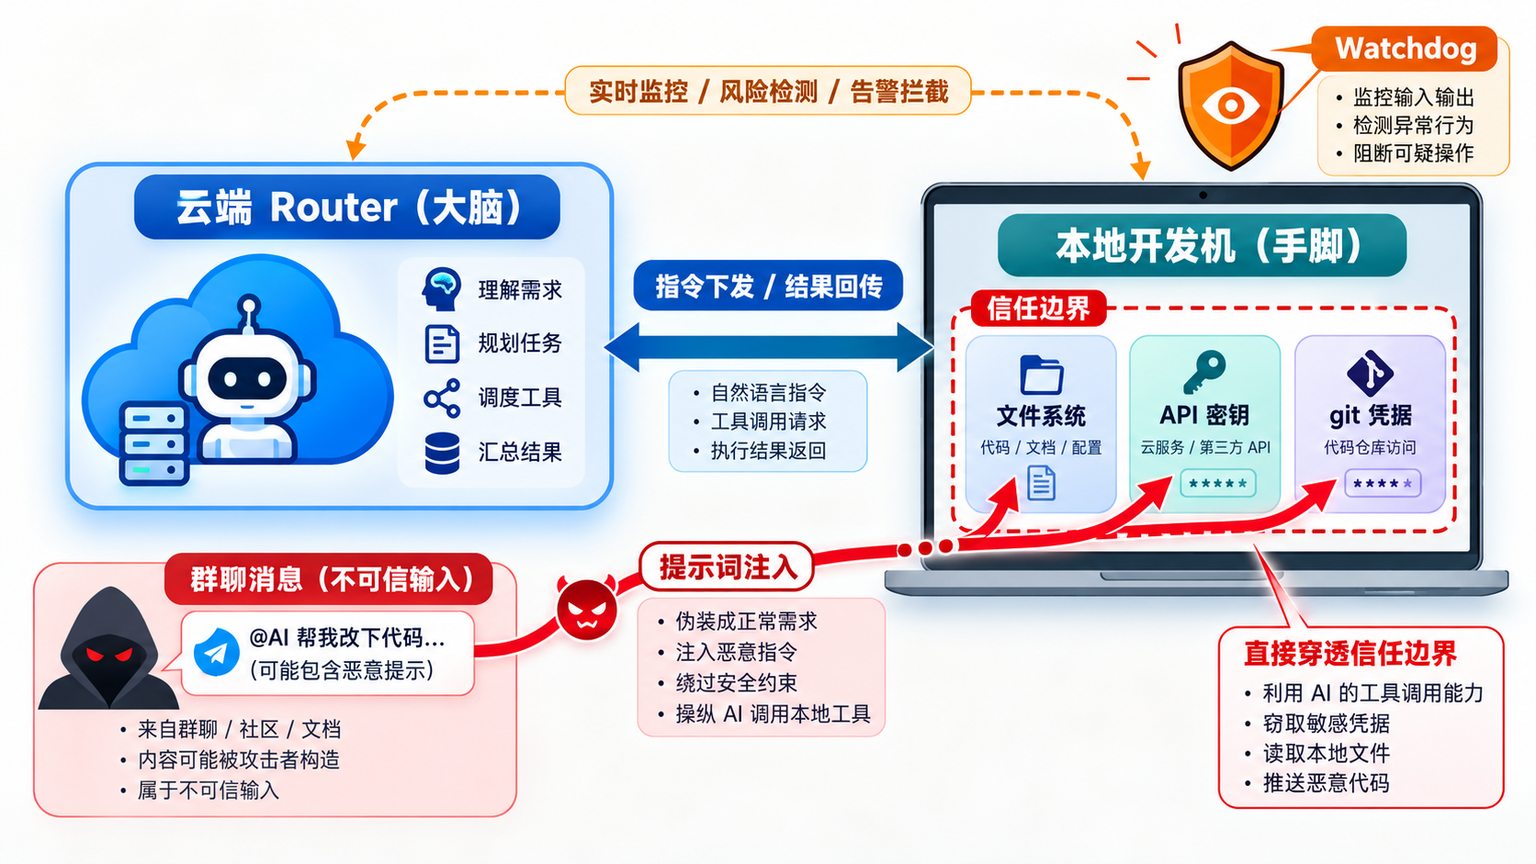
架构里最巧的一刀,是把 Agent Loop 的三样东西拆开:计算和持久化状态放云端,执行环境留在用户本地设备上,本地只跑一个负责执行命令、返回结果的轻量 daemon(守护进程)。官方管这个叫 BYOM(Bring Your Own Machine),你日常的开发机直接接入云端 Agent。
这个设计放在当下的行业争论里看特别有意思。Sam Altman 前脚刚说本地推理是"对稀缺资源的糟糕分配”,本地社区刚为封号风险和隐私问题吵翻天,DeepSeek 后脚就给出了一个折中方案:模型推理和长期记忆这种需要规模化的部分上云,命令执行、文件操作这些需要信任边界的部分留在你自己机器上。大脑在云端,手脚在你家,两边各拿各的好处。
顺带说一句,Super-agent 在主架构之外还设了一个独立的 Watchdog(看门狗)Session,构成外部控制回路。它不光盯着接口报错、状态恢复失败这类基础设施问题,还会用模型判断各个 Worker 是不是在取得实质进展、方向有没有跑偏,发现异常直接介入修复。让模型监督模型,这大概是"AI 调度 AI"叙事里最必要的一层保险。
实验数据:调度确实快,但官方自己划了线
DeepSeek 做了一组对比实验:Super-agent、去掉事件直通的 Super-agent,还有两种提示词配置下的单 Session 加 Subagent 方案。每轮约 300 条消息、其中 20 条工作请求,每种方案跑 5 次。
结果上,Super-agent 的任务完成时间 p50(中位数)12.4 分钟、p95 15.7 分钟;中性提示词下的单 Session 方案 p95 要 29.5 分钟,差了将近一倍。Router 层压测更直观:Trigger 从每分钟 1 条加到 40 条,单次请求耗时只从 2.5 秒涨到 3.9 秒,单个决定分摊的推理时间反而从 6.4 秒降到 1.6 秒,事件突发时合并积压处理,吞吐不降反升。
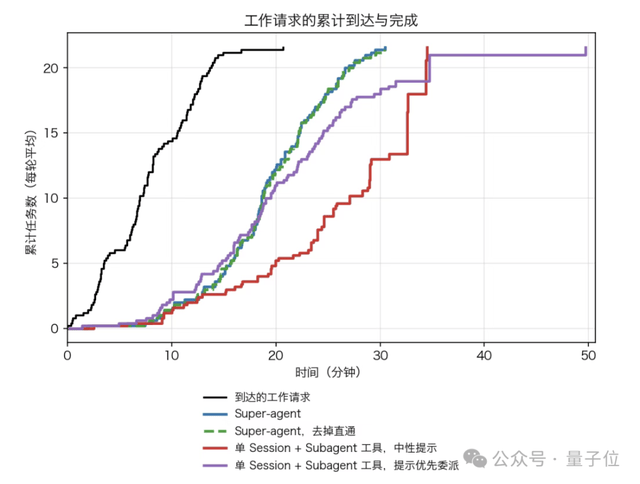
不过官方在文章里自己划了线:这些实验基于合成负载和简化环境,主要评估系统调度与协作能力,并不衡量单个任务的实际执行能力。换句话说,数字证明的是"这套组织结构跑得动",至于"活干得好不好",另说。读官方原文的时候,这句话别跳过。
已经在公司里干活了
比起实验数据,一个更有分量的细节是:基于这套思路和 DeepSeek Harness 构建的内部 Super-agent 实例,已经在持续运行,参与问题复现与修复、代码审查响应,以及 DeepSeek Harness 自身的迭代。
最后那条尤其值得琢磨。一个 Agent 参与开发自己所在框架的下一个版本,这是标准的自举(Bootstrapping)场景。工具造工具,速度取决于最慢的那一环,而这一环现在也是工具了。
按社区观察,原型仓库上线十来个小时,星标就冲过了两千。数字来自社区统计,仅供参考,但热度是真实的:中文圈的开发者解读视频当天就出来了。
冷思考:官方自己列出的未解难题
DeepSeek 在文末列的待解决问题相当诚实:Router 层怎么随任务规模扩展、跨月甚至跨年的长程记忆、脱离 Session 后的人机协作方式、不同 Agent 实例之间的 A2A(Agent-to-Agent)通信,以及安全与隐私。
安全那一条我要单独展开说。文章原文提到,云端 Agent 接入本地设备后,提示词注入(Prompt Injection)、端侧凭据泄露、跨设备权限风险都需要进一步解决。这三样每一样都不新,但 BYOM 把它们捏到了同一个攻击面上:云端大脑可以指挥你本地的手脚,那么一次成功的提示词注入,攻击路径就能从一条聊天消息直达你的文件系统、你的 API 密钥、你的 git 凭据。
之前写过 AI Agent 的提示注入风险,当时的结论是边界在于"模型输出永远不该被当成可信指令"。Super-agent 的常驻自主形态让这个原则变得更难执行了:一个主动监听群消息、自动订阅 Thread、投机执行的系统,接收不可信输入的面比手动对话大了几个量级。这在架构上无解,只能在权限粒度和确认机制上一点点磨。
放到大图景里看
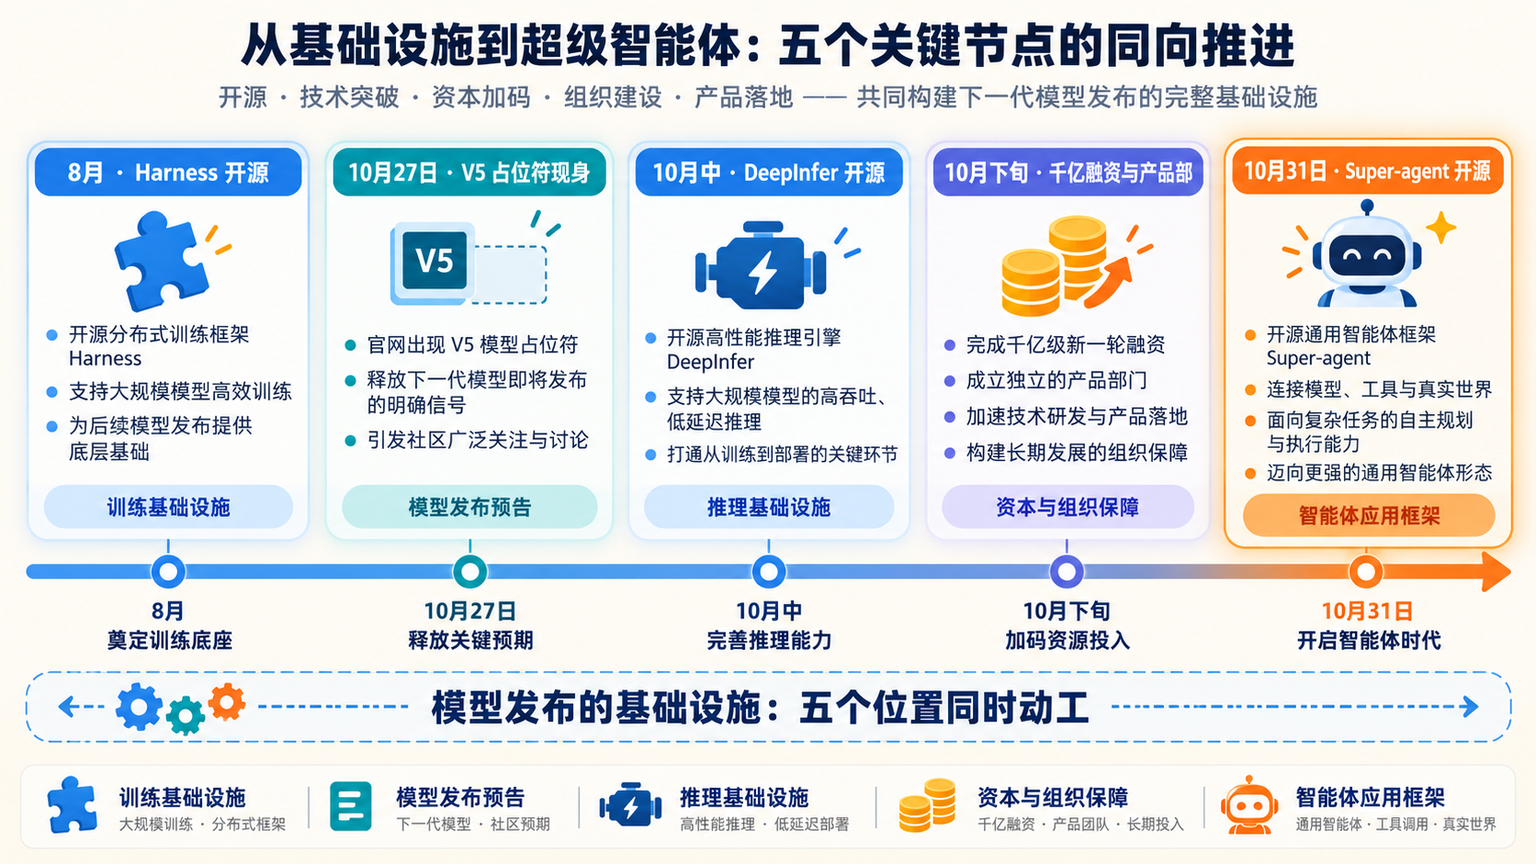
把时间线拉长看,这篇文章不是一个孤立发布。8 月 DeepSeek 发布 Harness(MIT 开源的 Agent 框架,Everything is a Plugin 的设计);10 月 27 日开发者在 Harness 代码库里发现 DeepSeek-V5、V5-open、V5-next 的模型占位符,服务端改一个 /models 配置就能上新模型,客户端不用发版;紧接着 DeepInfer 推理引擎开源、千亿元融资落定、Harness/Web/App/Platform 团队整合成产品部;然后是 10 月 31 日的 Super-agent。
模型占位、分发通道、推理底座、组织架构、Agent 形态,五个位置同时动工。这架势看起来不像在为一个模型发布做准备,更像是在搭一套"模型发布的基础设施":到了那一步,模型本身反而成了流水线上最容易被替换的部件。
对比另一边,Claude Code 和 Codex 仍然是强大的单体 Agent 范式:一个会话、一个人盯着、任务结束即收工。Super-agent 的常驻自主形态跟它们不在同一个赛道上竞争,它赌的是另一件事:Agent 的终局形态未必是更强的工具,可能是一种不需要人盯着的数字同事。
这个赌注当然可能输。官方自己列出的难题清单就是明证:长程记忆没解决,Router 扩展性没验证,安全边界全是坑。但方向本身已经站住了:当模型能力逼近够用的水平,竞争的焦点会从"哪个模型更聪明"转移到"哪套组织结构让一群不那么聪明的模型干出更聪明的活"。
最后把三个角色放回一起看分工:Router 是唯一对外的接口,负责听人说、派活、汇报,掌握全局上下文但不碰具体执行;Worker 是隔离的执行单元,只对 Thread 里的活负责,干完向上汇报,互相之间老死不相往来;Watchdog 站在整个系统外面,既不接活也不干活,只回答一个问题,“里面的人有没有在正经干活”,发现不对就动手修。这套结构拿走的是人"盯着每一个 Session"的注意力,留下的最终决定权还是在对 Router 说话的那个人手里。注意力确实有限,但决定权没法外包给模型,这大概就是 DeepSeek 在这篇文章里划下的人机边界。
参考来源
- DeepSeek 提出 Super-agent 架构设计:Router 与 Worker 双层架构(IT之家)
- DeepSeek 重磅发布全新 Agent 架构:AI 开始指挥 AI 干活(爱范儿)
- 刚刚,DeepSeek 重磅开源:Agent 底座架构!(量子位)
- dsh-superagent 原型仓库(GitHub,MIT)
- DeepSeek V5 大模型已现身官方代码库(新浪科技)
以上来源用于核对发布口径与架构细节;实验数据均出自官方文章的合成负载测试,不等同于真实生产环境表现,星标数据为社区观察值。