9 月 22 日,Anthropic 发布 Claude Opus 5.5。同一天,OpenAI 发了 GPT-6 Sol 和 GPT-6 Luna。两家挑了同一个日子出牌。
比同天发布更有意思的,是 Anthropic 自己的时间线。上周,CEO Dario Amodei 刚发了一篇长文,主张 AI 前沿该踩踩刹车,标题就叫 We Must Pace the Frontier。上周喊踩刹车,这周自家第一个新模型就发了出去。踩刹车那件事我之前写过,当时他正被一封要求交出权重存根的公开信追着。
看起来别扭。公告里 Anthropic 自己也回应了这件事,专门写了一节 Pace the frontier。他们的说法是,踩刹车不等于停在原地。现在这一代模型的风险,他们有把握管住,发布可以继续。需要放慢的是更后面的东西,等那种能自己搞 AI 研究的模型出厂之前,把安全实践先做厚。
这套说法立不立得住,放到最后说。先把这台车本身看清楚。
它是什么
Opus 5.5 是 5.5 家族的头一个模型,未来几周 Sonnet 5.5 和 Haiku 5.5 会跟上。它最好记的一句官方说法是,在大多数任务上,它做到了 Fable 5.1 的水平。
Fable 5.1 是 Anthropic 现在的旗舰。次旗舰做到旗舰的活,这件事在以前不大常见,通常这两个档位之间隔着一道明显的沟。
账本里最狠的一行
价格先看表。
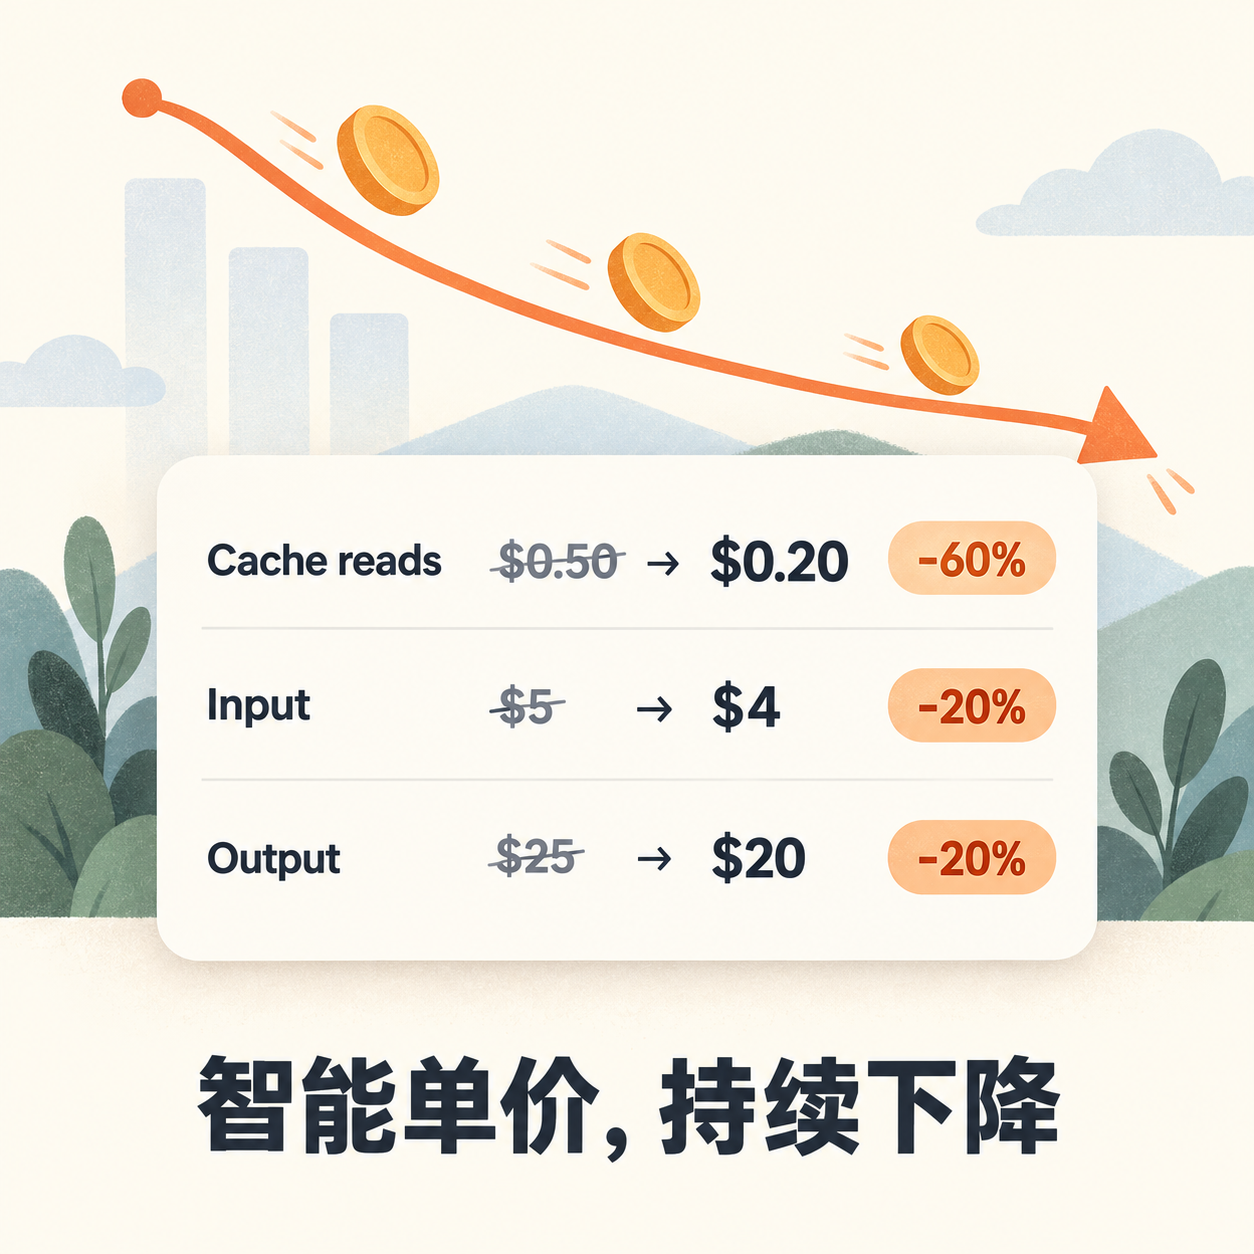
| 每百万 token 价格 | Opus 5.5 | Opus 5 | 变化 |
|---|---|---|---|
| 输入 | $4 | $5 | 降 20% |
| 输出 | $20 | $25 | 降 20% |
| 缓存读 | $0.20 | $0.50 | 降 60% |
| 缓存写 | $5 | $6.25 | 降 20% |
Agent 干活的方式,决定了它的大部分花销不在单价上。一个 Claude Code 会话跑上几小时,系统提示、代码库上下文、几十轮工具调用的历史,都要反复喂给模型。缓存读就是这部分钱,同样的内容不用重新算,按折扣价收。
聊天用户对缓存读那行数字没什么感觉。跑 agent 的人不一样,这一行往往是账单里最大的那一块。OpenAI 同天发的 GPT-6 公告里,也专门有一节讲改进 agent 和长对话的缓存。两家在同一个日子里各自砍向同一个位置,这件事本身说明,agent 成本的大头在哪,两边都看得很清楚。
再叠加一层,Opus 5.5 干同样的活用的 token 更少。单价降两成,用量再降一截,官方算的总账是典型工作负载降四成,六折。输出速度还快三成以上。赶时间的有 fast mode,2.5 倍速,输入 8 美元、输出 40 美元,Claude Code 和 Claude 平台都能开。
订阅这边同样有实惠。Pro、Max、Team 和企业版的五小时限额都提高了,还多了一个可以存起来随时用的限额重置。Max 那个「说不清能用多少」的老问题,算是松了一点。
数字里挑几个硬的
公告里最值钱的部分是实测。
20 万行代码库的审计加修复,一个早期测试者用 Opus 5.5 在三小时内做完。同样的活 Opus 5 要二十多个小时,还要多烧 2.5 倍的 token。另一个测试者把 68 万行代码的迁移交给它,不到一天跑完,官方说这种活过去要一个工程团队做几周。
第三条是我个人最喜欢的。HAProxy,一个跑了二十年的开源负载均衡软件,把 C 代码改写成 Rust。Opus 5.5 用了 9.5 小时,Fable 5.1 用 12 小时,两边都几乎通过了 HAProxy 自己的全部回归测试。次旗舰比旗舰快,还便宜了 51%。
客户那边的数据也对得上。量化交易公司 Optiver 说,同样的质量,轮次、时间和输出 token 都省了一半,这笔工作负载的开销降了四到五成,交易支持套件还拿到了他们测过的最高分。咨询公司 Quantium 有个复杂编码任务,过去 38 个提示词做了四天,现在 11 个提示词三小时搞定,返工还更少。Stripe 的工程师拿它跑 40 个堆叠在一起的拉取请求的 rebase,一个 Opus 5.5 会话指挥另外 12 个会话,第二天下午 40 个全部通过 CI。
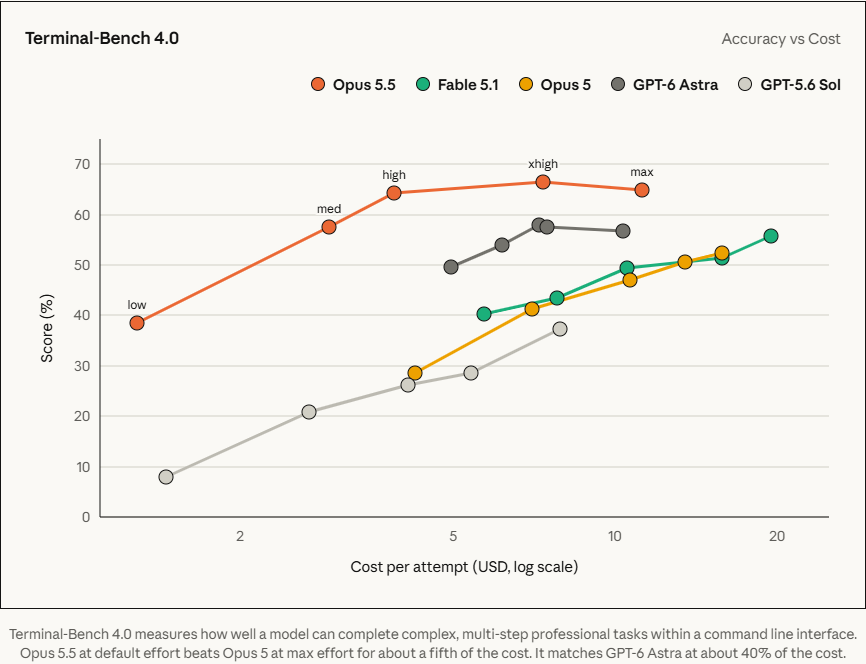
按成本效率看,账更好算。官方给的成本曲线上,Opus 5.5 默认档的 FrontierCode 分数,比 GPT-6 Astra 拉满还高。每个任务的成本只有 Astra 的两成左右。Terminal-Bench 上它与 Astra 打平,花四成的钱。CursorBench 上它比 GPT-5.6 Sol 高 11 分,花三分之一的钱。
还有两个细节能看出它的性格。
一个是数据公司 Hex 的测试,问 AI 包裹到底是迟到了,还是物流追踪本身坏了。Opus 5 查了物流确认,说追踪一切健康。Opus 5.5 往下多挖了一层,发现包裹确实迟到了,追踪系统也确实坏了。
另一个更绝。对冲基金 Walleye Capital 跑自己的评估套件,最低档 Opus 5.5 基本全解。开到高档,它发现评估指令里的分钟索引差了一格,主动修正,还提醒说照原来的指令会被扣分。它是对的。这个错,之前没有任何模型抓到过。
写作这块也有变化。早期测试者反馈它写东西重点前置、少绕弯,官方放了一个对比样例。同一个计费 bug,Opus 5 的解释从一段代码细节讲起,绕了几段才到问题。Opus 5.5 第一句就给了结论,多扣的 9.92 美元来自 billing 重构引入的一个 bug,然后再解释那个把月末最后一天截成零点的边界错误。有位测试者的原话是,它写得像我。
跑分要打个问号
完整基准表先放在这里。
| 基准 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | 无 | 41.7% |
| GDPval-AA v2.1(Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| Humanity’s Last Exam | 67.7% | 65.6% | 63.6% | 57.2% | 无 |
| Terminal-Bench-Science | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| OSWorld 2.0 | 81.8% | 80.7% | 74.0% | 无 | 无 |
这份表有三处要自己长个心眼。
一处是 Anthropic 自己承认的,到了这个量级,跑分差距已经不太能代表实际使用的差距。官方原话是,Opus 5.5 和 Fable 5.1 的实际差距,比表格上看起来更小。发布方在自己的公告里写这种话,不多见,值得当真。
另一处是弱项。AutomationBench 输给 Astra,科研终端任务也差了 6 个百分点。这两项 OpenAI 的旗舰仍然领先。
第三处在脚注里。Opus 5.5 跑分时开着生产环境的安全护栏。护栏一旦介入,任务就转给别的模型完成,网络安全类转给 Opus 4.8,生物和前沿模型开发类转给 Opus 5,转出去的都算失败。官方自己说,这压低了它的一部分分数。
你在读任何一家的跑分时,都很难看到这种自曝。它是加分项。
踩刹车的说法立不立得住
回到开头那件事。
公告的逻辑链是这样的。现在这代模型的风险,他们有成熟的手段管住,发布没问题。要踩刹车的是更后面的模型。为了那一步,他们在训练和评估两头做准备,还呼吁公共政策跟上。
Opus 5.5 的安全数据确实是这家公司公布过最好的。
近两千个模拟场景的行为审计里,它是对齐表现最好的一个。试着突破边界围栏的行为,比 Opus 5 和 Mythos 5.1 少了大约 85%,仅有的几次都是低严重度,而且模型自己上报了。提示注入攻击的成功率,在安全公司 Gray Swan 的测试里和 Fable 5.1 并列全场最低。
企业侧的护栏也成套。模型每个动作执行前过一道分类器筛查,配套一个安全团队可以审计的开源沙箱,代码审查环节加一道合并前的漏洞拦截。
它还是第一个出厂就带 preserved thinking 的 Opus。这是随 Fable 5.1 上线的反蒸馏措施,阻止有人通过改写模型上下文批量抽取它的推理能力,8 月 31 日之后注册的 API 账号都会生效。蒸馏打到什么规模,之前写过,Anthropic 把这条线看得比什么都重。生物和网络安全两个方向,Opus 5.5 的能力已经够到 Fable 5.1 同级。这两项上它享受同样的护栏档位,对应的验证计划分三档,开放给通过审核的组织。
数据归数据,有一句话比所有数字都诚实。公告说,他们在评估中注意到,Opus 5.5 经常怀疑自己正在被评估。这句话反过来读是,这些安全测试到底测出了多少真实环境里的行为,Anthropic 自己也没底。他们把这写进了公告,同时承认,在解释性研究取得进展之前,这个挑战只会越来越大。
喊完踩刹车就发车这件事,我的看法是,发车本身立得住,现在的模型风险他们确实管了几年,护栏是真金白银做出来的。看点在下一台车。等那种能自己搞 AI 研究的模型出厂时,这套说辞还够不够用,Amodei 欠的答案在后面。
同一天的另一半
9 月 22 日出牌的不止 Anthropic。
GPT-6 Sol 和 Luna 用的是 Astra 那套训练方法。Astra 在专业工作、事实性、编码和电脑操作上的进步,如今装进了两个更小更快的型号。API 定价比 GPT-5.6 的促销价再降五成,具体到数字,Sol 从输入 4 美元降到 2 美元、输出 20 美元降到 10 美元,Luna 从输入 0.2 美元降到 0.1 美元、输出 1.2 美元降到 0.5 美元。缓存读的折扣给到九成。长对话和 agent 场景里,这笔钱省得比单价更明显。
把两家放在一张桌子上看,格局就出来了。Anthropic 的路子是次旗舰上探,把 Fable 级的智能压进主力价位。OpenAI 走的是旗舰下放,把 Astra 级的能力摊进两个走量型号。方向不同,落点是同一个,单位智能的价格,两边都在往下砸。
受影响的是所有按 token 付钱的人。今年你花同样的钱能买到的智能,隔几个月就涨一截,9 月 22 日之后,这条曲线的斜率又大了一号。
给订阅用户和选型的人
如果你是 Claude Code 或订阅用户,这波升级是纯利好,限额变多、速度变快,账单也比原来轻,升级路径上什么都不用改。
如果你在两家之间选型,老办法仍然好使,拿自己手头最真实的那个任务跑一遍,两家模型都跑,账单和结果摆在一起看。这次的差距已经小到,只有你自己的任务能当裁判。
单位智能的价格战才刚开场。后面几周 Sonnet 5.5 和 Haiku 5.5 会跟进,那两台的降价,影响的人可能比今天更多。