9 月 23 日,Anthropic 官宣了一件事。近 950 个 Claude agent 组成的集群,在巨大的 DNA 序列数据库里跑了 21 个小时、烧掉 2.1 亿 token 之后,其中一个发现了数据里的异常重复模式,标记给人类复核。后续分析和湿实验室1测试确认,那是一个此前没人表征过的酶系统,藏在噬菌体的基因里。
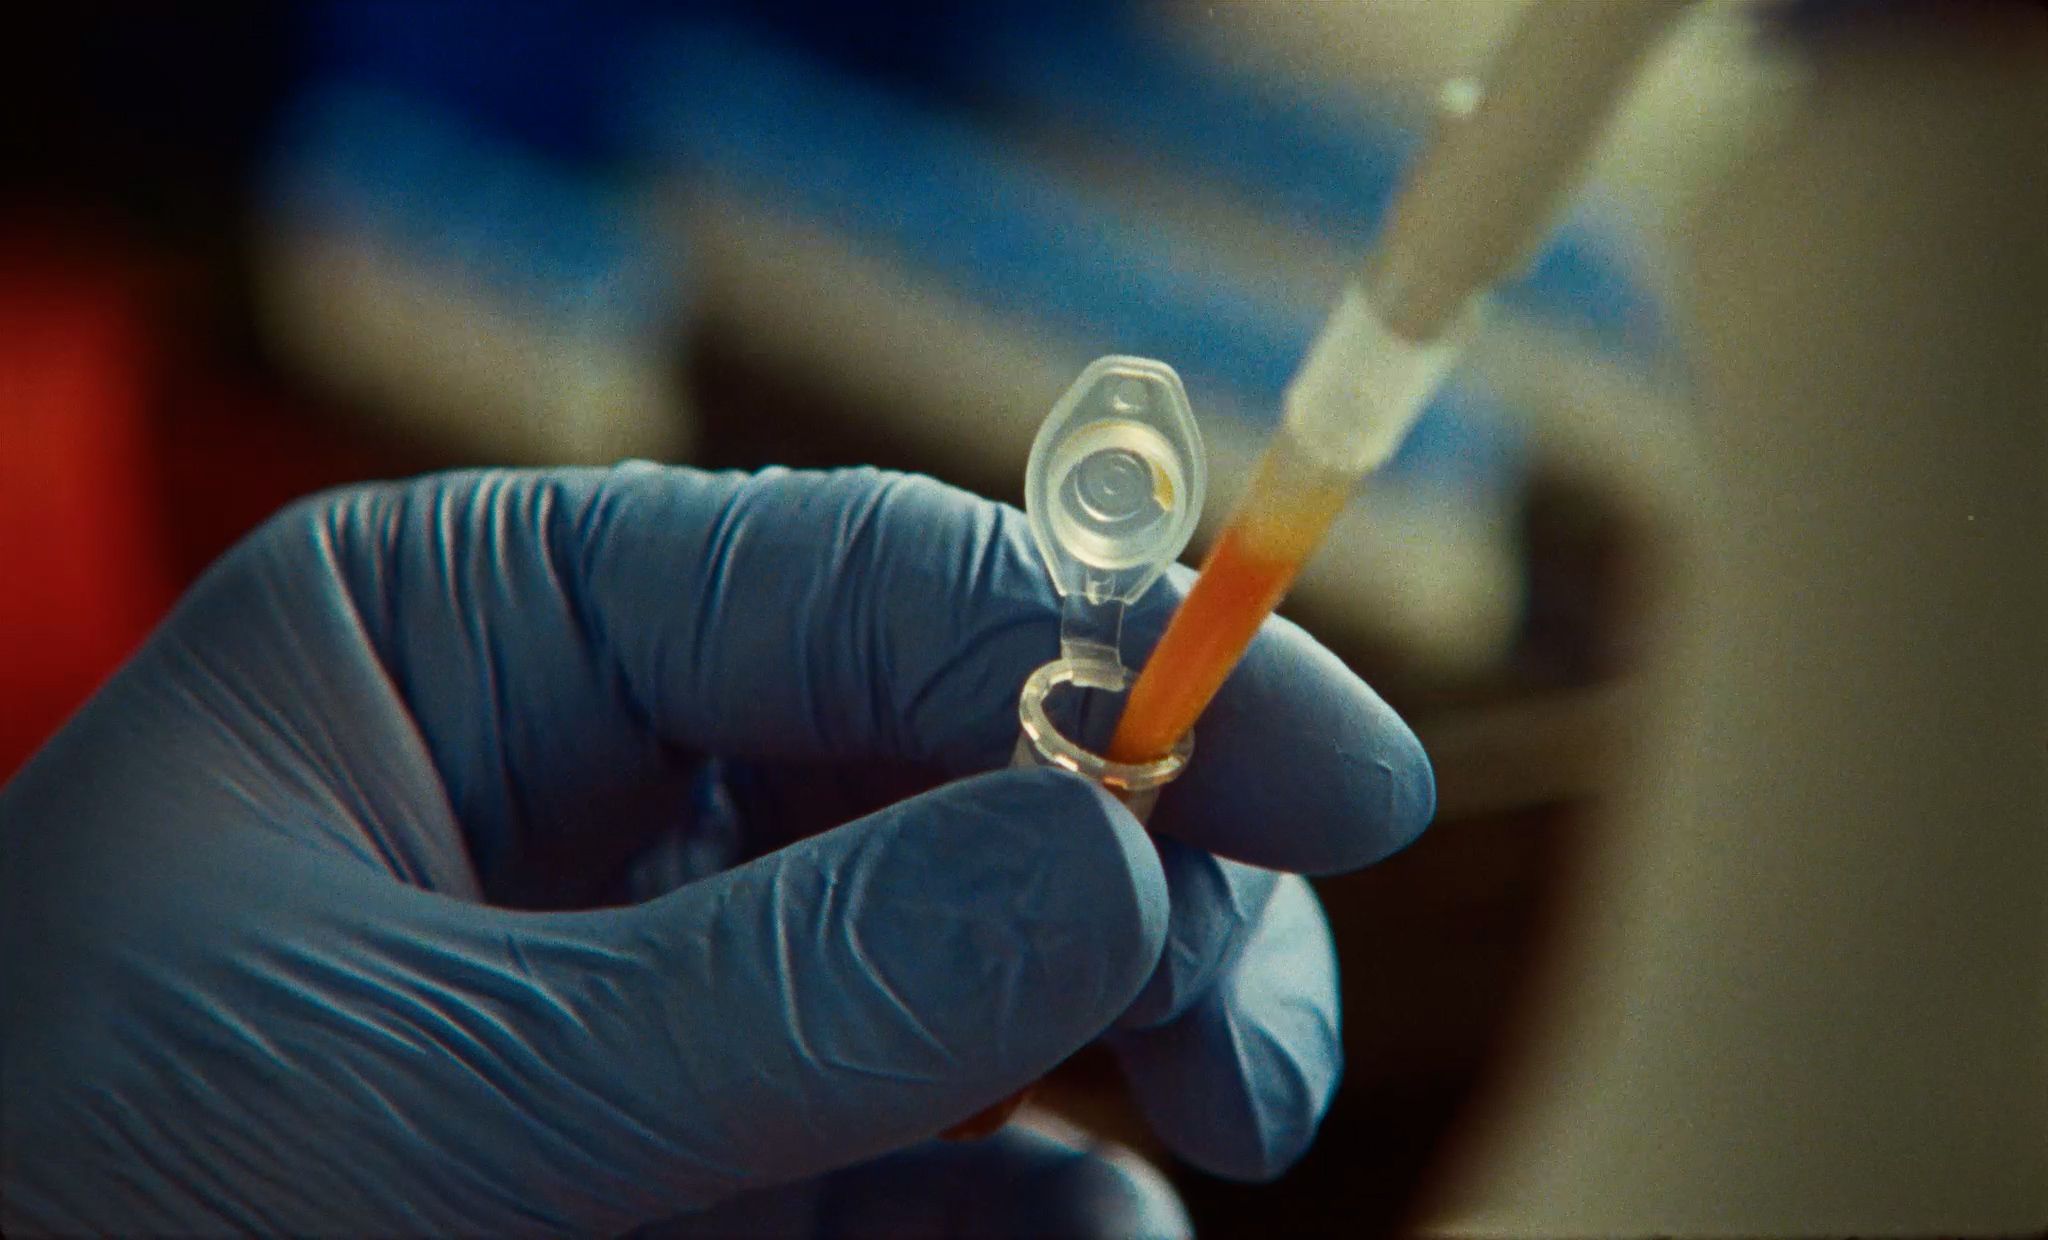
噬菌体是感染细菌的病毒。这个新系统被命名为 ART,全称 array-associated reverse transcriptases,阵列相关逆转录酶。Anthropic 说它的结构让人想起 CRISPR 背后的机制。消息出来当天,Hacker News 把它顶到了榜首,459 条评论吵成一团。
先把发现本身讲清楚,再说这场热闹里我在意的部分。
ART 是个什么东西
先补一点背景。CRISPR 是现在最强的基因编辑工具,原理来自细菌的免疫系统。细菌会把入侵病毒的 DNA 片段存成一份份重复序列,像办案档案一样排在基因里。下次再遇到同样的入侵者,就按图索骥把它剪掉。科学家借用这套系统,学会了给基因做精准手术。
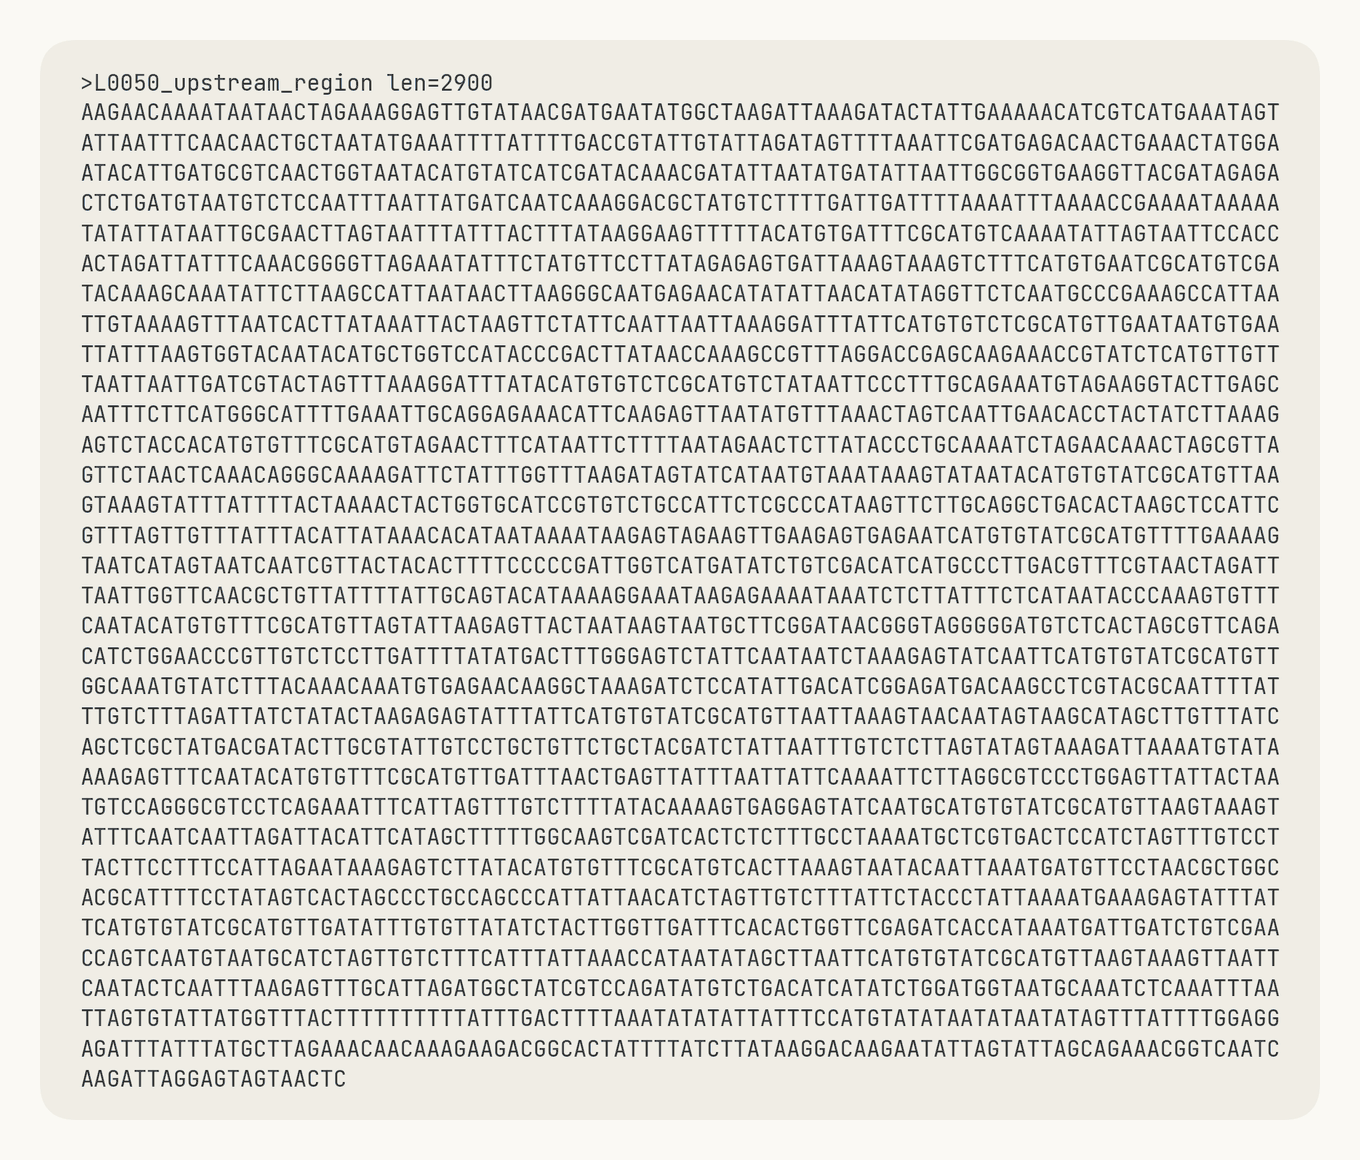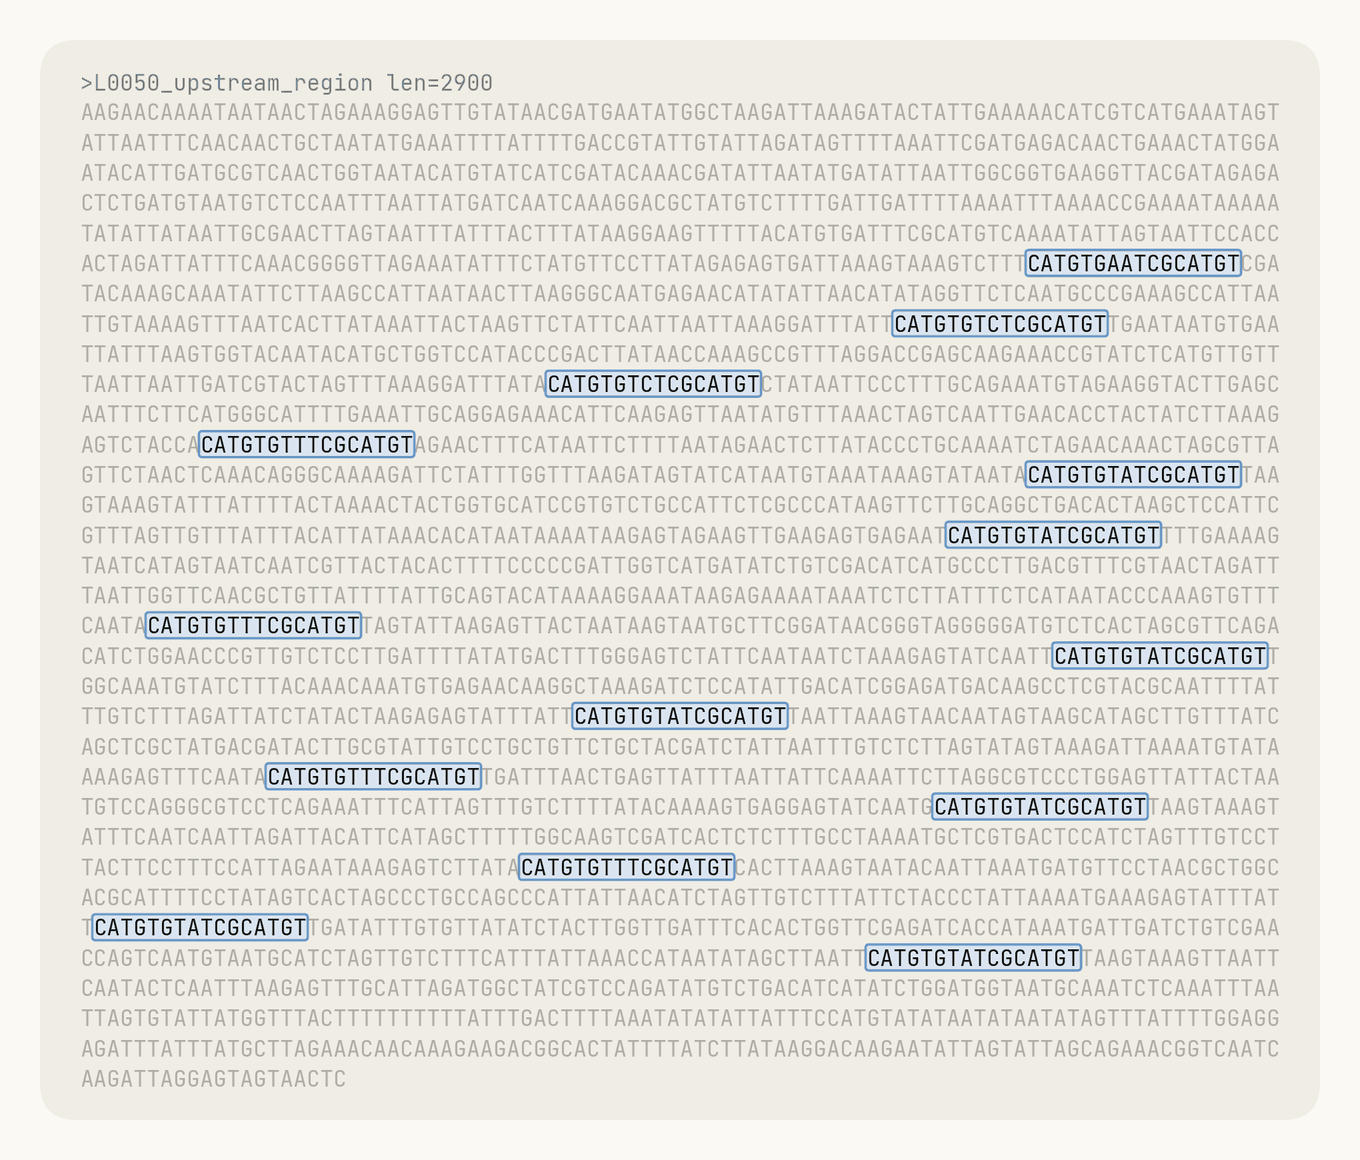
ART 的相似之处在架构。它也是一套围绕逆转录酶搭起来的系统。逆转录酶是一种把 RNA 拷贝回 DNA 的酶。在 ART 旁边,Anthropic 的团队观察到一长串重复的 DNA 序列,排列方式像极了 CRISPR 里的档案结构。系统里还伴生着一个功能不明的蛋白质。
按 Reuters 的报道,这套逆转录酶本身在以前的研究里出现过。新的地方在系统层面。Claude 是第一个认出整套系统关键特征的,那串非编码 DNA 阵列,还有那个多余的蛋白。零件早就摆在库房里,是 Claude 把它们认成了一台机器。
这个区别不大,也不小。数据库里的原始序列人人都能下载,认出一个孤立的酶和认出一套系统,中间差的是「往哪个方向看」这件事。科学研究里最贵的一步,是知道往哪里看。看本身不要钱。
流水线比结论更值得看
Anthropic 给出的过程是这样的。agents 先从数据库里收集了超过 20 万个逆转录酶,挑出 3500 个新候选系统,再收窄到 20 个最有说服力的候选,逐一写成人类可读的报告。官方说这种分析让专家科学家来做,一个候选就要花数周到数月。近 950 个 Claude agent 并行扫了 21 个小时,吃掉 2.1 亿 token。中途有一个 agent 发现了一段不寻常的重复模式,它当时的原话被原样写进了官方博客,「RT 旁边的 DNA 太惊人了,我肉眼就能看到一串串联重复阵列……那是个类 CRISPR 的……重复阵列?!」接下来的分析和湿实验室1验证由人类科学家完成,确认了这个系统真实存在,并且确实是新东西。
公司对科学家角色的描述是,只参与了初始 prompt 和实验室工作。中间那 21 个小时,是 agent 集群自己跑的。
我在这件事里最在意的就是这个结构。过去两年我们看过的「AI 帮助科学发现」,多数是模型当工具,人提出假设,模型帮忙算或者帮忙筛。这一次的分工反了过来,假设的产生也交给了模型集群,人退到了两端,一端出题,一端拿湿实验室验证真伪。中间的探索过程,人的位置是等待被通知。
还有一个细节值得单独拿出来说。那个发现异常的 agent 是自己决定「这个东西不对劲,值得让人看一眼」的。挑出这一个的,是品味,检索给不了这种判断。数据库里能标记为异常的模式成千上万,从里面挑出值得人花时间的那一个,现在没有任何基准测试直接衡量这种能力,它恰恰是科研里最稀缺的东西。
当然要泼一盆冷水。找到了不等于看懂了。Anthropic 自己承认,ART 到底在细胞里干什么,他们还在研究。类 CRISPR 的类比是官方自己做的,从「结构像」到「能当基因编辑工具用」,中间隔着从基础研究到工程应用的整条路。CRISPR 从被发现到拿诺贝尔奖,中间隔了七年,从发现到真正编辑人类基因,隔得更远。
湿实验室、IPO 和一场提前的发布会
把镜头拉远一点看,这个发现的发生时机很巧。
几天前,Reuters 刚报道 Anthropic 在旧金山湾区悄悄建了一间湿实验室。这次官宣里,Anthropic 顺水推舟地确认,ART 正是这间实验室产出的第一个成果。公司同时在推进生命科学验证计划,想把学术界、初创公司和药企的科学家拉到自己的平台上来,药物发现是被点名要进入的领域。The Verge 还补了一句背景,Anthropic 正在筹备上市。
时间线拼起来,这次发布里,科学通报的成分少,能力证明书和招商广告的成分多。湿实验室是真金白银建的,证明自己玩真的。自主发现是现成的案例,证明 Claude 有科研能力。IPO 窗口期,这两样东西讲给投资人听,也讲给科学家听。
The Verge 的报道里有一句话很直白,说这是一次「承认过早的公告」。这个批评成立。功能都还没弄清楚的系统,发布会先行,科学上确实急了点。Anthropic 自己的解释是要早点分享,既展示能力,也让社区看到他们在做什么。翻译过来就是,宣传的优先级排在了研究的前面。
不过我对这件事的观感没有那么差。科学史上先抢发布再补证据的例子不少,这次至少完成了湿实验室验证,发现的系统是真实的,数字和过程都摊开给了公众。比那些拿「AI 猜对了论文结论」当成果的营销,这一份的含金量实打实高出一个量级。值得警惕的是那个先例,今天用「早点分享」解释功能不明的发布,明天就可以用同一句话解释更草率的东西。
还有一个独立的信号值得记录。CRISPR 基因编辑的先驱之一、MIT 和 Broad 研究所教授张锋看了预印本之后评价说,这是 AI agent 参与生物发现的一个激动人心的例子,逆转录酶相关 RNA 重复阵列的识别确实引人入胜,值得进一步研究。批评归批评,这个领域最有资格打分的人之一,没有摇头。
两条路线,同一个动机
同一天还有一个对照。OpenAI 在数学上的推进接近横冲直撞,先是不顾学界传统直接公布了千禧年大奖难题的进展,引发了数学圈的抗议,随后又邀请顶尖数学家组成小组,教它怎么在学界不把事情搞砸。
两家公司选的赛道完全不同。OpenAI 挑了数学,paper 便宜、验证快、话题性强,代价是踩了学术共同体的规矩。Anthropic 挑了生物,湿实验室贵、周期长、门槛高,但一旦出成果,故事完整得多,因为分子生物学的事实不跟你争论,实验跑了就是跑了。
动机是一样的。模型的训练成本摆在那里,API 降价卷成红海,家家都需要证明一件事,自己的旗舰模型能产出钱以外的东西。科学研究是这个时代最有说服力的证明,既烧出了护城河,又攒下了声誉。可以预期,接下来每家头部实验室都会给自己配一间湿实验室或者一支数学战队,就像互联网大厂当年纷纷宣布造车。
回到那个悬而未决的问题
昨天写 Opus 5.5 的时候,我在结尾留了一句话,等那种能自己搞 AI 研究的模型出厂时,Anthropic 的那套安全说辞还够不够用,Amodei 欠世界一个答案。
今天这个发现不算那个答案。950 个 agent 扫数据库找模式,离「AI 自己提出并验证科学假说」还差着几步,ART 的发现流水线里,出题和验证仍然是人。但它是那道题的第一个部分解。当一个模型集群可以在 21 小时里替人类看完一座数据库,并且知道哪一块值得叫醒人类的时候,「AI 研究自动化」就不再是一个纯假设了。
比安全叙事更快到来的,是能力叙事。这一周 AI 行业的局面差不多就是这样,护栏的公关和能力的实绩在同一个星期里赛跑,谁先撞线,暂未知。