这篇文章基于 DeepInfer 的 GitHub 仓库、36氪与搜狐的中文报道、X 上的社区争论整理写成。事件发生时间是 10 月 20 日,文中 GitHub 数据为 10 月 30 日;「每日服务 155 万亿 Token」为 DeepSeek 官方公告口径(经二手转述核对),文中另有标注处为未经官方确认的传闻。
十天前,DeepSeek 干了一件当时没什么人立刻消化的事:把它线上业务正在用的推理引擎,原样放上了 GitHub。
消息是 10 月 20 日官宣的。开源的不是又一个 demo,也不是一个精简版实验框架,而是支撑它自家产品线大规模服务的那个引擎。协议 Apache 2.0,没有附加条款。
消息当天就在发酵:仓库一夜之间过了 1.2 万星,Hacker News 上的讨论帖冲上 2000 多点。36氪的措辞是「令全球 AI 界震惊的公告」。
到今天我写这篇文章时,仓库停在 24.2k 星、2.9k fork。热度不是问题,问题是这十天里围绕它吵出来的两场架:一场关于它和 vLLM 的关系,一场关于「这到底算不算开源」。
我把仓库从头到尾翻了一遍:两场架的答案都写在 README 里。
DeepInfer 是什么来头
DeepInfer 是 DeepSeek 的内部推理框架,负责把它家模型(当前默认指向 DeepSeek-V4.1-Flash-1017)大规模地喂给用户。按官方公告的说法,这套系统每天要服务 155 万亿 Token 的调用量(此数字为公告口径,经二手报道核对)。36氪的描述更直白:这是支撑其线上大规模推理业务的内部原生推理框架,「完整开源」。
为什么这件事值得惊讶?因为对一家靠 API 便宜出名公司来说,推理引擎就是那台印钞机的心脏。DeepSeek 在业内的价格屠夫人设,很大程度建立在把大模型服务成本打到地板价的能力上,而这个能力的大部分,就封装在这套框架里。
现在印钞机的心脏被摆上了货架,任何人都可以拿走。
开源了什么,没开源什么
翻 README 的时候,最该细读的部分不是性能数字,而是它明确写出的边界。
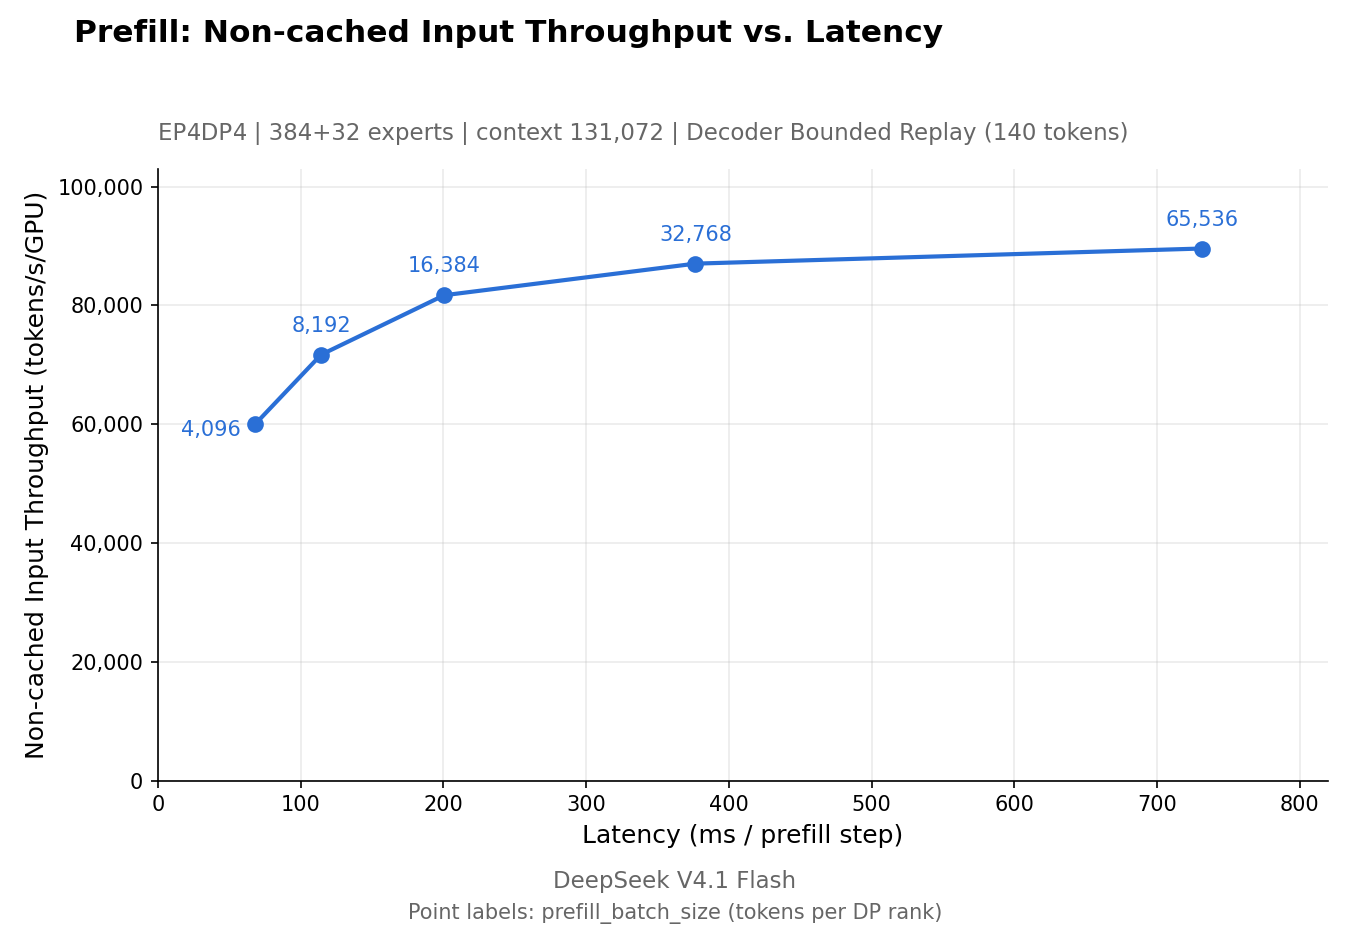
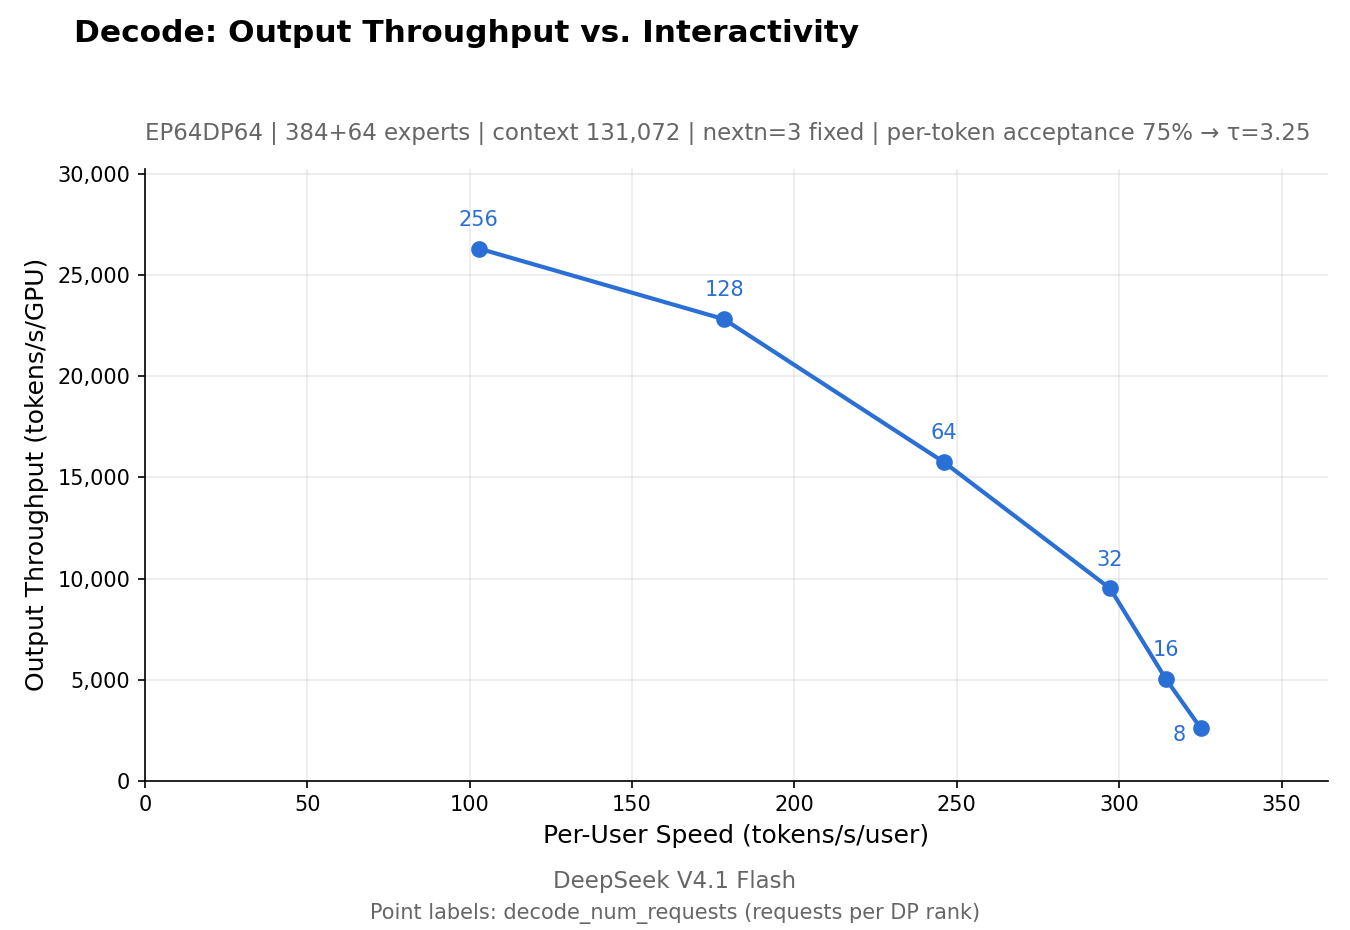
开源的部分:推理引擎本体。结构化输出支持(正则、JSON schema、EBNF 语法约束)、可复现采样(固定 seq_seed)、离线推理示例、完整 benchmark 复现脚本。README 还给了性能 pareto 图:prefill 测在 4 张 SM100 上,decode 测在 64 张上,都在单个 scale-up 域内,配套 run_sweep.sh 可以自己跑一遍验证。
没开源的部分,README 也一样坦白。要搭起一套完整的在线推理服务,还差三样:KV cache 系统、Prefill/Decode 分离部署、跨数据并行副本的负载均衡。README 原话是「not included in this release」,同时补了一句「most required engine functionality is already implemented」。意思是:引擎的核心能力在,但把它们串成一套高可用服务的胶水,你得自己写,或者等后续版本。
这个边界划得很有意思。打个比方:DeepSeek 开源的是发动机,不是整辆车,也没有附赠加油站。懂行的人拿去能拼出车来,不懂的人下载完大概只能看 readme。
还有一个容易被略过的细节:硬件支持列表里,NVIDIA SM100 旁边写着华为 Ascend 950 NPU。构建依赖分两套:CUDA 13 和 CANN 9.2。一家中国头部模型厂商的开源推理框架,第一天就带着完整的国产算力栈适配,这个信号不需要多做解读。
vLLM 之争,README 自己结了案
开源当天就有人问:DeepInfer 是不是 vLLM 的 fork?
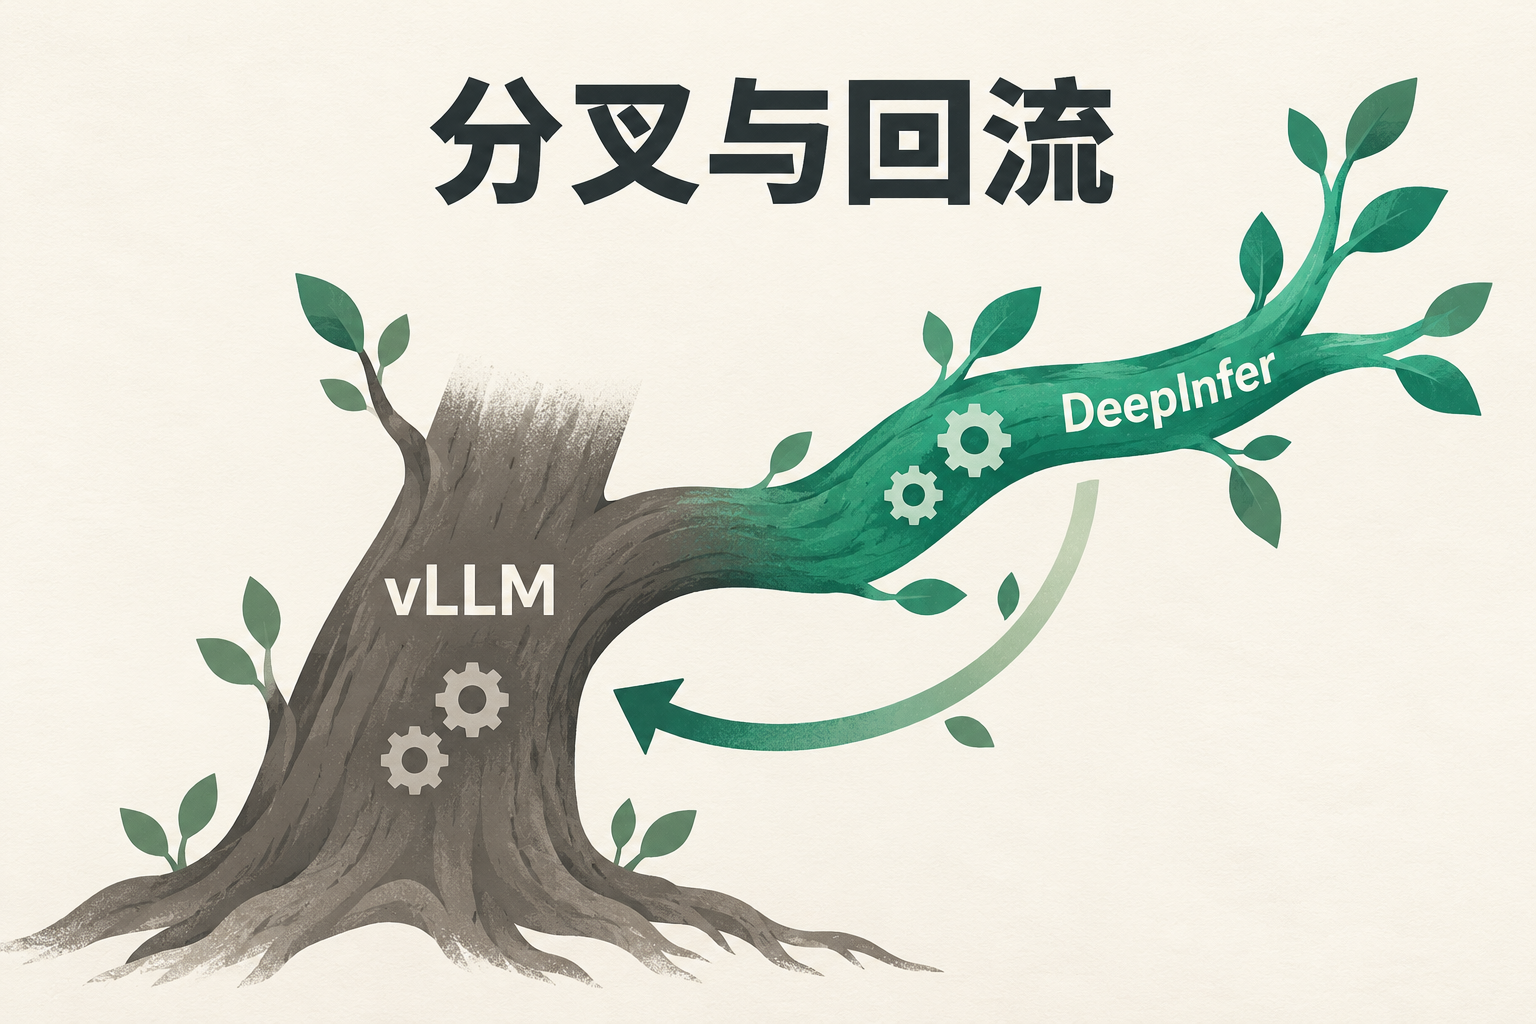
这个问题在 X 和 Reddit 上吵了几天,有认真分析依赖树的,也有直接开嘲讽的。我把仓库翻完发现,DeepSeek 自己在 README 的致谢段落里把答案写好了,原文是:DeepInfer 最初主要基于 vLLM 构建,同时从 SGLang 和 TensorRT-LLM 获得了额外启发,并感谢这些项目的开发者。
这段致谢至少说明了三件事。
第一,fork 关系是事实,而且官方大方承认了。第二,这不是简单的 fork。基于 vLLM 起点、按自家模型和硬件深度改造之后,代码已经走向了不同的方向,vLLM 社区的维护者也确认过两边早已分岔。第三,协议上没有任何问题:vLLM 本身就是 Apache 2.0,拿去改、拿去商用、不再回馈上游,都在许可证允许范围内。
第三点背后还有一层循环。vLLM 是 UC Berkeley 起家的开源项目,全球无数公司拿它做生产底座,其中不少(包括 DeepSeek)在上面做了大量私有强化。这些强化过去都锁在公司内网里,现在 DeepSeek 把自己那份丢回了开源世界,带着昇腾适配、超大规模生产验证,还有为自家 MoE 模型做的极致优化。
对 vLLM 上游来说,这算 positive externality 还是生态分流,短期内不会有答案。但一个可以观察到的事实是:开源推理框架这个赛道的竞争强度,在 DeepInfer 出现后明显升了一级。原本是 vLLM、SGLang、TensorRT-LLM 三家分立,现在模型厂商开始把自己的生产引擎直接摆上桌,SGLang 的生态位(低成本推理、并行部署)受到的挤压最直接。
「假开源」口水战,吵错了吗
第二场架更热闹。
一位十万粉的 X 博主 Alex Veremeyenko 发帖吐槽,大意是:DeepSeek 新模型 V4.1-Flash 对外说成开源,其实算不上:权重能下载、能商用,但训练数据、训练脚本都没放出来,普通人也没法在笔记本上跑,只能叫开放权重(open weight),不该叫开源。
这条帖子收到 500 多条回复、36 万次查看。有意思的是社区的态度:几乎一边倒地怼他。有人说能免费商用已经很香还要索要训练数据太贪心;有人反讽「照这个逻辑软件开源得把脑子也一起开源」;也有人指出术语漏洞:模型能不能在笔记本上跑,和是不是开源没有关系,开放权重本来就是行业常态。
单看这场对线,Alex 输得不冤:他既用错了靶子(把模型权重的开放程度和推理框架的开源混为一谈),也低估了「开放权重是行业惯例」这个共识的稳固程度。
但把这场架放进更长的坐标系里,有一个问题它没吵到,但更该单独拎出来。
DeepInfer 的 main 分支,到今天只有 5 个 commit。最新的一个是 10 月 25 日合入的环境变量解析修复。与此同时,仓库挂着 195 个 open PR,几乎没有处理迹象。
这个组合说明的是:这是一次代码倾倒,而不是一个持续运营的开源项目。社区的热情(24.2k 星、2.9k fork、大量 PR)涌进来,仓库那头的回应却接近于零。
我无意指责 DeepSeek「不负责任」,没有任何协议要求它必须维护社区版。但「开源基建」和「开源一坨代码」的区别,恰恰在于发布之后:issue 有没有人看,PR 有没有人审,文档会不会更新,外部贡献能不能合进去。这些指标比 star 数诚实得多。十天过去,DeepInfer 在这些指标上的答卷还是空白。
它当然可能只是还没来得及。也可能是把开源社区版的维护当成了低优先级。哪种都成立,哪种都值得继续观察。
为什么说这是一步阳谋
把视野拉高一层,DeepInfer 开源这件事的分量,star 数只是表面,往下看是它推动的两条趋势线。
第一条是推理成本的军备竞赛公开化。推理框架是各家 API 价格战的底牌,过去大家都在暗处优化,价格降了也不解释为什么。DeepSeek 把自己的底牌翻开给所有人看(benchmarks 复现脚本都给了),等于逼着同行要么跟进开源自家的推理栈,要么在价格上继续硬扛。网易一篇分析把这步棋称作「蓄谋已久的阳谋」,我基本认同这个判断:阳谋的意思是,我告诉你我要做什么,你也看得懂,但你跟不跟都难受。
第二条是开源的重心从权重下沉到基建。过去两年「开源大模型」指的就是开放权重;2026 年 10 月这一周,国内厂商几乎同时把基建层摆上台面:DeepSeek 开推理框架,此前 Kimi K3.1 Pro 开放权重加删改训练数据的自审,MiniMax M3.1 Flash(太空兔)上线,云栖大会又官宣了 Qwen4 下周见。国产开源的叙事,正在从「我的模型你能下载」升级成「我的全套生产系统你能复用」。
这个升级对开发者是实打实的好事。哪怕你现在用不上 SM100 或昇腾 950,benchmark 脚本和工程决策都摆在了明处,推理优化的知识溢价被拉平了一截。
但有一条传闻性质的线索,我必须用最谨慎的方式提一下:X 上有说法称 DeepSeek V4.1 Pro 也将剥离网络攻防相关训练数据,跟齐 Kimi K3.1 Pro 的做法。这条信息没有任何官方确认,信源层级只有社交媒体转述,写进本文仅为完整呈现时间线,请勿当作事实引用。开源的开放程度问题(从权重到训练数据到安全能力)正在变成一条独立的争议线,值得单独跟踪。
写在最后
衡量一个开源基建项目的成色,我最后会看三样东西。
代码的诚实度:README 有没有把能做的和不能做的写清楚。这一条,DeepInfer 做得相当好,边界写得比多数商业产品文档还坦白。
来路的透明度:基于什么改的、感谢了谁。这一条也过关,致谢段落大方承认 vLLM 血统。
发布后的生命力:issue、PR、文档、迭代。这一条,十天过去还没有答卷。
前两条决定了它此刻值多少星。第三条决定了它一年之后是社区基建,还是一个漂亮的存档仓库。
DeepSeek 把发动机开源了,这个动作本身值得敬意。至于加油站会不会开、配件会不会持续供货,看接下来的维护记录就行。
参考来源
- DeepInfer: High-performance, large-scale inference framework|GitHub(README、LICENSE、Commits、PR 数据均为 2026-10-30 抓取)
- 全球开源大战,有多少AI打回原形?|36氪
- 假开源?老外吐槽 DeepSeek 不公开训练数据和脚本,网友几乎一边倒怼他|搜狐·程序员的那些事
- DeepSeek 开源每日服务155 万亿Token 的推理引擎|转述官方公告口径
- DeepInfer框架分析笔记|知乎
- DeepSeek 开源推理框架这事,是一场蓄谋已久的阳谋|网易(观点参考)
尚未独立验证的部分:「每日服务 155 万亿 Token」为官方公告口径的二手转述;DeepSeek V4.1 Pro 剥离安全能力为 X 传闻(无官方确认,本文仅提及不引用);benchmark 图取自仓库官方数据,未在本机复现跑分;「10.20 当天 1.2 万星」来自发布当日报道。