先把信息来源交代清楚:这篇文章的主线数据来自 Meta 官方博客与模型卡、The Decoder 对 Artificial Analysis 指数的拆解、TechCrunch 的报道,三边相互印证过;Twitter 上流传的评测数据我标注了出处状态。要提醒的一件事:Meta 家有两个「Muse」:一个是 Apple 上个月因权限问题上过新闻的语音助手,一个就是本文的主角 Meta 自家模型系列,别混。
三个数字读完这场发布会
10 月 12 日,Meta 的超级智能实验室发布 Muse Wonder 与 Muse Wonder Full,官方称为公司迄今最强的模型。三边数据源给出的核心成绩:
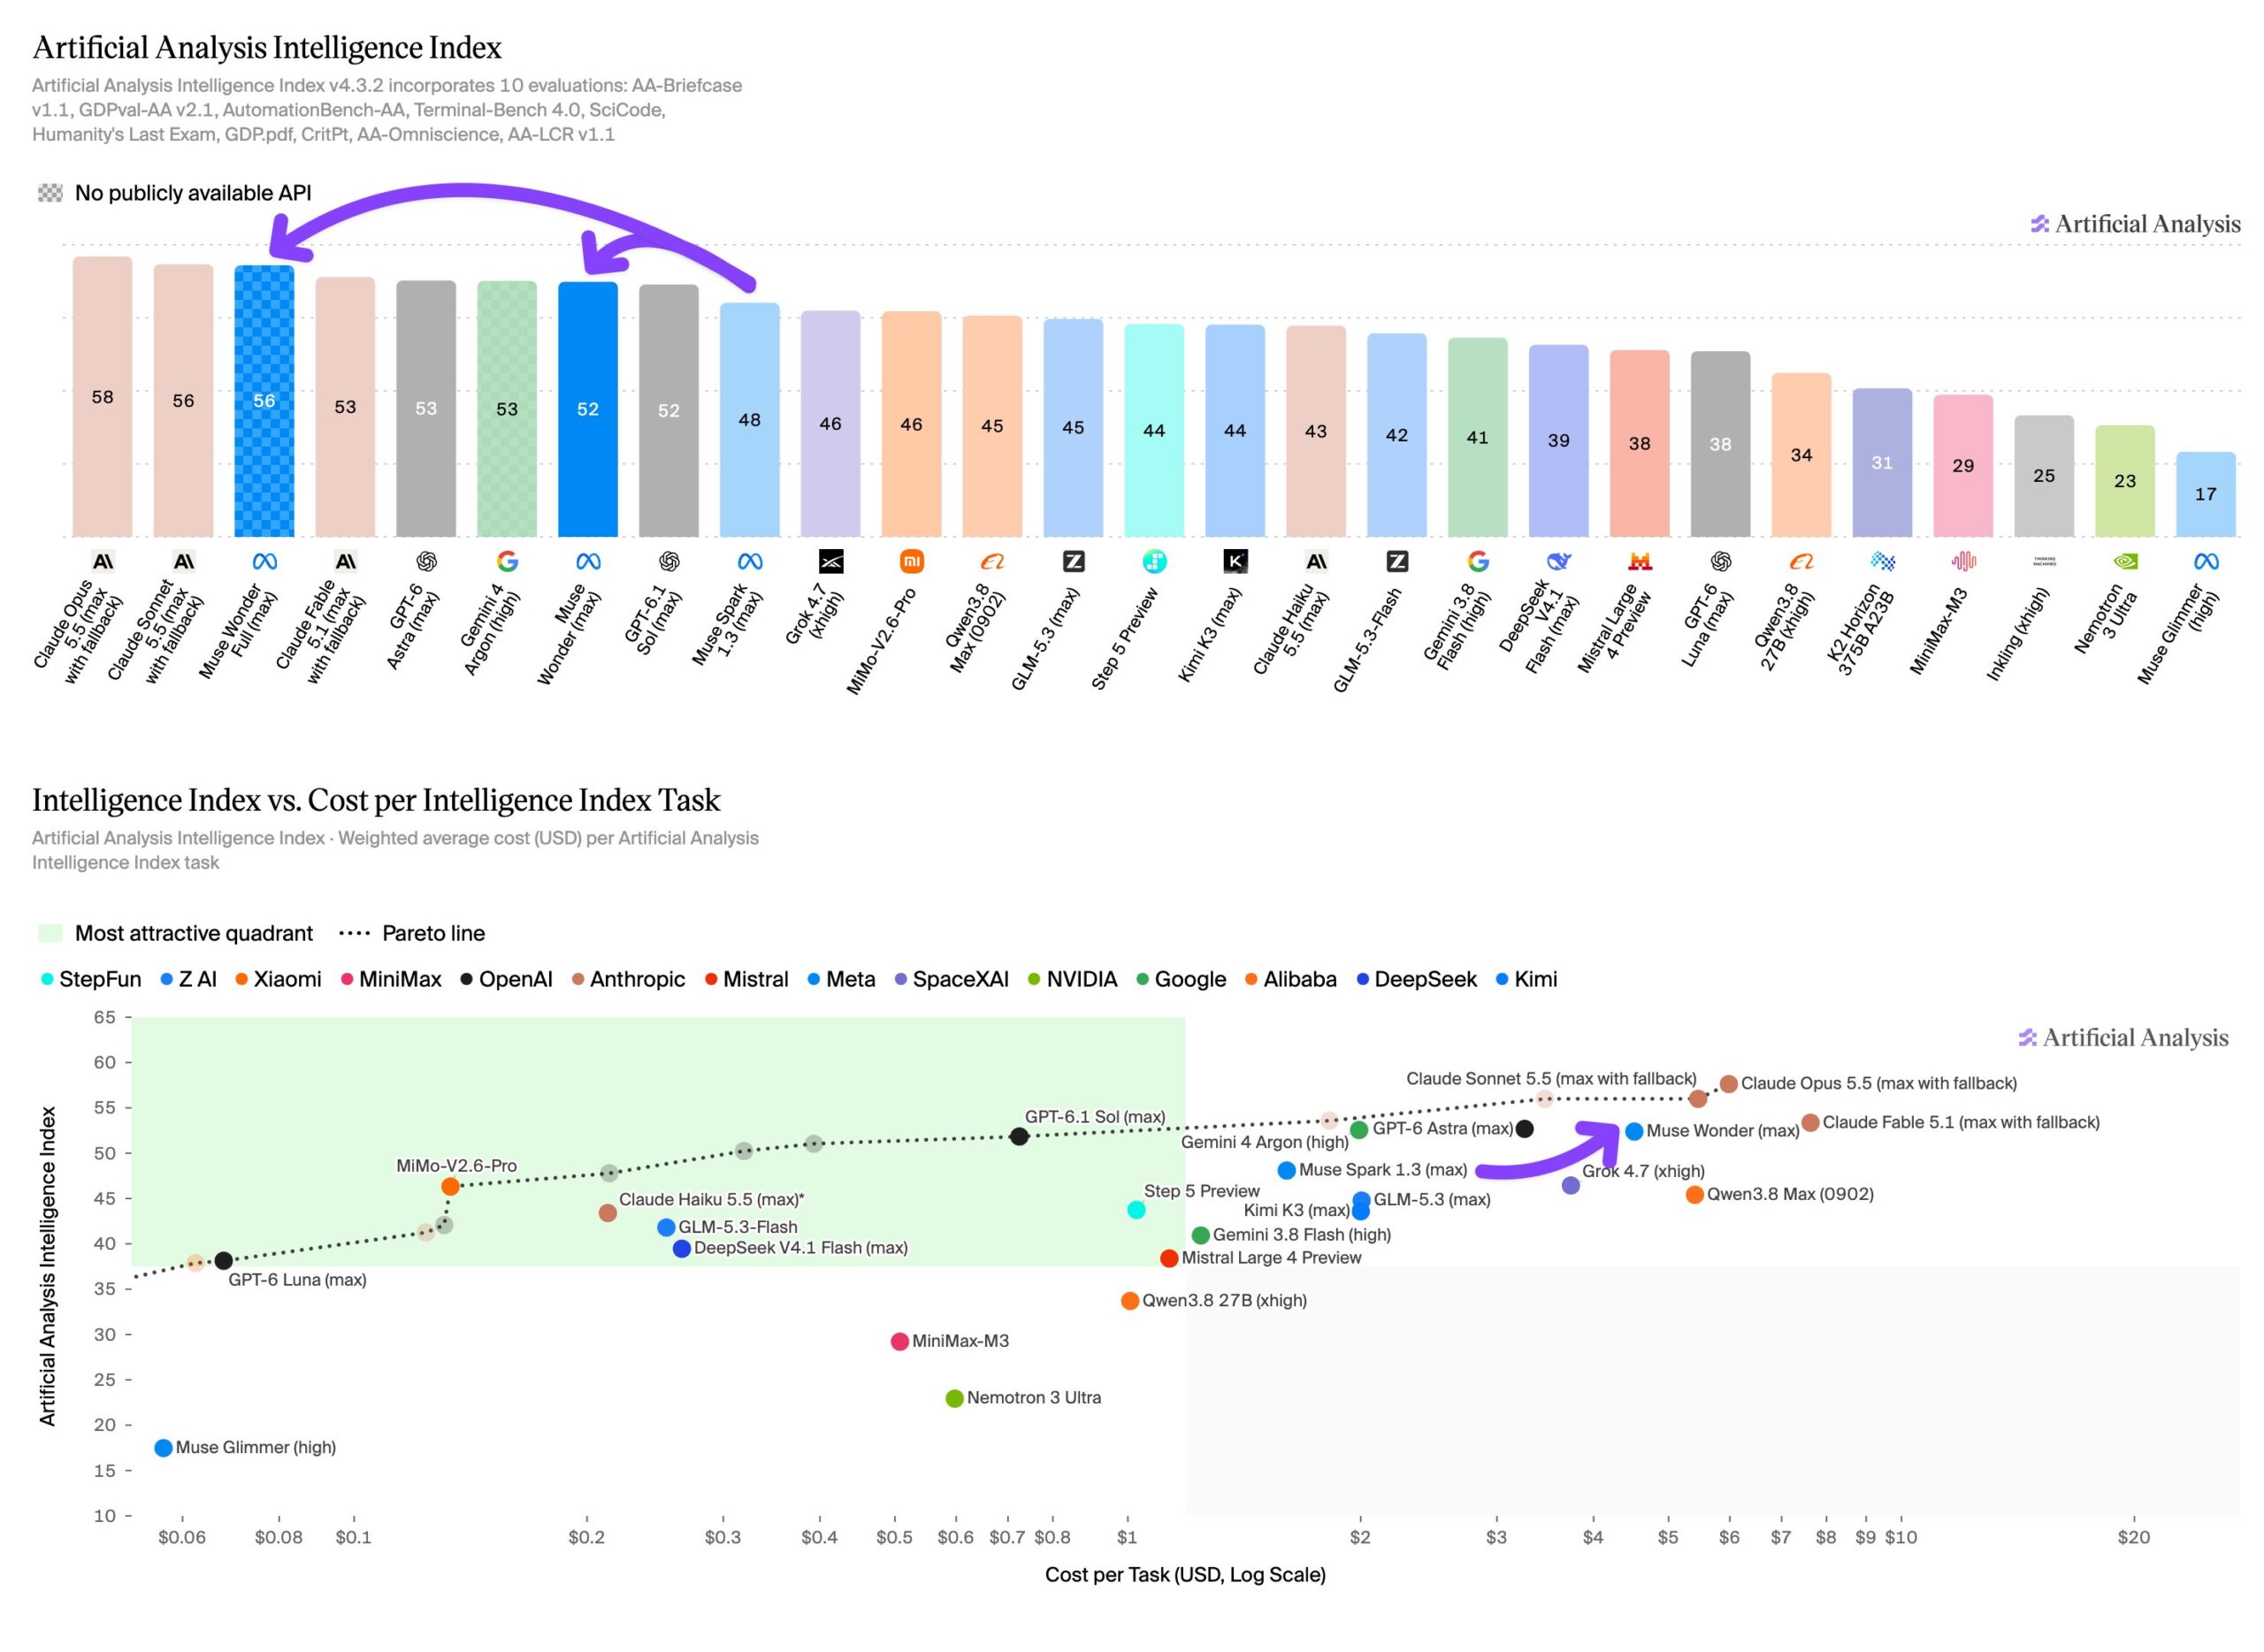
Artificial Analysis 智能指数(v4.3)上,Muse Wonder Full 拿了 56 分。作为参照:Claude Opus 5.5 仍在榜首,GPT-6 Astra 和 Claude Fable 5.1 都在 53 分左右,而 Meta 的上一代模型 Muse Spark 1.3 是 48 分。从 48 到 56,Meta 用一代产品的时间从中段跳进了第一梯队。
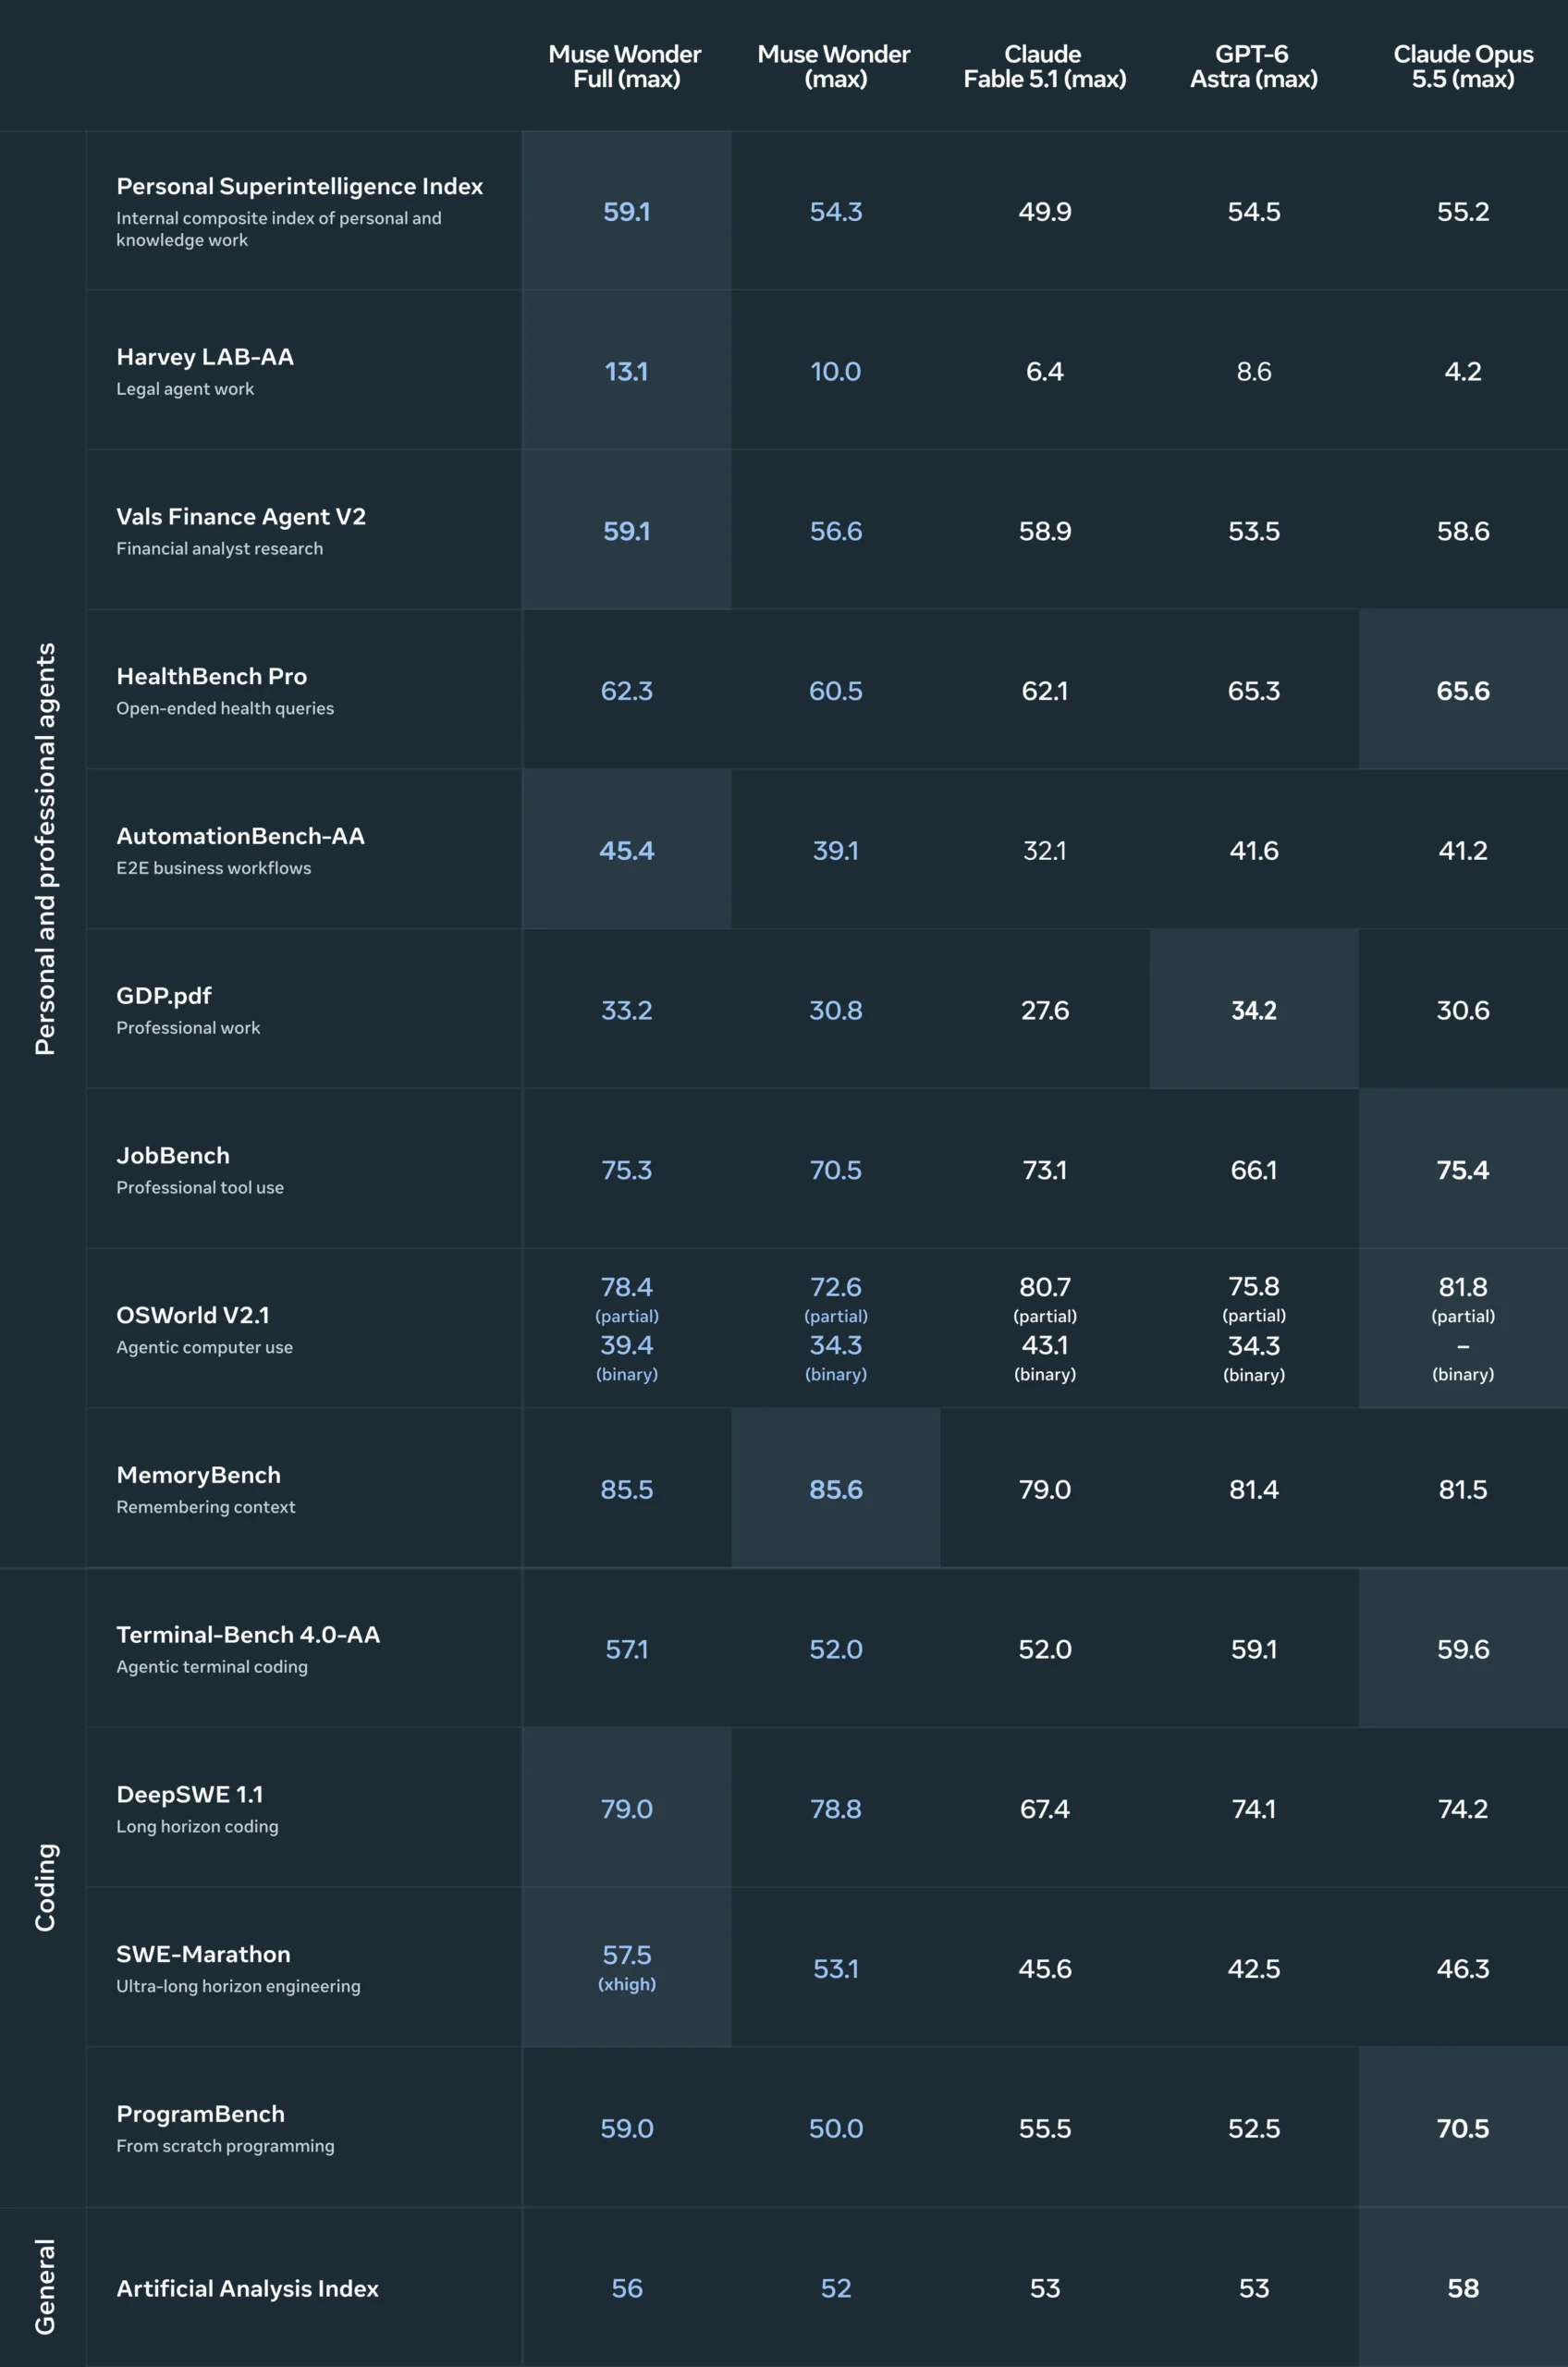
Agent 编码指数(Coding Agents Index)上,Muse Code 加 Wonder Full 的组合拿了 68 分,与 Claude Code 加 Sonnet 5.5 打平;The Decoder 补充的细节是,DeepSWE v1.1 子项 Muse Code 反而以 77% 高于 Claude Code 的 72%。
第三个数字是 Terminal-Bench 4.0 从 33% 涨到 57%,翻倍,而且输出 token 还少了 30%。十个主流基准里,Wonder Full 有六个进了前三。
十四个月,和一座吉瓦级机房
这次发布值得被认真对待的背景是它的来路。TechCrunch 回溯了时间线:去年 8 月,Scale AI 创始人 Alexandr Wang 入主重组 Meta 的 AI 业务,此后 Meta 发了轻量的 Muse Spark、9 月发了 Muse agent,但在旗舰模型上一直按兵不动——直到这次。官方博客的说法是「从重建地基,到推进前沿」。
训练基建也第一次被摆上台面:模型在 Meta 位于俄亥俄的 Prometheus 数据中心完成训练,今年早些时候上线,吉瓦级规模。这是 Meta 第一次明确把自建超大规模算力作为旗舰模型的训练地基来宣传,这本身就是一个信号:不用别人家的云,是打持久战的样子。
成绩单的另一半:知识测试 30 分
只看上面的数字,Meta 已经封神。但 The Decoder 拆出的另一半数据让画像完整了不少。
AA-Omniscience 知识测试上,Muse Wonder Full 只有 30 分,Muse Wonder 25 分,远低于 Claude Opus 5.5 的 46、GPT-6 Astra 的 43 和 Gemini 4 Argon 的 42。The Decoder 的判断是:这说明 Wonder 系列的基座模型比对手小。
但有意思的是幻觉率。Wonder Full 的幻觉率从上一代的 33% 降到 23%,在所有 45 分以上的模型里排第二低,只有 Gemini 4 Argon(15%)比它低。知识少、胡说也少——这是一个「知道自己不知道」的模型画像,加上 ProofBench 数学证明从 58 分干到 94 分(满分 100,距顶级只差 5 到 6 分),拼出来的路线其实很清晰:小基座,重训练,把力气花在推理和执行上,而不是硬背。
这算不算缺点,看你拿它干什么。拿它当日百科全书,30 分的知识面会露怯;可要论跑长任务、写代码、做证明,这份成绩单已经够硬。
Active Memory:这次不是营销词
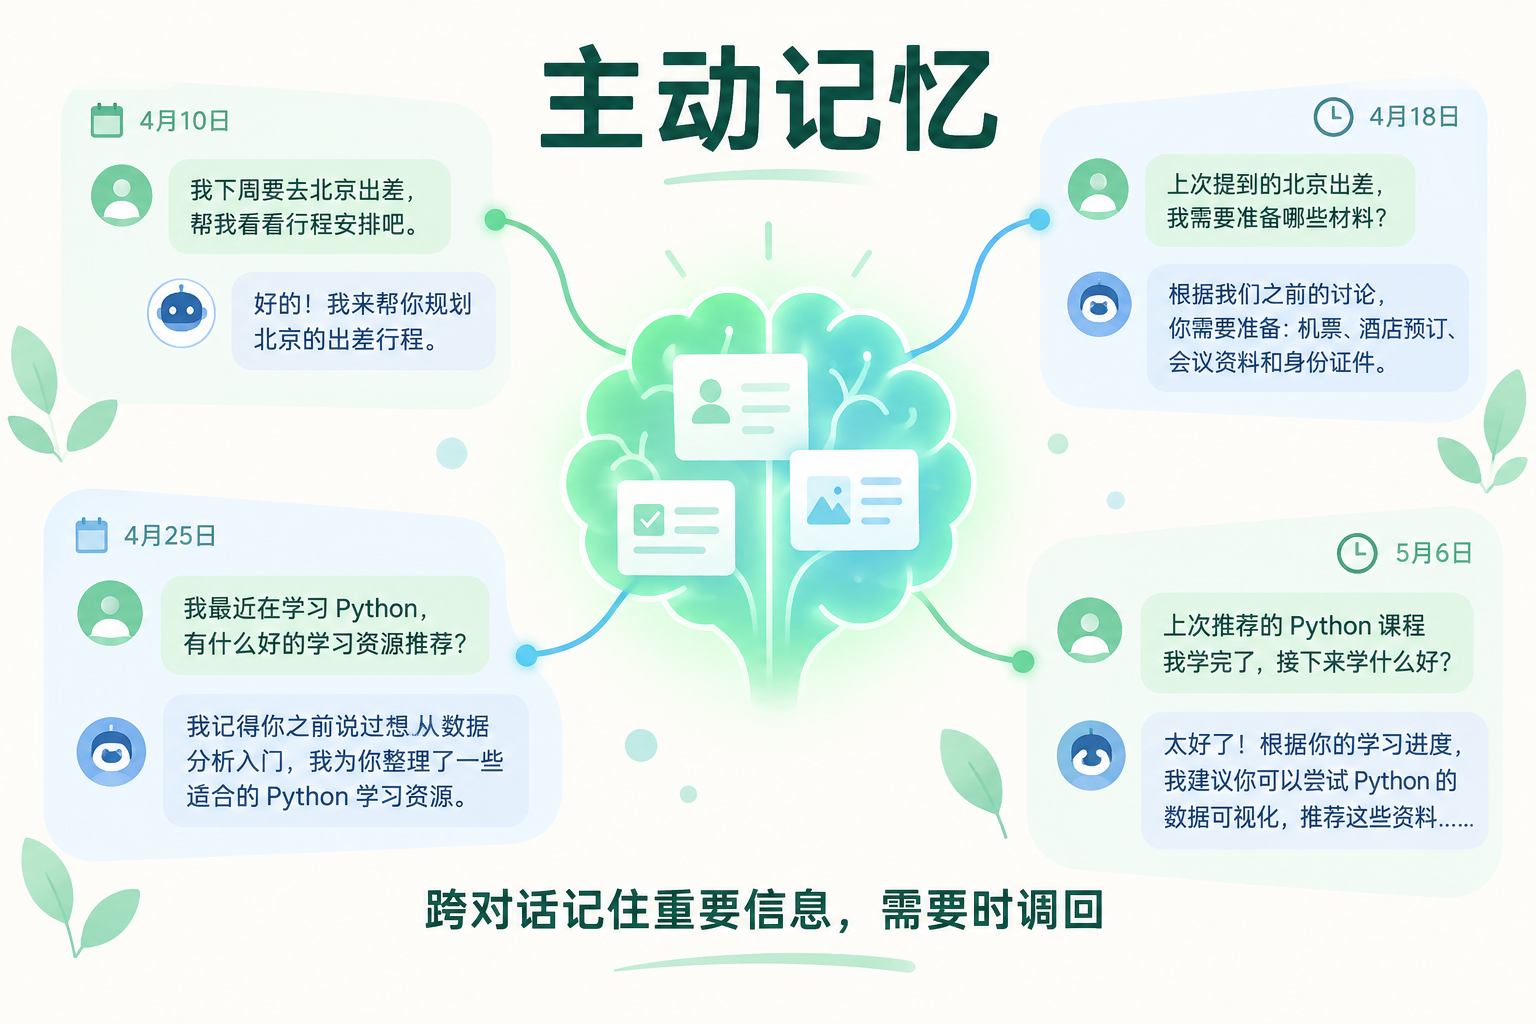
发布会的另一主推是记忆能力。官方口径叫 Active Memory:跨对话记住重要信息、在需要时调回。研究科学家 Kavya Kopparapu 在发布视频里的说法是「花了极大精力确保模型能记住对你重要的东西,跨越几天、几周、几个月」。
这类话术每个发布会有。不同的是这次给了第三方基准:MemoryBench(一个专测持续学习与记忆构建的基准)上,Muse Wonder 的得分高于 Fable、Opus 和 Astra。再加上 Active Focus(卡住时自主换思路、该追问时追问),Meta 把宝押在了「个人助理长期陪伴」这个场景上:能读你的日历、消息和文档,并且真的记得上一次说过什么。
价格卡在夹心层
定价是这场发布会里最需要精算的部分,网上流传的「比对手便宜一半」的说法并不准确。
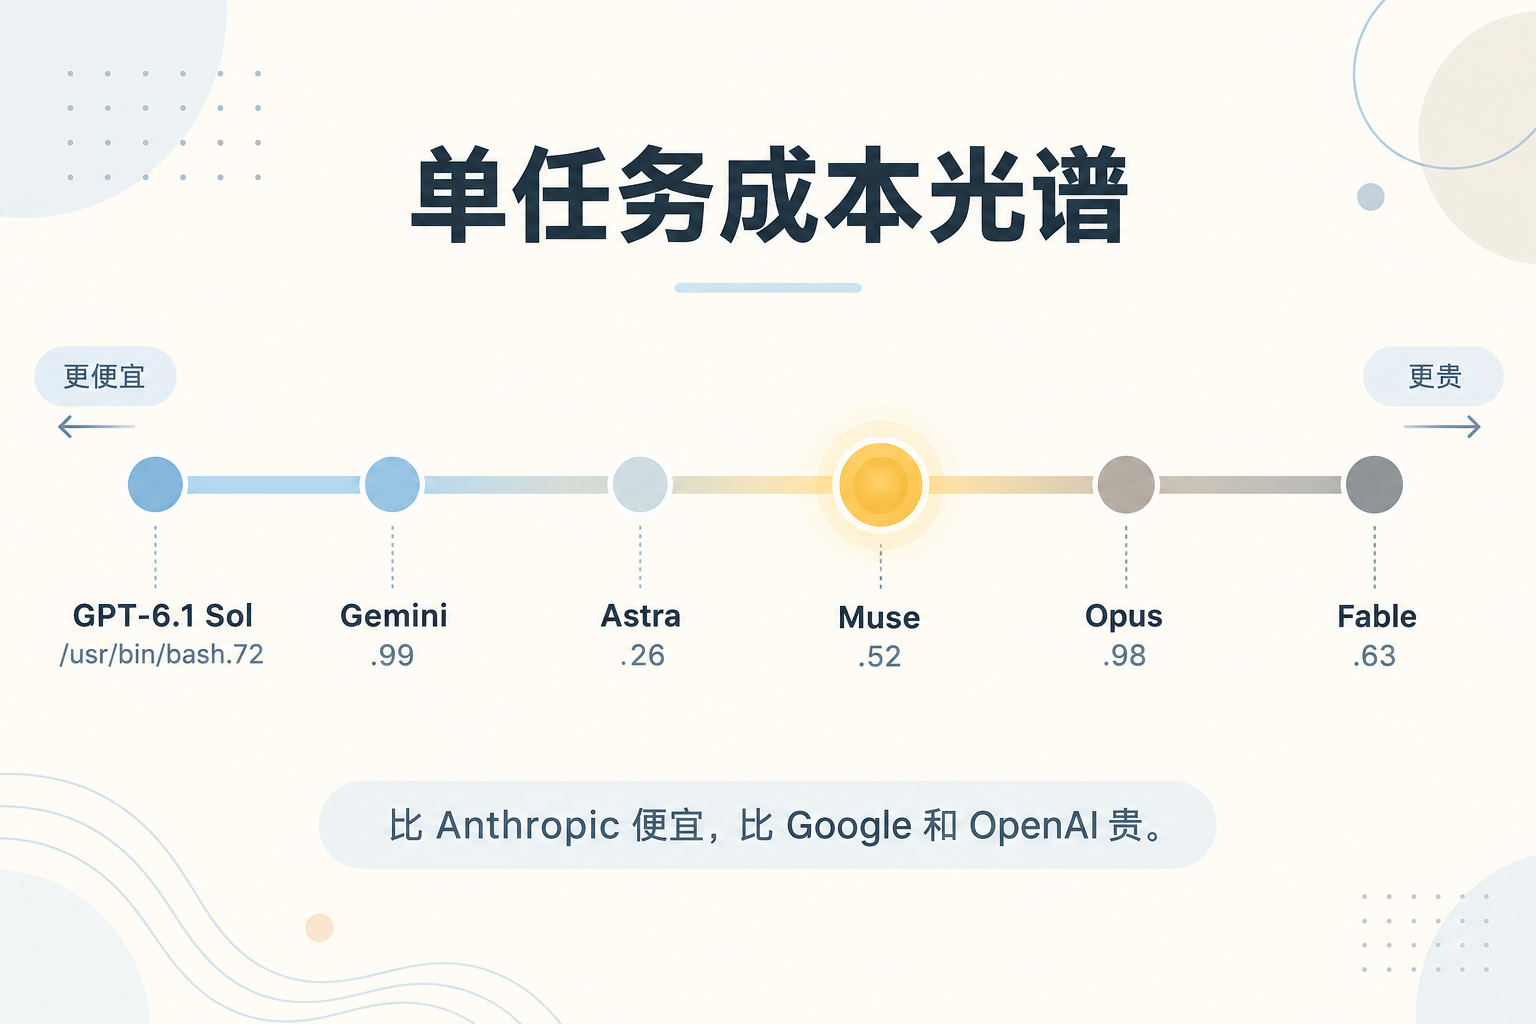
Token 单价是每百万输入 4 美元、输出 20 美元,比上一代的 1.25 和 4.25 涨了一大截。Artificial Analysis 算的单任务成本是 4.52 美元,差不多是 Muse Spark 1.3(1.60 美元)的三倍。放进竞品里看,它比 Anthropic 便宜(Fable 5.1 单任务 7.63 美元、Opus 5.5 是 5.98 美元),但比 Google 和 OpenAI 贵(GPT-6 Astra 3.26、Gemini 4 Argon 1.99、GPT-6.1 Sol 只要 0.72)。
一个补充细节:Muse Wonder 每个任务要比前代多消耗 28% 的输入 token,而输入 token 占了总成本的 76%。也就是说这个「便宜」是相对 Anthropic 的会员价而言,实际跑起来并不轻松——中文圈实测的反馈「速度快但消耗高」,和这组数字对得上。
还有一层限制:Muse Wonder Full 不走 API,只面向 Muse Code 订阅者开放。想用最强版本,得先进 Meta 自己的订阅体系。
最耐人寻味的矛盾:主打垂直,垂直没涨
官方博客给 Wonder 系列的定位是「个人与专业 agent 任务」,专家领域点名了法律、金融、健康。但 The Decoder 引用的第三方实测显示,金融与法律任务的表现停在上一代水平,甚至降了最多 2 分。同一周,智谱发布 GLM-Legal 主打法律垂直,Harvey LAB 全通过率 19.2%;两相对照,Meta 的「垂直」更像市场叙事,还没有基准背书。
这不是否定这次发布——通用能力和 agentic 执行的跃升是实打实的。但「法律金融健康」这九个字,目前还停留在博客文案层面。垂直能力要靠垂直基准说话,Meta 下一步需要补上这一课。
顺带一提:让 Claude Code 跑在 Muse 上
发布前后,Twitter 上有开发者发现 Meta 的开发者文档里出现了让 Claude Code、Codex、OpenCode 接入 Muse 模型的指引(此条为社交媒体流传,主博客未展开,待官方页面确认)。如果属实,这步棋比模型本身更有意思:Meta 不自建 Agent 壳,而是把自己刚发布的模型插进别人已经赢下的 harness 里。结合前面「价格夹心层」的定位,打法其实自洽——模型层拼性价比,入口层借现成的。
冷静面
中文圈的实测反馈两极。好评集中在编码与速度;批评集中在消耗与「刷分」嫌疑——Meta 官方评测表的成绩普遍好于第三方口径,这种自测与第三方之间的落差,历代发布会都存在,这次同样需要时间校准。另外,Vals AI 指数给 Wonder Full(Max)的首秀排名是第五,超过所有 OpenAI 模型、仅次于 Anthropic 系。注意给 Meta 泼过冷水的也是这家 Vals,排名口径不同(含 Max 档),看个趋势就好。
留三个观察指标
这场发布之后,值得盯三件事:一,MemoryBench 之外,Active Memory 在真实长周期使用里的留存率——记忆是宣传语还是能力,四周后见分晓;二,第三方对法律金融垂直的复测,验证「主打垂直」是不是叙事先行;三,Claude Code 接入 Muse 的官方文档何时转正,那是 Meta 真正下注 harness 生态的信号。
模型层卷完绝对分数之后,竞争正在往「谁被更多 harness 记住」迁移。Meta 这次交的卷子,及格线以上,惊喜线以下——但对一个十四个月前还在重组的公司来说,卷面上的每一分都是自己挣的。
参考来源
- Introducing Muse Wonder and Muse Wonder Full — Meta 官方博客
- Meta’s new frontier model Muse Wonder Full breaks into the AI top tier — The Decoder
- Meta releases its first frontier model, Muse Wonder — TechCrunch
- Artificial Analysis: Muse Wonder Full
- Muse Wonder Model Card — Meta Research
- Meta has some Wonder Full new AI models — The Verge
哪些内容尚未独立验证:「Claude Code/Codex/OpenCode 接入 Muse」来自社交媒体流传的开发者文档,主博客未确认;56 分与 68 分均为 Artificial Analysis 第三方口径,Meta 官方评测表分数普遍更高,两套口径并存;「Knowledge 测试反映基座更小」为 The Decoder 的推断而非 Meta 官方结论;MemoryBench 数据来自 Meta 自述的第三方基准结果,未见独立复测。