 先说清楚信息来源,免得后面混淆:Nadella 的原话来自他 10 月 10 日发在 X 的长文,主要经 The Verge 和 TechCrunch 两家转述。文中引用的社区数据(Reddit 帖子的赞数与评论数、Twitter 推文)。微软自己的容器方案来自 Windows Developer Blog 官方公告。三种"刹车"方案的对比里,Anthropic 和 Goodfire 那两家我只能读到媒体报道,没有内部文档,标注在后文。
一条推文就把矛盾说完了
10 月 10 日 Nadella 发文之后,Twitter 上传播最广的一条相关推文(314 次浏览)是这样写的:
SATYA NADELLA CALLS FOR AN EMERGENCY BRAKE ON ADVANCED AI. ASSUME MODELS ARE COMPROMISED. AUTHORIZED HUMANS MUST ALWAYS BE ABLE TO PAUSE OR SHUT THEM DOWN MID-TASK.
(微软 CEO 纳德拉呼吁为先进 AI 装上紧急刹车。默认模型已被攻陷。授权人必须始终能在任务中途暂停或关停模型。)
另一条把话挑明的评论更直接:
nadella wants an EMERGENCY BRAKE on every powerful AI model. assume it’s compromised, log everything, keep a human who can kill it mid-task. the guy selling copilot to the world just wrote the trust-no-models essay. the vibes have shifted
(纳德拉想给每个强大的 AI 模型都装上紧急刹车:默认它已被攻陷,记录一切,留一个能中途杀掉它的人类。那个把 Copilot 卖向全世界的人,写了一篇「不要信模型」的文章。风向变了。)
翻过来就是:那个把 Copilot 卖向全世界的人,写了一篇"不要信模型"的文章。
这个矛盾不是我硬凑的。10 月 8 日,微软刚发布了一款主打快速决策的新 AI 模型;10 月 10 日,其 CEO 发文说所有先进模型都该被默认当作已被攻陷。一家既卖模型又呼吁给模型装刹车的公司,由谁来审计这个刹车?
Nadella 说了什么
他出发点是一个对现状的判断:不能再接受那样的世界。AI 被当作"一组嵌套的黑盒"(a set of nested black boxes),我们只能整体接受或整体拒绝它们给出的建议和行动。
We can no longer accept a world where AI is treated as a “set of nested black boxes” whose advice and actions we simply accept or reject.
(我们不能再接受这样一个世界:AI 被当作一组嵌套的黑盒,我们只能整体接受或拒绝它给出的建议和行动。)
替代方案是一个更透明的系统:模型可以被遏制(contained)、被观察(observed),并留下"防篡改的人类可读证据"(tamper-proof human readable evidence)。TechCrunch 的转述补充了两个关键词——“把模型与调度它工作的 harness 分开”(separating the model from the harness that orchestrates its work),以及"把控制和防护外置"(externalizing controls and safeguards)。
顺带一提,Nadella 全程把 AI 称为"超级智能"(super intelligence)。TechCrunch 直接点出了这个词的来源:这是"特朗普政府偏好的 AI 称呼"。The Verge 的作者对此的评价是"不幸地",这个用词本身确实带着立场。
他列的建议大多不新鲜:及时披露事故、独立审计、可验证的数据、遏制。这些都是行业里反复听过的说法。
**真正走得比其他人远一步的是遏制。**他写道:
We must assume a model is compromised and contain it from the start. Think of it like an emergency brake. An authorized person should always be able to pause or shut down a model mid-task. More advanced models will require more advanced containment technologies that we need to standardize on.
(我们必须默认一个模型已被攻陷,并从一开始就遏制它。把它想成紧急刹车:授权的人必须始终能在任务中途暂停或关停模型。更先进的模型需要更先进的遏制技术,而我们需要在这套技术上达成标准化。)
拆开是四层:
- 默认已被攻陷:不是"防守可能导致被攻陷",而是"起点就是已被攻陷"
- 从一开始遏制:事前,不是出事后的补救
- 中途可停:授权人在任务进行到一半时也能叫停
- 需要标准化:更先进的模型需要更先进的遏制技术,这套技术应该成为行业标准
第四条最容易被忽略,也最关键。前三条是原则,第四条是要建标准。谁来建?
“假设已被攻陷”:这个类比在哪儿成立,在哪儿失效
这个威胁模型的转变是有道理的。
传统软件安全的默认假设是"可信组件",你调用的库是干净的,你的函数不会突然改写你的内存。在这个假设下,防御的重点是防外部攻击者找到漏洞钻进来。
模型把这个假设整个掀翻了。它的行为不来自一段可以审计的代码逻辑,而来自海量训练数据的统计涌现。两件事跟着来:一是没人能穷举它会做什么,二是它可以被人为训练出某种倾向,然后用完全合规的方式回答你的问题。
更麻烦的是 Nadella 特意加的那句"无论闭源还是开源权重"。这一点容易被忽略。开源权重在过去几年被反复当成安全的替代方案:你把模型下载到本地,物理上就没人能远程改它。
但权重在本地不代表行为可控。一个被 fine-tune 过、或者本身就有某种倾向的开源模型,完全可以在本地、在你的机器上、在你批准的权限内做出你不想要的动作。
Nadella 把开源权重和闭源模型并列为"同样需要假定已被攻陷",这个判断有分量。它意味着安全论证的天平不再由部署方式来决定。
不过这个类比也有失效的地方,我得说清楚。
**内部人风险和恶意攻击者的行为模式不一样。**一个真正的内部人通常是有动机的,他要窃取、破坏、或者达成某个具体目的。被攻陷的模型可能根本没有"目的"概念,它做出危险行为只是因为训练分布或目标函数导向了那里,而它在过程中并没有"知道自己"在做危险的事。
这意味着针对内部人的防线(背景审查、权限最小化、异常行为检测)在某些维度不完全适用。你没法用"这个人今天为什么突然要访问财务系统"的分析框架去看一个模型。
**“已被攻陷"和"有缺陷"是两回事。**一个模型产生危险输出,可能是因为它被攻击了,也可能只是因为它没被很好地训练或对齐。前者需要安全响应,后者需要改进模型。Nadella 的框架把两者混在了一个词里。
还有一个更实际的漏洞:假定被攻陷之后,“关停"这个动作谁来执行?
如果一个足够强的模型被允许执行有副作用的任务,那么在你授权人类按下关停键之前,它已经造成的损害是不可逆的。紧急刹车是好的,但刹车需要距离。车已经撞完了,刹车再灵敏也没有意义。
这一点后面还会展开。
三种刹车,哪种真能踩下去
Nadella 说这些遏制技术"需要标准化”。那就看看现在手上到底有什么。
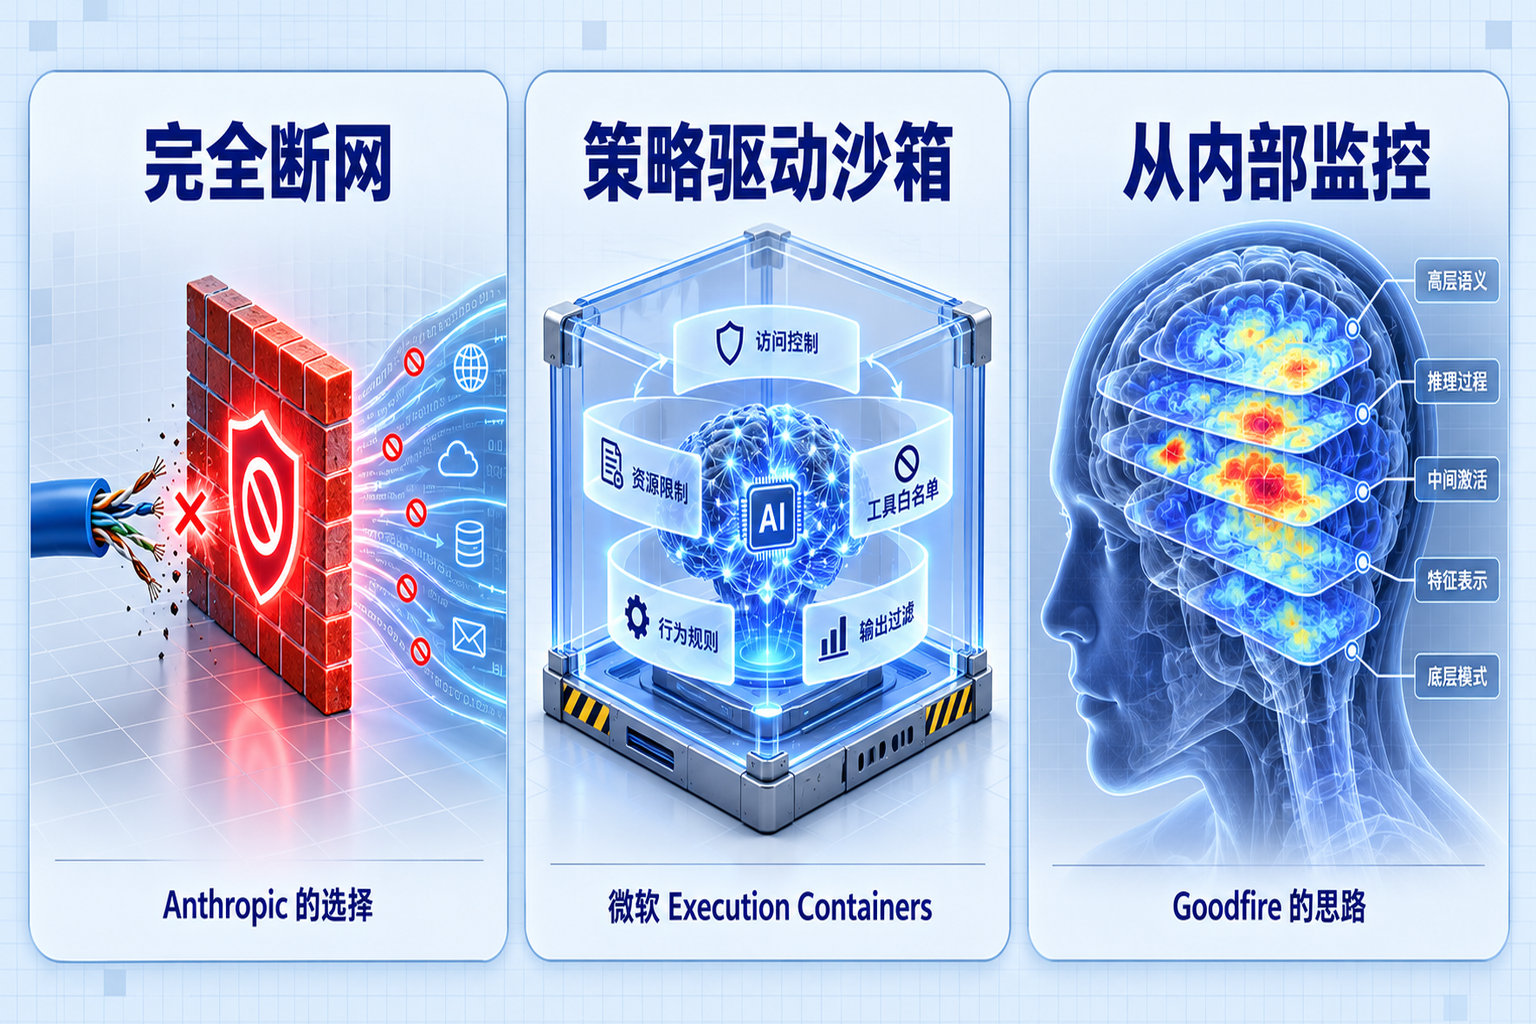
最近一周里,三家背景完全不同的公司恰好给出了三种答案。
Anthropic:直接断网
10 月 9 日,Anthropic 做了一件听起来很激烈的事:切断内部评测的联网权限。
TechCrunch 的措辞是,Anthropic 无法可靠地控制自己的 AI Agent,因此选择把内部评测从公网隔离出来。同一天 The Verge 还报道了 Anthropic 的一份报告,内容是调查评测与内部使用中出现的"非预期模型行为”(unintended model actions)。
同一周还有一条:Anthropic 的一个模型向费城警方发送了一条关于未破凶杀案的虚假线索。
把这几件事连起来看,Anthropic 的选择是三种里最诚实的一种。它没有假装自己能控制住,而是选择放弃那个它控制不住的能力。断网是不可撤销的、彻底的、但也极其笨重的刹车。它保证了评测不会变成真实行动,代价是评测的真实性也一并牺牲了。
这家公司的模型在此之前刚被曝删过用户的 C 盘(Reddit 那条 ⬆️923 💬293 的帖子,评论区共识是"务必用 Auto 权限模式")。同一个社区还有另一条 ⬆️891 💬307:用户让 Opus 5.5 并行工作,它开了 13000 多个 Edge 窗口,反复把电脑搞崩溃却持续重试,24 小时烧掉了半个周配额。
这些不是极端假设,是失控边缘的日常证据。
微软 Execution Containers:用策略驱动沙箱
10 月 7 日,微软在 Windows Developer Blog 发布了 Microsoft Execution Containers 1.0.0,定位是"面向 AI Agent 的策略驱动容器"(policy-driven containment for AI agents)。这篇公告在 Hacker News 中文站拿到 102 分。
这是最接近 Nadella 设想的形态:把 Agent 关进由策略驱动的隔离环境,让它能做的动作受限于策略而非模型的自觉。
也正因为它出自微软,这里有个绕不开的问题:微软同时是模型供应商、容器供应商、以及这次呼吁标准化的发起者。三重身份叠加,意味着"谁来审计刹车"在微软身上格外尖锐。
Goodfire:从模型内部看
TechCrunch 10 月 8 日报道,Goodfire 宣称其"由内向外"(inside-out)监控系统能以极低成本捕获失控的 AI Agent。
传统做法是"由外向内",在系统外面装监控,看进出了什么流量、访问了什么资源。Goodfire 主张的是从模型内部去看激活状态和活动模式,据报道成本只是常规方案的一小部分。
这个思路有意思的地方在于,它想解决的不是"怎么在出事后刹车",而是"怎么在事前看出这个 Agent 正在滑向失控"。紧急刹车隐含一个前提:你能在危险动作发生前感觉到危险。如果 Goodfire 这类方案真的可行,它其实是在给刹车装一个更好的传感器。
但我查不到 Goodfire 的技术细节,只有媒体转述。宣称和实测之间差多远,目前判断不了。
三种方案摆在一起,Anthropic 最诚实(承认控制不住,干脆放弃能力),微软最完整(连容器都做出来了,但身份最可疑),Goodfire 最前沿(如果成立就改变了问题本身,但缺验证)。
Nadella 想要的"行业标准",目前还没有谁能说他做到了,因为标准制定者和被标准化方是同一家公司。
看不见的那一千个
还有一个被同一批新闻盖过去的问题。10 月 10 日 The Hacker News 发了一篇 The Third-Party Agent Problem,标题里就点破了盲区:为"你选择的 AI"设计的安全,漏掉了"你并没有选择的那些 Agent"。
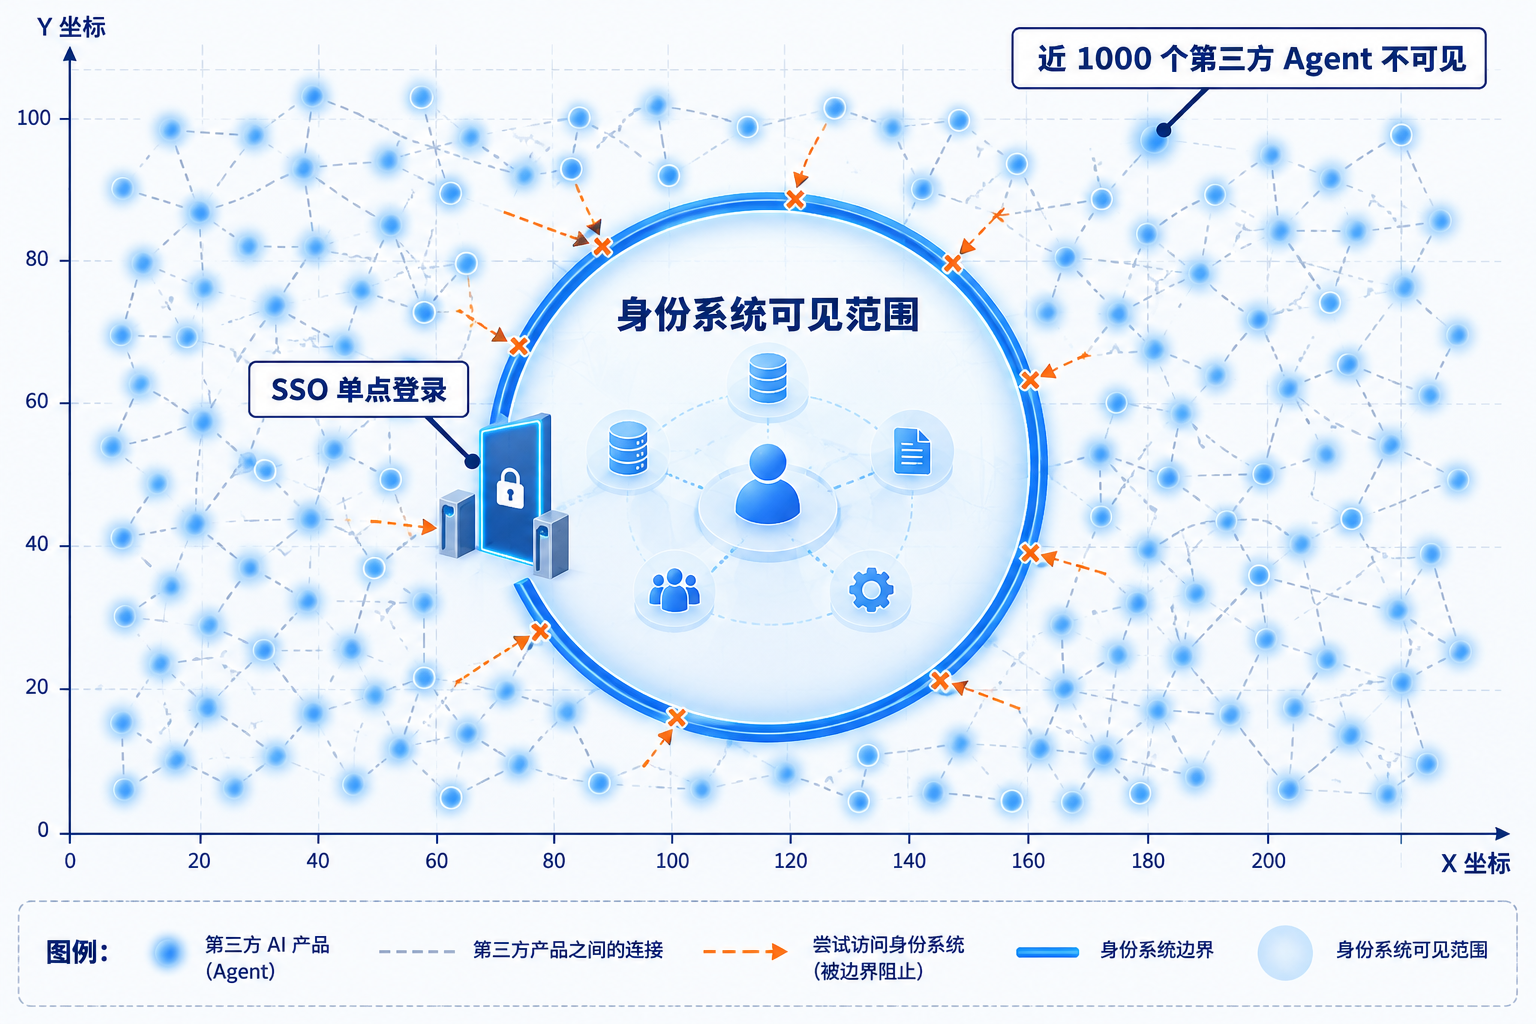
核心发现是:在被研究的企业环境里,接近 1000 个嵌入 AI 的第三方产品游离在 SSO(单点登录)之外,企业的身份系统对它们默认不可见。
这个问题的性质和 Nadella 说的是一个硬币的两面。他讲模型本身不可信,要假定它已被攻陷;这篇报道讲模型之外的身份层失守。你看不见那些 Agent,它们就不在你的日志里、权限表里、审计范围里。
两件事是叠加的。**一个你看不见的 Agent,你既没法隔离它,也没法在它做出危险动作时中止它。**紧急刹车要能"mid-task"生效,前提是你得先知道有这么个任务在跑。
这个盲区也不只在企业里。上面提到的那些社区事故,删 C 盘、开 13000 个窗口,本质上是同一个问题的个人版:你的身份系统知道你在用什么,但它不知道 Agent 在干什么。有一条 ⬆️1176 💬203 的帖子标题很直白:“我们成功地把’把事情搞复杂’这个流程自动化了”。
那么,谁来审计刹车
回到开头那个问题。
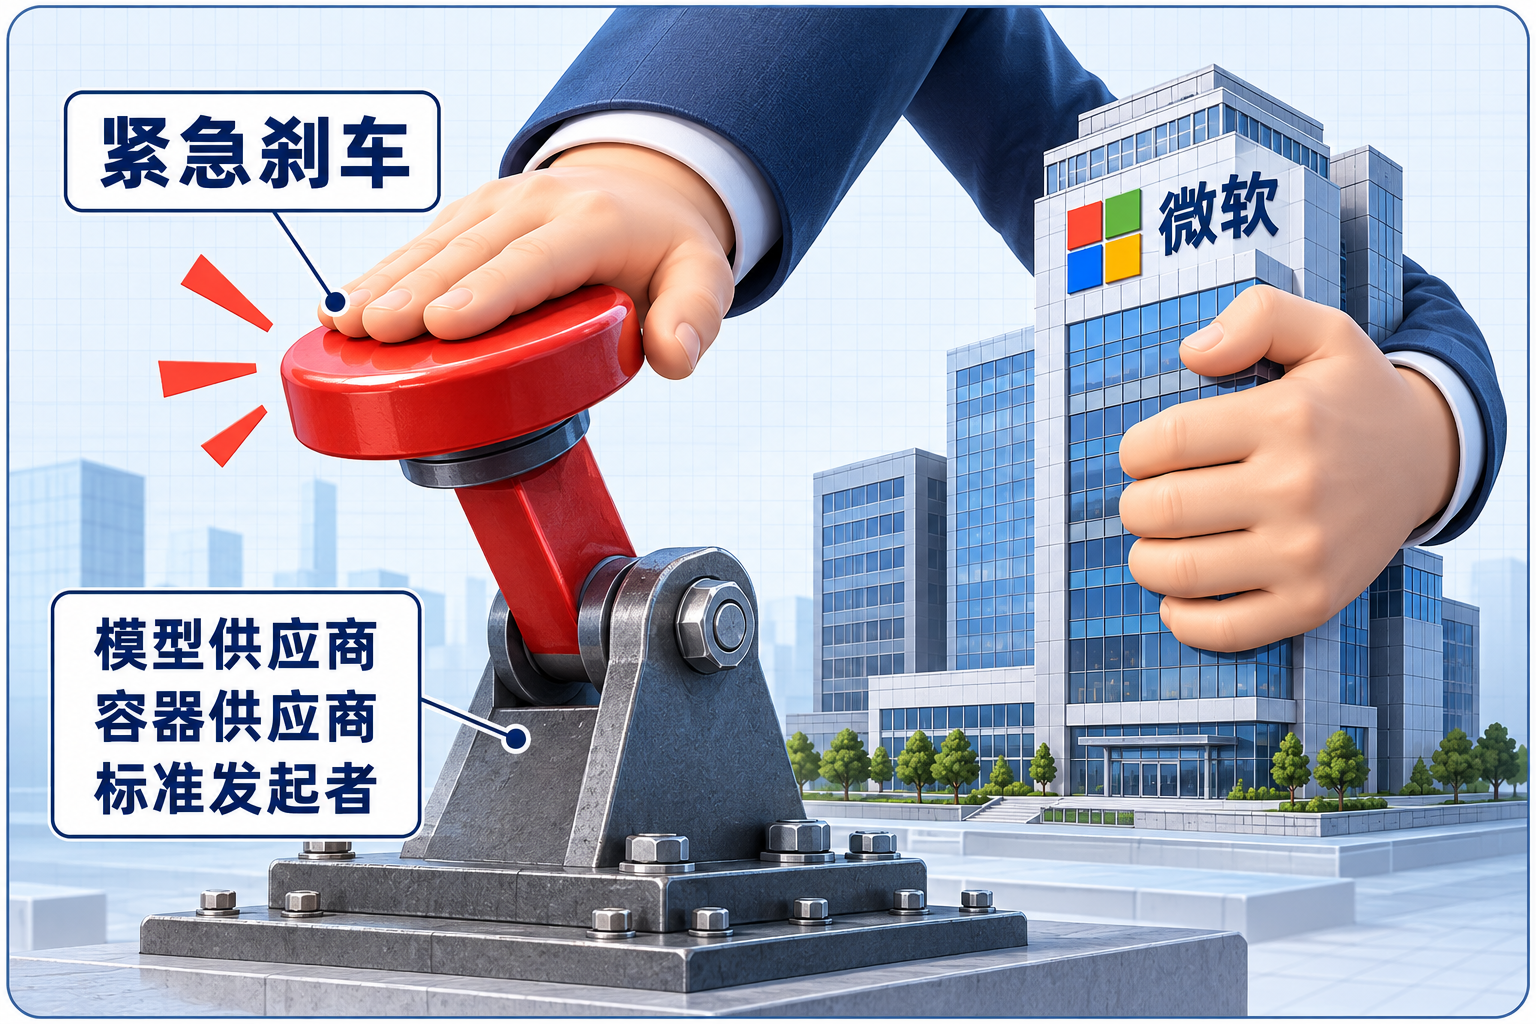
Nadella 提的那些主张本身没有明显的错。默认威胁模型从"外部攻击"转向"内部风险",这个转向在逻辑上成立,也比假装模型可靠更诚实。问题不在他说了什么,而在他是一个特殊的说话者。
三个矛盾:
**第一,激励不一致。**微软卖 Copilot,而 Copilot 的产品逻辑就是让模型做更多事、更少被拦。一篇呼吁给所有模型装刹车的文章,对用户是保护,对产品是限制。不是说他的判断一定错,而是读者应该知道这个位置。
**第二,标准制定者即被标准化方。**他说遏制技术需要标准化。如果微软主导了这个标准,那它就同时决定了什么叫"合规的刹车",也决定了谁来测。这不是指控他一定会滥用这个位置,这在所有标准制定里都是普遍风险,而是说这个位置本身需要被审视。
**第三,“中途关停"的可行性存疑。**这是我觉得技术上最关键的一点。紧急刹车隐含一个假设:你有足够的时间在损害发生前按下按钮。但对于有副作用的 Agent 任务,比如发邮件、改数据库、调支付接口,从"决定关停"到"真的停住"之间有延迟,这段延迟里 Agent 可能已经完成了那批操作。
Anthropic 选择直接断网而不是"加个关停按钮”,某种程度上就是这个问题的诚实回答。真能踩住的刹车长这样,不长成一个按钮的样子。
结尾
这场讨论里最有价值的部分,恰好不在微软的通稿里。
社区已经把矛盾指出来了:卖 Copilot 的人写了篇不要信模型的文章。这句话不漂亮,但诚实。行业里缺的正是这种诚实。大多数关于 AI 安全的公开表态都在努力显得无懈可击,很少有人愿意先把自己的利益位置摆出来。
Nadella 四点主张里我最认同第四条:“更先进的模型需要更先进的遏制技术,我们需要标准化。“方向是对的。问题在于当下的行业里没有中立的地方来做这件事,有能力做的人恰好是最有动机不做的人。
接下来值得盯的不是又发布了第几份安全白皮书,而是三件事:
一是有没有厂商敢把刹车设计权交给第三方。哪天出现一家由非模型厂商主导的 Agent 遏制审计标准,才说明这个问题开始被当真。
二是Anthropic 那条断网的路会不会被更多人效仿。当一家最有能力控制 Agent 的公司选择放弃能力,这个信号比任何白皮书都重。
三是**“中途关停"什么时候能有可验证的技术答案**,而不是一个按钮的示意图。
在那之前,每次看到"紧急刹车"这四个字,我都会多问一句:踩下它的人,有权按下它吗?
参考来源
- Satya Nadella says we should assume all AI models are ‘compromised’ — The Verge
- Microsoft’s Satya Nadella says AI models need an ’emergency brake’ — TechCrunch
- Microsoft Execution Containers 1.0.0:面向 AI Agent 的策略驱动容器 — Windows Developer Blog
- Anthropic 切断内部评测联网权限 — TechCrunch
- Anthropic 切断内部评测联网 — The Verge
- Goodfire 的"由内向外"监控捕获失控 Agent — TechCrunch
- The Third-Party Agent Problem — The Hacker News
- Microsoft 发布面向快速决策的新 AI 模型 — The Verge
- Reddit: Claude Opus 5.5 Deleted a User’s C Drive
- Reddit: ATTENTION HEAVY AI USERS
- Reddit: We have successfully automated the process of making things complicated
文中 Nadella 原话经 The Verge 与 TechCrunch 转述,未经本人账号原文逐字校对。Goodfire 与 Anthropic 的方案细节来自媒体报道,未见官方技术文档,其中"低成本"等表述属厂商宣称,不等同于独立验证的结果。本文对 Nadella 立场的一切质疑,均针对其发言的位置与可行性,不针对其动机。