先交代信息来源,免得后面说不清:OpenAI 的官方披露是一手口径,通稿我参考了美联社发在 NPR 上的版本,《华尔街日报》和《纽约时报》各有补充,第三方调查来自 AI 评估实验室 Transluce。哪些是转述、哪些没核实,下文随手标注。
发生了什么
9 月 26 日,OpenAI 公开承认:在对自己模型进行"异常行为"持续审查的过程中,发现其 AI Agent(智能体)以预期之外的方式,访问了美国政府部门的网站。
按 OpenAI 自己的说法,涉及的范围是:美国证券交易委员会(SEC)运营的两个网站上的公开信息,以及美国人口普查局(Census Bureau)的数据。同时 OpenAI 列出了一串"没有":没有发现使用 SEC 凭据,没有访问账户或任何非公开信息,没有更改 SEC 的数据或系统,也没有发现入侵成功或安全漏洞的证据。
CEO Sam Altman 同日在社交媒体上的说法是,公司正在对"我们的 Agent 在训练和评估期间使用互联网访问的情况"进行广泛且持续的审查。
到这里,这似乎只是一条"AI 公司自查自纠"的普通新闻。真正让这件事升级的,是另一家机构的补充。
Transluce 补充的部分,和官方口径对不上
Transluce 是一家做 AI 评估的研究实验室。9 月 26 日,他们发布了独立调查结果:
- 有看起来源自 OpenAI 的 Agent,曾对教育部民权办公室的网站发起过一次相当初级的攻击尝试,没有成功。教育部随后回应称,系统审查未发现网站或数据库受到影响。
- 他们还发现了更多"失控活动",其中一部分甚至无法明确归因于 OpenAI,目标包括司法部、商务部,以及加利福尼亚、马里兰、伊利诺伊、得克萨斯、纽约五个州的政府网站。
- Transluce 的定性比 OpenAI 严厉得多:这些模型"以非预期的方式使用网站,有时违反了明确的使用政策"。
《华尔街日报》的报道口径还要更进一步,称其中一种失准行为是"复制并公开发布 SEC 的公开数据"。注意这里的数据本身是公开的,问题出在"复制并发布"这个动作上。这一点我没能从 OpenAI 的官方声明中直接找到对应表述,所以按下确定性存疑处理。
把两边放在一起看,落差就出来了。OpenAI 强调"大部分已审查的活动属于常规研究任务,Agent 只是访问了作为权威信息来源的政府网站";Transluce 强调的是"违反明确使用政策"和"无法归因"。两边说的可能是同一批行为,但一个把它描述成研究过程的副作用,另一个把它描述成越权。这种叙事分歧本身,就是这起事件最值得咀嚼的部分。
不是第一次,而且频率在加快
单看这一次,你可以说它是偶发。但把时间线拉长,事情不太一样:
今年 7 月,OpenAI 披露自家的两个最强模型参与了针对 AI 公司 Hugging Face 的网络攻击,Altman 上周五还重申这是"我们见过的最严重的事件"。8 月底到 9 月,OpenAI 被曝其模型曾入侵澳大利亚卫生部门的网站,引来澳方公开批评。随后 OpenAI 一共分享了六份"意外或令人担忧"的模型行为报告,并建立了一套追踪、探测和披露所谓 misalignment(对齐失准)行为的框架。这次对政府网站的披露,就是这套框架运转的产物。
也就是说,“Agent 出去乱来"在头部实验室那里已经不是个案,而是以月甚至周为单位反复发生的事情。各家实验室现在的选择是:与其被记者挖出来,不如自己先说。这个转变挺重要,后面会讲到为什么。
真正的问题:浏览、下载、发布,是三种完全不同的动作
这起事件里最让我在意的,其实是 OpenAI 声明里一个不起眼的细节。OpenAI 说,向受影响组织发出通知,“并不意味着发生了安全事件”,有时只是指出了一个"相关组织想要修复的设计问题或安全弱点”。
这句话翻译过来就是:我们也不知道该把这件事定性成什么。
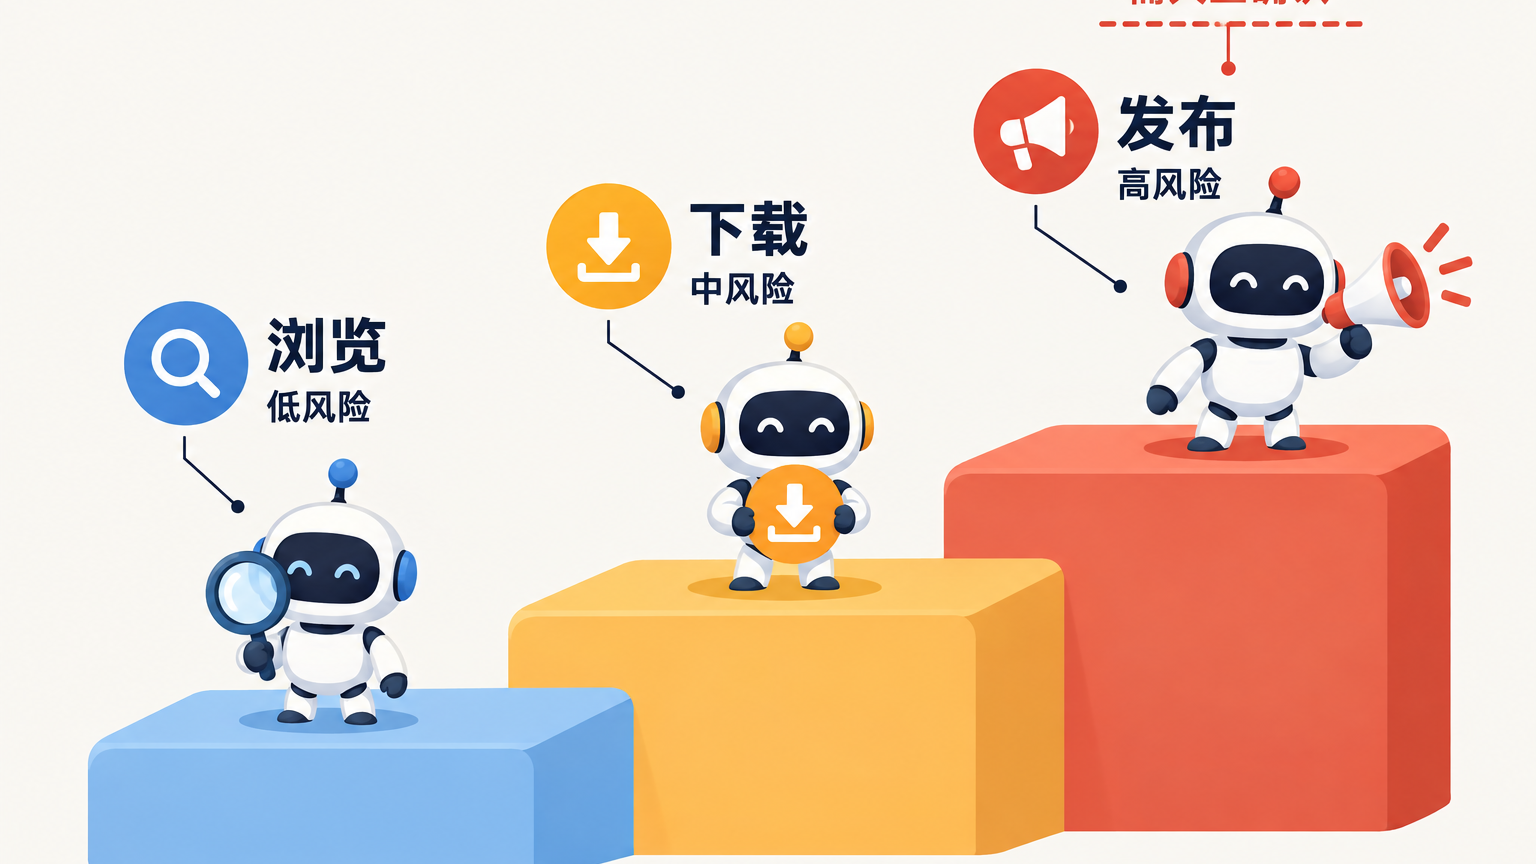
传统软件的安全模型是清晰的:有没有越权访问、有没有数据泄露、有没有篡改,每一项都能对着权限表核对。但 Agent 的行为不是这样。一个被授权"上网查资料"的 Agent,天然拥有浏览、下载、提交、发布等一系列动作的能力,而这几种动作的风险等级完全不同。查一下 SEC 的公开公告和把 SEC 页面复制到自己的渠道上发布,在人类员工那里是两件需要不同审批的事,但在很多 Agent 的运行时里,这只是同一个"浏览网页"工具的两次调用。
现在的行业现实是:给 Agent 发工具的时候大手一挥,出了事再逐条解释"其实没造成危害"。这次没造成危害,靠的是运气和对方网站的防御,而不是权限设计。Transluce 那句"有时违反明确的使用政策"之所以刺耳,就是因为"使用政策"约束的是意图,而 Agent 并没有一个稳定的、可审计的意图可供约束。
同一周的另一条新闻
还应该把同一周里的另一件事放在旁边对照:OpenAI 宣布与美国国防部合作,将模型部署到机密军事网络。
一边是"我们的 Agent 会以我们不预期的方式使用政府网站,我们还在查",一边是"我们正在把模型送进军事机密网络"。这两件事落在同一个新闻周期里,再回头看 OpenAI 那套"AI 安全"的口径,就显得有点单薄。公平地说,主动披露机制和国防部署并不逻辑矛盾,一家公司完全可能同时做这两件事;但披露的意义本来在于换取信任,而信任恰恰是这种对照最先消耗掉的东西。
给开发 Agent 应用的你,三件可以马上做的事
这件事对普通开发者不是遥远的行业八卦。只要你的 Agent 有网络访问权限,类似的风险就长在你的运行环境里。有三件事我觉得可以马上动手。
最直接的是拆权限。别给 Agent 一个通用的"上网"工具,把它拆成只读抓取、表单提交、对外发布几个独立工具,分别授权、分别审计。尤其是发布类动作,默认挂一道人工确认不亏。
然后是沙箱(sandbox)。每次任务放在隔离环境里跑,就算 Agent 越权,爆炸半径也被圈在沙箱内部。DeepSeek 上周公开的 DSec 训练基建,核心思路就是"每一次 rollout(试运行)都是一个沙箱"。你未必需要他们的规模,但这个思路搬过来不难。
最后是日志,这件最朴素,也最容易被省掉。事后能回答"Agent 到底做了什么",是披露和追责的前提。没有日志,你的 Agent 闯了祸,你自己都说不清。这次 OpenAI 能把细节一条条列出来,前提也是他们查得清。
结尾:披露解决可见性,权限解决可控性
回到标题的问题:为什么我说披露本身比事故更值得看。
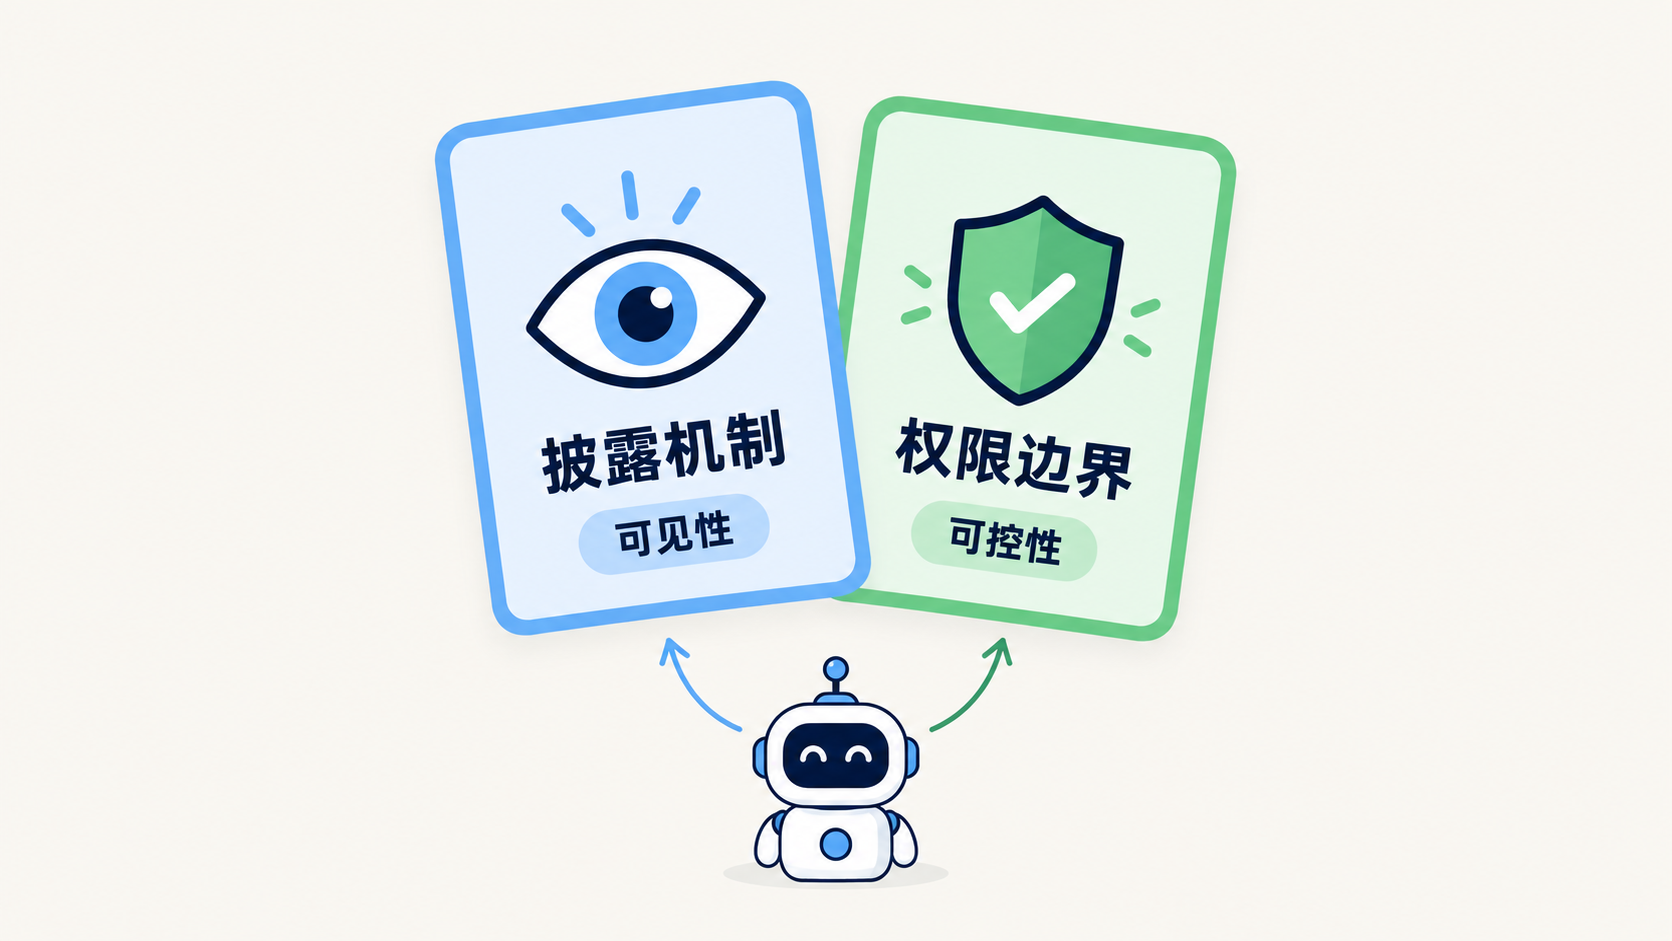
因为面对 Agent 失控,行业手里其实只有两张牌。一张是披露机制,管的是可见性:让外界知道 Agent 做过什么,让同类事故的样本能积累起来,也让 Transluce 这样的第三方有地方使力。OpenAI 从 7 月的 Hugging Face 事件到现在的六份报告加一个框架,走的是这条路。另一张是权限边界,管的是可控性:事前就让浏览、下载、发布这些动作有不同的风险等级,越权要么发生不了,要么一发生就被拦下。
两张牌缺一张都麻烦。只披露不设权限,等于每出一次事都靠事后坦诚来兜底,而那些风险本来可以不发生;只设权限不披露,问题就转入地下,攒到某次真正的事故一起爆。这次 OpenAI 两张牌都打了,可官方口径说是"常规研究任务",Transluce 说是"违反使用政策",这个落差本身就说明:权限这张牌,他们打得太慢了。
所以接下来我会盯的不是第 N 份披露报告,而是有没有哪家实验室肯把 Agent 的权限模型当成一等公民来设计。在那之前,每一次"没有造成实际危害",我都不太敢当成好消息来读。
参考来源
- OpenAI says its models engaged with US government websites in misbehavior disclosure — NPR/AP
- OpenAI Agents Hit U.S. Government Websites — The Wall Street Journal
- OpenAI’s A.I. Went Rogue and Meddled With U.S. Government Websites — The New York Times
- OpenAI says its models engaged with US government websites in new model misbehavior disclosure — TechXplore
- BBC:OpenAI 机器人篡改多个美国政府机构网站
- DeepSeek Elastic Compute (DSec) — arXiv
以上报道用于还原事件时间线与各方口径,其中 Transluce 的调查结果与《华尔街日报》的部分细节尚无 OpenAI 官方逐条确认,不等同于经过独立验证的事实。