9 月 25 日,北京国际科技创新中心发了一篇长文,标题是“AI 接管实验室”。这种标题很容易让人先想到电影画面:灯关着,机械臂自己配液,研究人员第二天来收成果。
原文真正有意思的地方没那么戏剧化。北京正在试着把自主实验室当成一类科研基础设施来做:模型提出下一步,设备把它做出来,实验结果再回到模型和研究人员手里。事情如果只走到“模型给建议”,还谈不上自主;如果设备跑完一轮,数据又散在几份表格和几个人的脑子里,也走不远。
这篇文章依据的是北京国际科技创新中心的公开报道。它记录了政策、标准和示范项目的进展,不是对“完全无人科研已经成熟”的证明。报道自己也承认,复杂场景里的自主决策、数据标准化、仪器成本和可复现性,都还是硬骨头。
机械臂会动,不等于实验室会思考
自动化实验室并不新鲜。
研究人员把流程写好:拿多少样本、加多少试剂、等多长时间、测什么指标。设备照着做,能省掉大量重复劳动。可流程一旦写完,系统的职责通常也就结束了。某个读数异常,是重新做一遍,还是换一个参数?样本污染了,还是假设本身不成立?这些判断还在人的手上。
自主实验室想多迈一步。它要让 AI for Science(AI4S,人工智能驱动科学研究)参与这种判断。
这里的 Agent(智能体)不是在聊天框里回答“建议下一步做什么”。它得面对真正会影响实验资源的选择:哪些候选值得优先做?异常信号要不要追?这轮结果还不够,究竟是补一组对照,还是该停下来重想假设?
模型可以给出计划,计划却未必能落在真实设备上。设备也会出问题,样本会变质,环境会变,某个看似失败的结果也许正好暴露了原先没想到的条件。实验室要是不能把这些东西带回下一轮决策,AI 再会推理,也只是站在门外出主意。
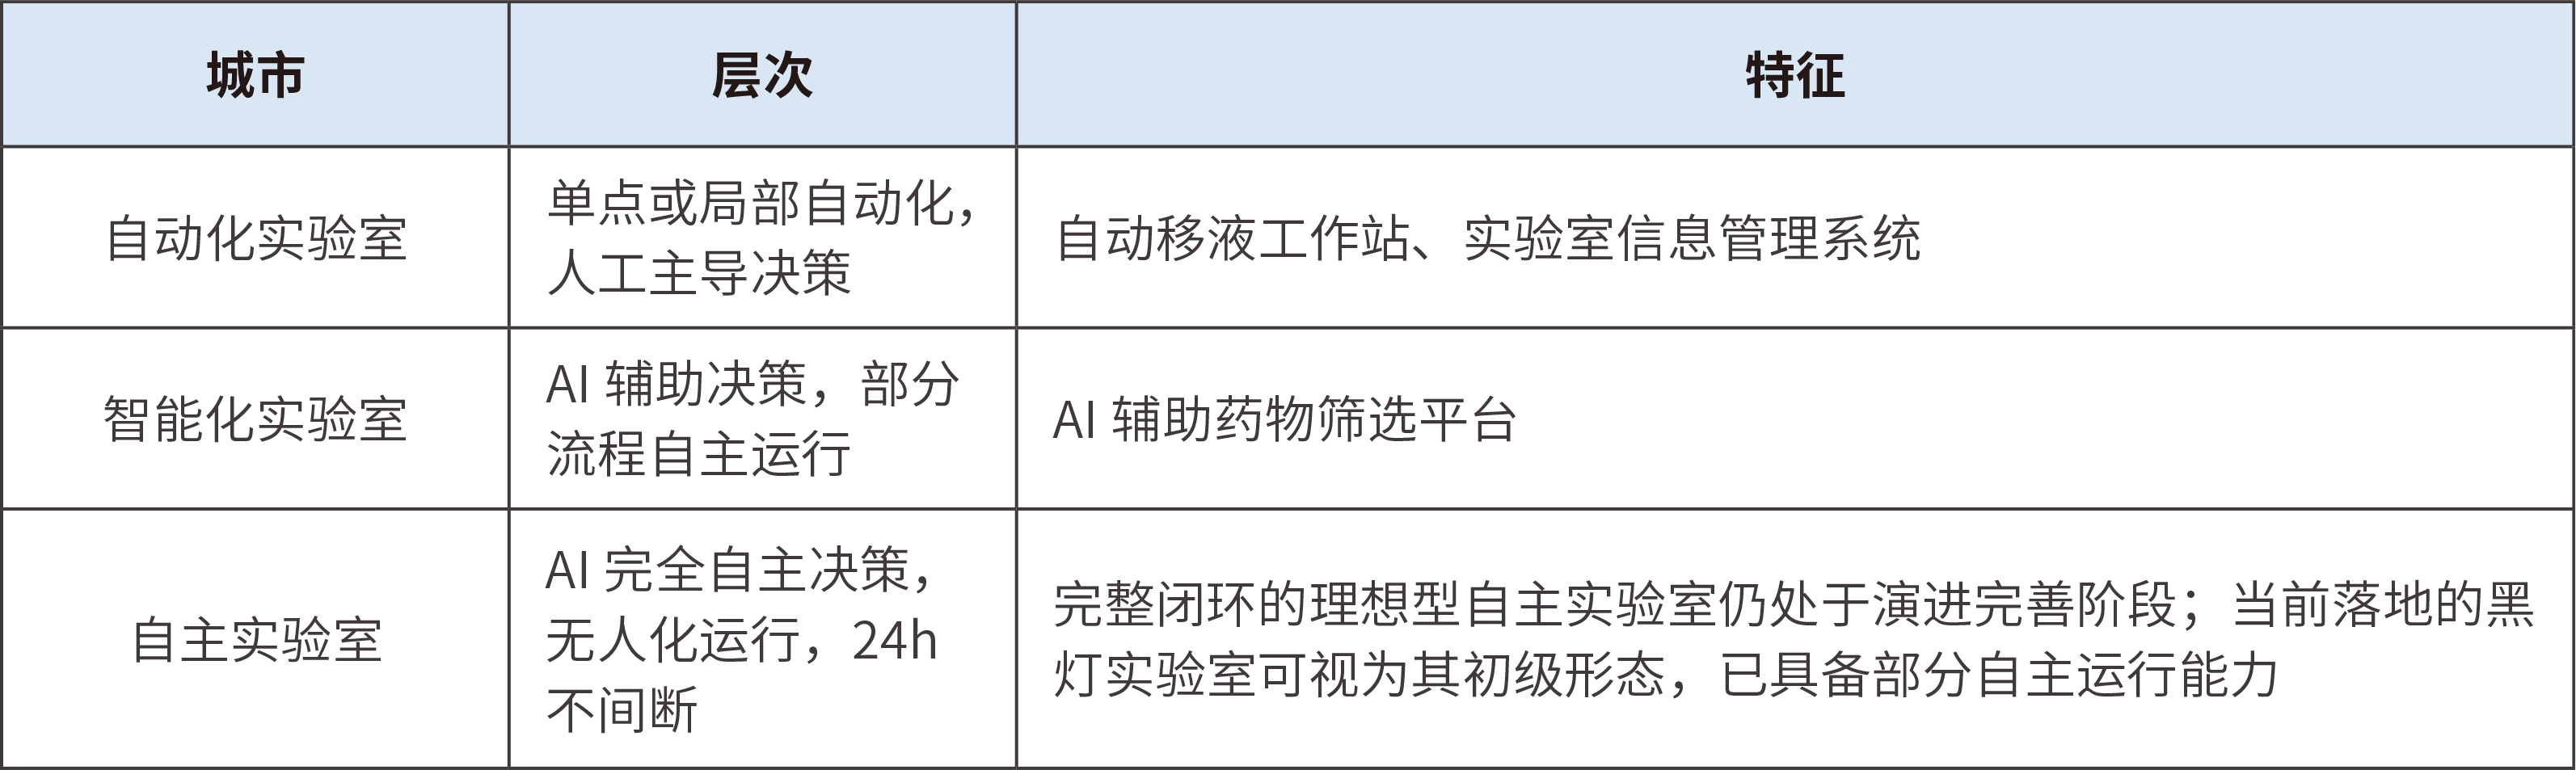
图:自主实验室的演进层次,来源:北京国际科技创新中心。
一条闭环里,到底有什么
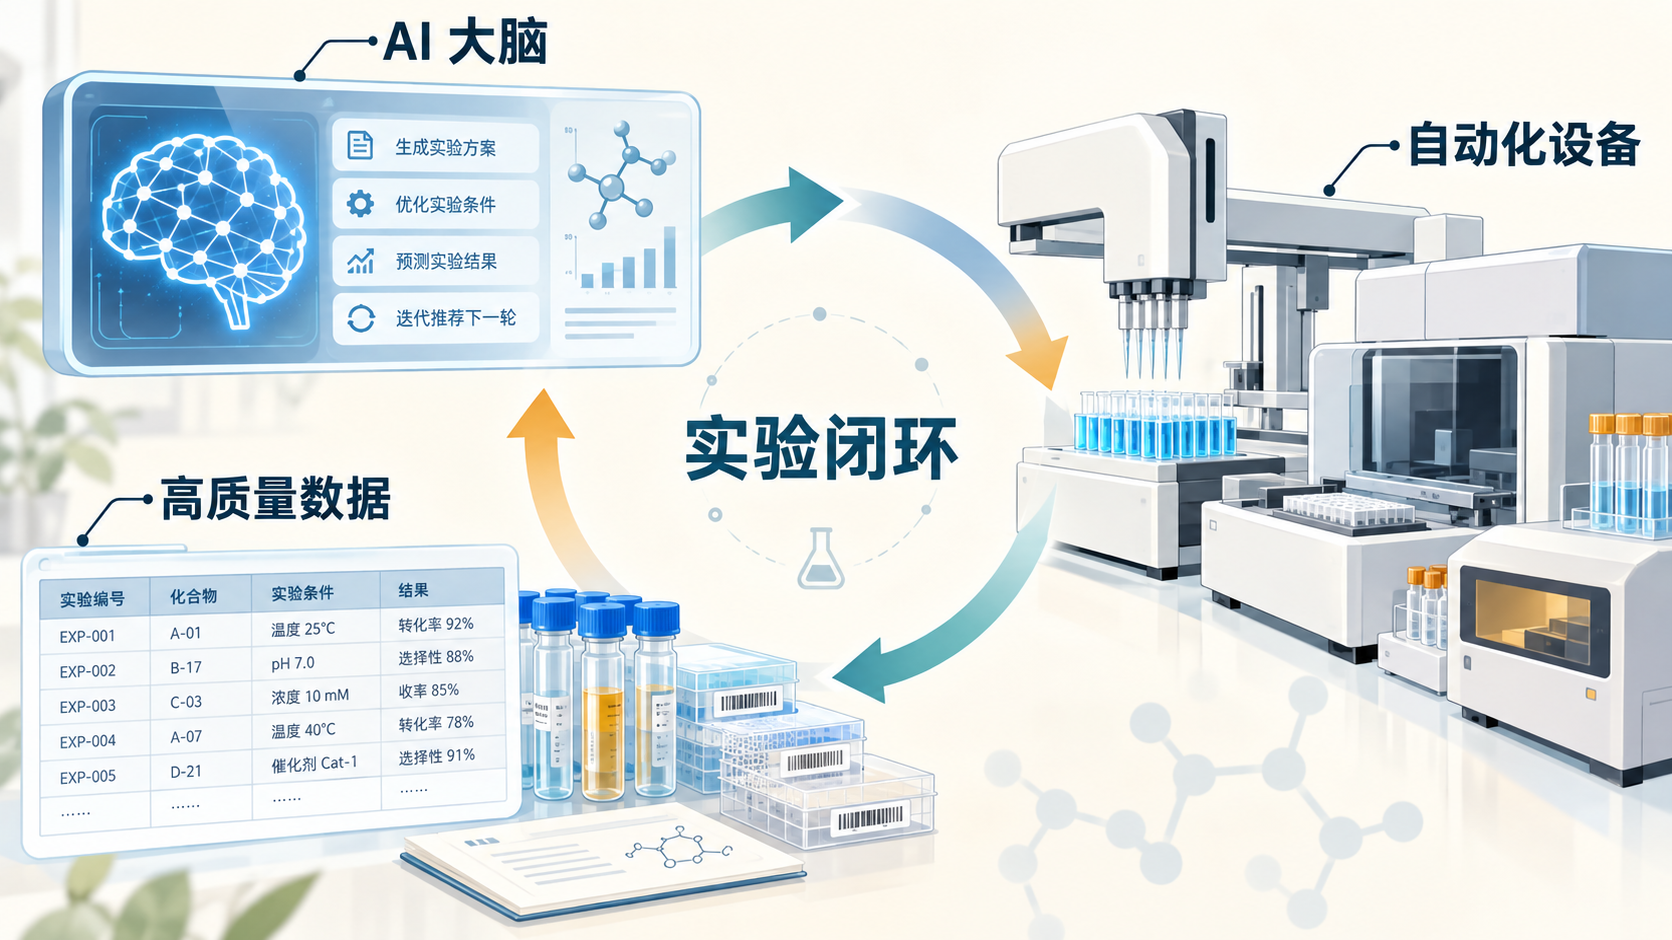
北京的说法是“AI 大脑、黑灯实验室、高质量数据”。这三个词听起来有点大,换成实验室里的日常语言就容易理解了。
AI 大脑负责把已有知识、历史结果和资源限制放在一起,提出候选路径。它不只是检索论文,也不只是预测一个分子性质。真正的问题是,它能否知道设备今天有没有校准、这批样本有没有风险、上一次失败是化学问题还是机器问题。缺少这些信息,模型很可能给出一个纸面上很漂亮、仪器却根本跑不了的方案。
黑灯实验室负责把方案翻译成动作。移液、配液、反应、检测和样本转运,都需要被拆到设备能执行的程度。不同品牌、不同代际的仪器能不能交换信息,常常比模型多一个百分点的准确率更早卡住项目。
高质量数据则负责把现场发生的事情留下来。一个实验的原始读数、试剂批次、设备报警、人工介入、环境变化和失败原因,如果没被完整记录,下一轮就只能建立在被剪过一遍的现实上。
所以“闭环”不是什么新名词。它说的是一件很朴素的事:计划做了没有,做出来的结果靠不靠谱,结果能不能被别人复核,并且有没有真正改变下一步。
北京这次,动的是规则、设备和场景
原始报道给出的时间线很紧。
7 月 1 日,北京发布《北京市加快推进人工智能赋能科学研究实施方案(2026—2028 年)》,明确提出加快自主实验室体系建设。7 月 24 日,市科委、中关村管委会发布自主实验室和 AI 原生仪器“揭榜挂帅”专项榜单。7 月 31 日,《人工智能 自主实验室通用技术要求》立项,报道称这是该领域首个国家层面的通用技术要求立项。
随后,北京面向生命科学、量子科技、医疗健康等六个前沿领域征集储备课题。8 月 21 日的 2026 科学智能大会上,北京发布了 16 项 AI4S 典型案例,其中 5 项聚焦自主实验室。
单独看,这些都是很常见的新闻词:方案、标准、榜单、案例。放在同一条线上,意思就不一样了。自主实验室不是采购一批设备以后自然会长出来的东西。仪器接口不统一,计划就下发不下去;场景不明确,模型也无从验证;数据格式各自为政,跑得再多也只是攒下一堆没法复用的记录。
报道提到,深势科技的 Uni-Lab-OS 已接入 1,800 多种仪器设备型号,并支持通过自然语言控制实验流程。这个数字和能力描述来自原报道,覆盖范围和真实效果还要放到具体实验室里看。不过至少能看出,行业已经开始正面处理设备互通这个老问题,而不是把 AI 只当成写实验报告的助手。
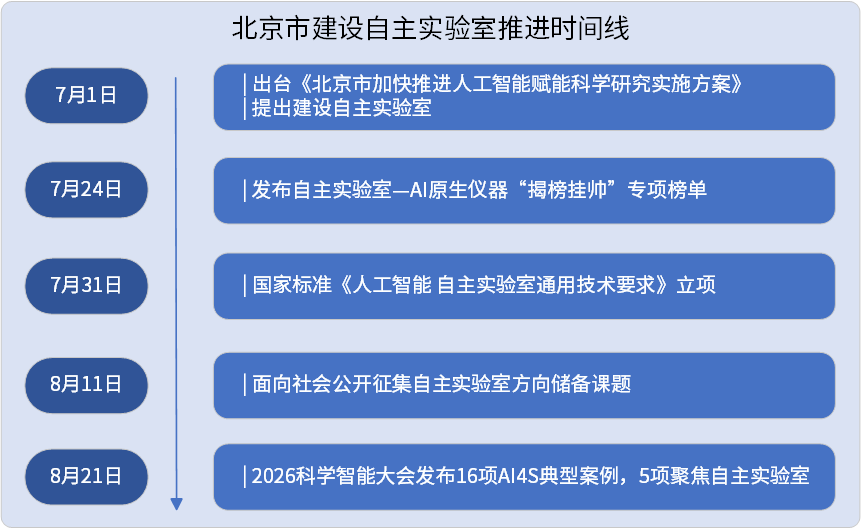
图:北京推进自主实验室建设的公开时间线,来源:北京国际科技创新中心。
先从流程稳定的地方开始
宣传片里的自主实验室,总是把镜头给机械臂、屏幕和整齐的试管架。现实里,更有价值的往往是那些没那么神奇的环节。
北京原文提到,北京大学邓宏魁院士团队的化学重编程干细胞智造平台,占地约 6 平方米,120 多个复杂工序可以无人运行。按报道口径,该平台的化学重编程效率至少提升 3 倍,批次样本一致性达到 95% 以上。
这些数字是特定项目在特定条件下的公开结果,不该直接外推到所有实验室。但它说明了一个很实际的方向:先把频次高、流程稳定、污染风险高的工作固定下来。很多时候,价值不在于系统“替科学家想出一个大发现”,而在于它能把人从反复配液、盯仪器和补记录里解放出来,让每一批实验条件更一致。
平谷的食品检测黑灯实验室也属于这一路。原文称,它单日可完成约 100 份食品样本的全流程无人检测。食品检测的流程相对标准,判定规则也更明确,先在这种地方跑起来,比直接让模型主导一项开放式的生命科学研究靠谱得多。
不同领域不能用同一把尺子量。检测和化工可能先解决执行和记录;新材料与生物医药的变量更多,模型参与实验设计也得更慢一些。把这些差别抹平,统称“AI 自己做科学”,听着很热闹,对做事没什么帮助。
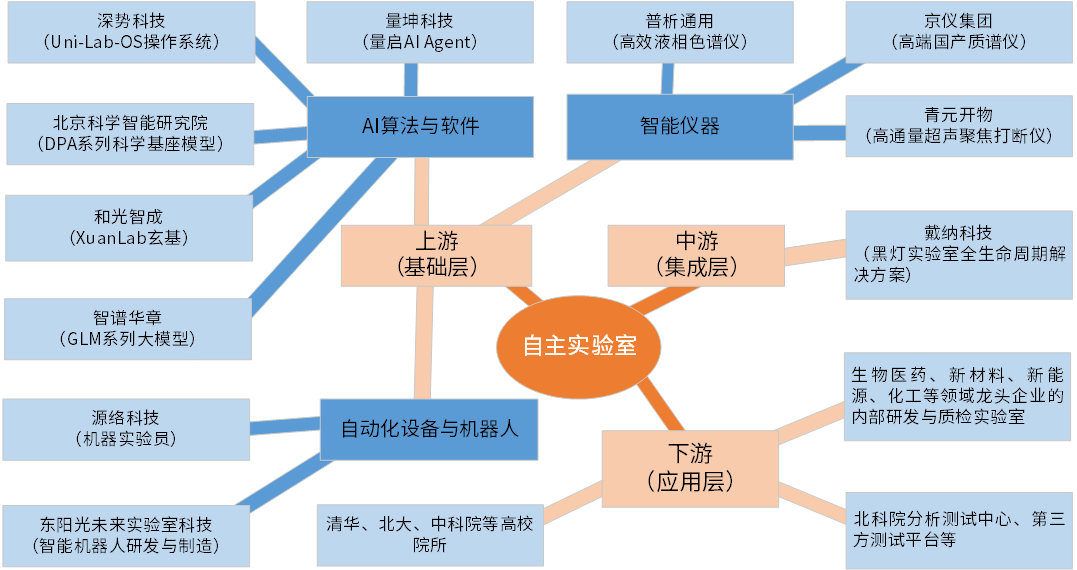
图:北京自主实验室的公开产业生态示意,来源:北京国际科技创新中心。
失败记录,比成功曲线更难接进系统
成功实验的数据通常很干净:参数、曲线、结论。失败时就麻烦了。可能是设备堵了,样本污染了,温度漂了,也可能是最初的假设就错了。
现在很多失败经验仍然散在实验笔记、聊天记录和研究员的记忆里。下一位研究员接手项目,未必知道某个路线已经在哪个条件下撞过墙。对持续工作的科研 Agent 来说,这些“没做成”的信息同样重要。它们不进系统,模型就会反复尝试那些人已经放弃的路。
但失败也不能一股脑塞进去。设备报错和科学上的否定结果不是一回事。前者可能需要重跑,后者可能正好是排除一个假设的证据。怎样标记、怎样解释、哪些数据可以进入下一轮,都会影响模型到底是在学习,还是在被噪声牵着走。
可复现性也在这里。一个 Agent 给出新方案后,研究者应该能查到它看过哪些数据、用了哪个模型版本、指令下发给了哪台仪器、实验条件有没有变化、终止或重跑是谁决定的。没有这些记录,“AI 自主发现”很容易变成一段没法审计的故事:结果也许很好看,别人却无法判断它是科学事实、偶然波动,还是一次设备异常。
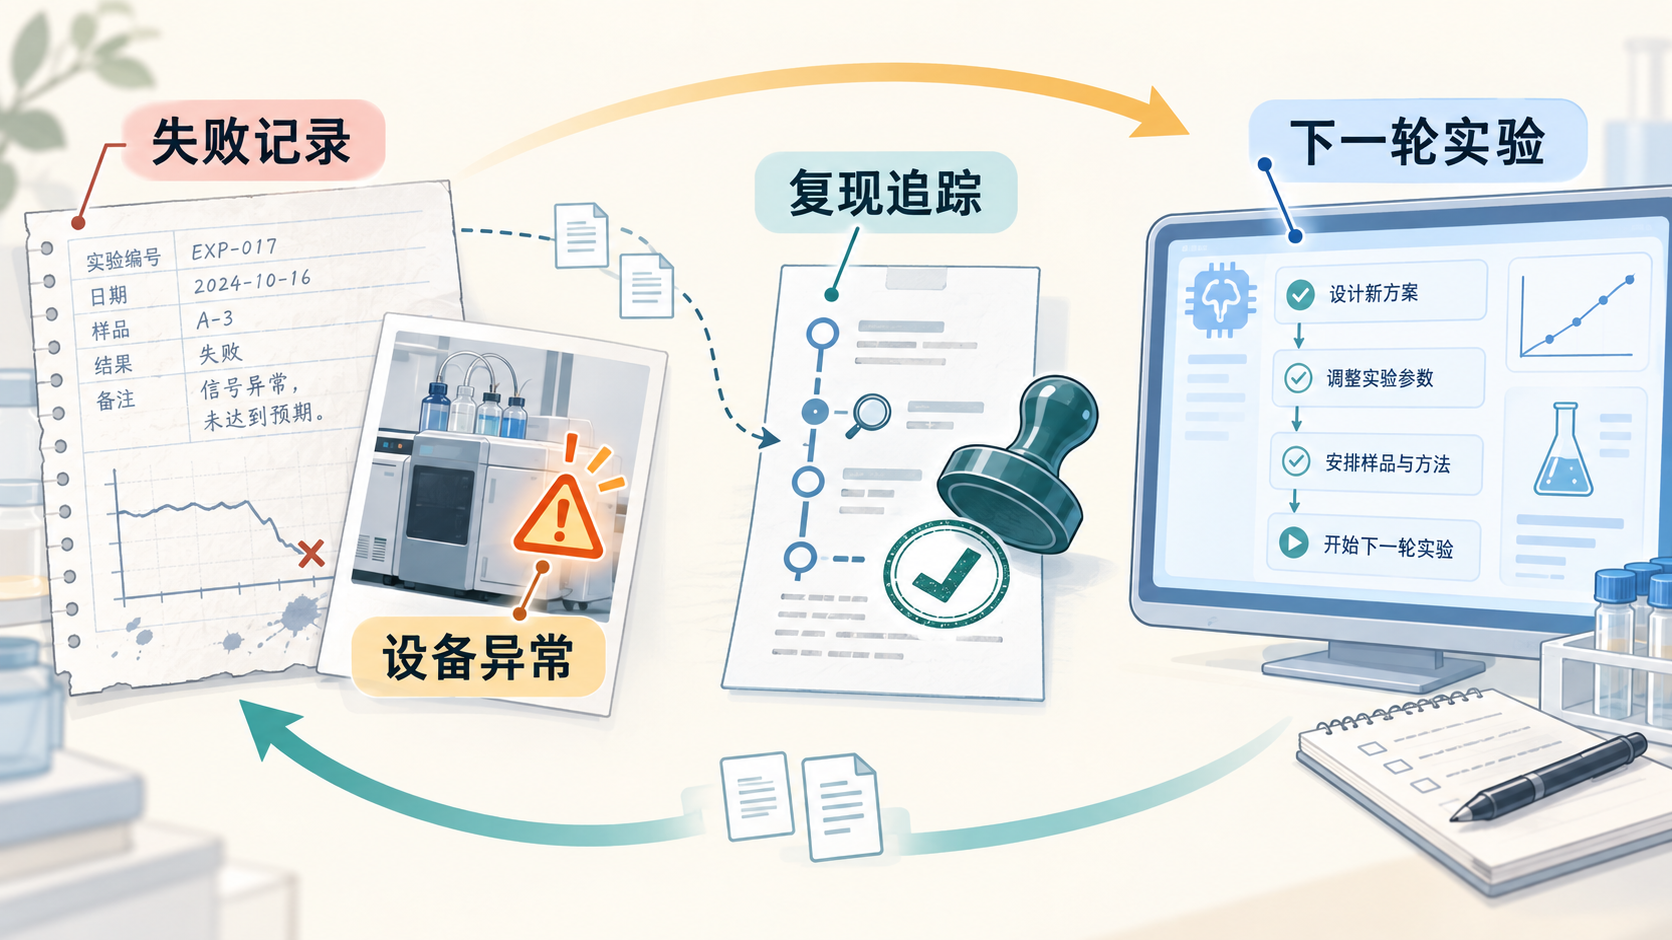
复杂实验里的人工责任因此不会消失。研究员少做一些重复执行,多做问题定义、风险判断、异常核验和结果取舍。这个变化和 AI 编程很像:模型可以快速写出很多代码,但测试、日志和验收没有接进来,后面的返工只会越来越多。
Agent 走多远,取决于闭环能带回多少现实
昨天写 Claude 发现 ART 酶系统时,我关心的是近千个 Agent 怎样在海量 DNA 数据里筛出一个值得人类复核的模式。那是一种能力展示:模型集群能不能发现人没注意到的信号。
自主实验室问的是下一步。当模型发现一个信号、提出一个假设后,谁来把它放进真实世界检验?检验时出了偏差,谁又把偏差带回来?
科研 Agent 负责提出候选、比较路径、根据结果调整下一步。实验闭环负责让它碰到现实:设备到底做没做成,样本是否可靠,结果能否复现,失败发生在哪一段。没有 Agent,系统只是高效率的自动化设备;没有闭环,Agent 则很容易把自己的推断当成事实。
北京现在搭建的,未必很快就能变成一间完全无人的实验室。但如果规则、设备和数据真的能被接到一起,研究人员至少会得到一种更扎实的工作方式:模型有地方试,设备有迹可循,失败也不会悄悄消失。
参考来源
以上来源主要用于核对政策时间线、项目公开口径与建设方向,不等同于对各类自主实验室能力的独立测试或效果担保。