本文事实基于央视网转发中央广播电视总台中国之声的报道原文(10 月 27 日 02:11 发布)、中文在线 6 月《投资者关系活动记录表》的媒体转述、OpenRouter 公开榜单数据的二手引用,以及整点 AI 10 月 27 日的核查文章。汕头案例的数字(日均 230 亿 token、图片成本 5 毛到 2 毛、10 亿元 2000P 算力集群、海外服务中心 10 个建成年底 50 个)均直接引自央视报道原文;55% 与 58% 两个数字的原始出处和口径问题,按整点 AI 的核查链引用,未接触原始备案文件。
10 月 27 日早上,两条新闻撞在了一起。
一条是央视。中央广播电视总台中国之声凌晨发了篇长文,给一个新词盖了章:词元出海。按报道的定义,中国 AI 大模型企业把电力、算力优势转化成高性价比 token,通过 API 向全球提供推理服务,按处理量计费,这被称为「看不见的外贸」,算力和电力的「数字化出口」。
另一条在微博。「中国 55% Token 消耗用于短剧」的话题这几天又翻上来,跟着的老论调是那句「美国用 AI 提升生产力,中国用 AI 拍逆袭短剧」。
同一天,同一个国家的 AI 产业,供给端在把 token 装船出口,消费端最大的量烧在短剧上。这两件事放在一起读,比分开读有意思得多。
先说「词元出海」:汕头跑通了什么
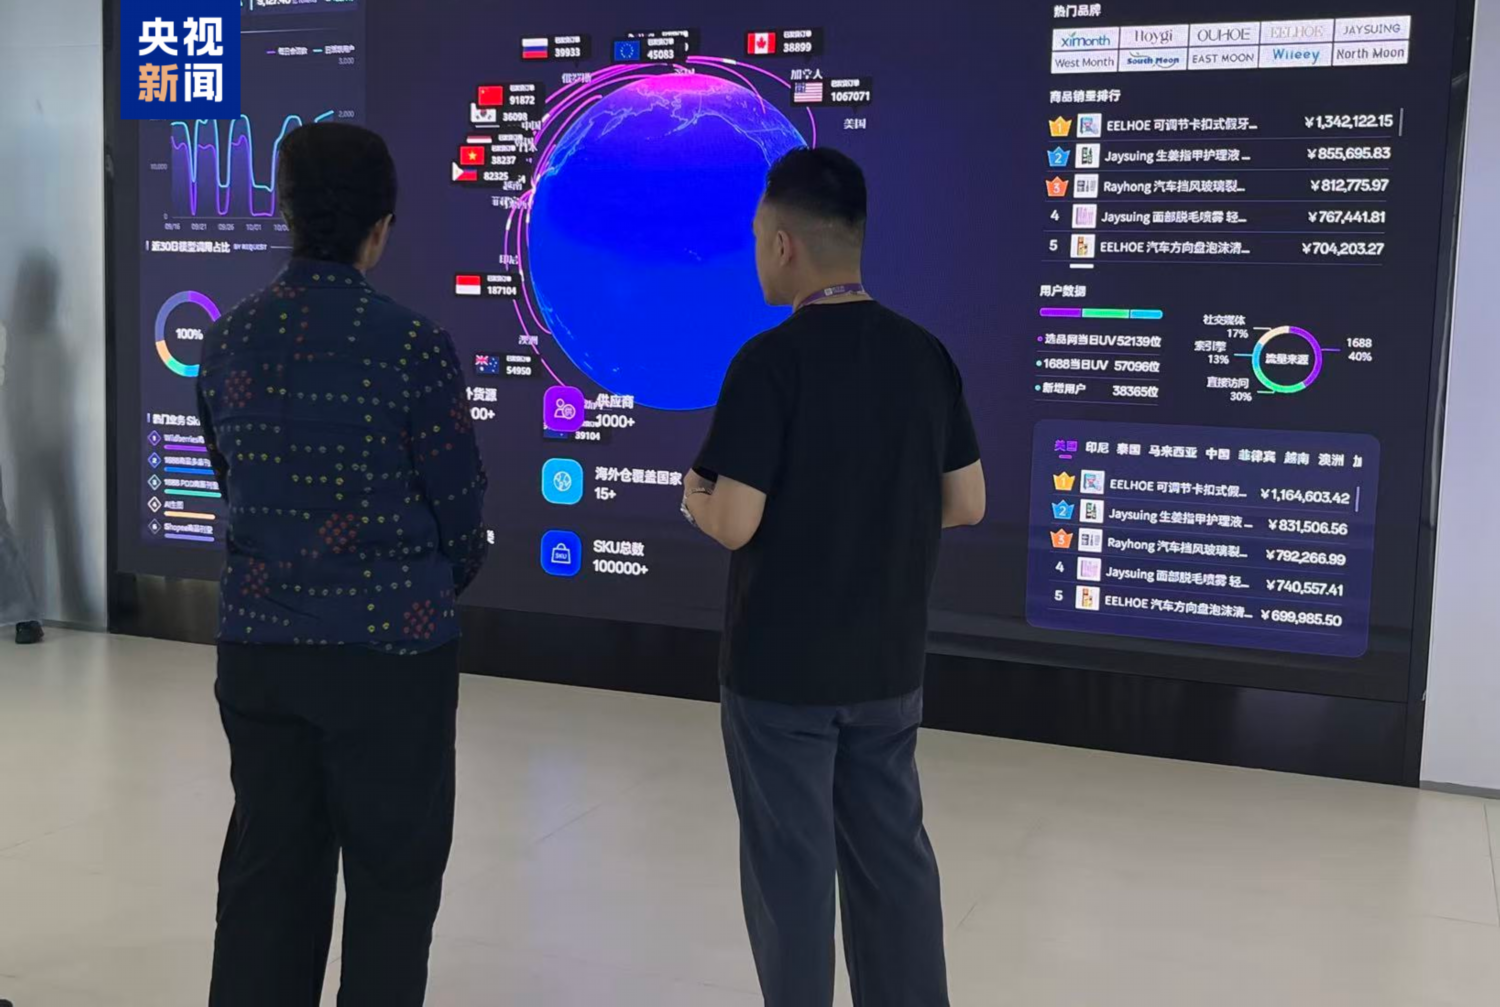
央视这次报道的主角是汕头。今年 4 月,汕头跑通全国首个城市级词元出海全链路闭环,也是国内第一个跨境数据专用通道试点。链路长这样:海外用户的数据调用需求走合规通道进入汕头,在专门机房完成计算和推理,结果再经海底光缆传回去。
数字比概念具体。
一家做跨境电商的企业,15 个国家布了 30 多个海外仓,2.5 万多种海外货源。它的跨境电商 AI 智能体,年初每天消耗的 token 还不到 5 万个,现在是日均 230 亿,增长了几百万倍。老板说成本反而在降:一张图的生成费用「曾经一度就是 5 毛多,前阵子还一直是 3 毛,最近才打到了 2 毛」。
另一家信息产业公司部署了「国际词元工厂」,1 号工厂投了 10 个亿,建了 2000P 的算力集群,专门面向海外供词元。
为什么是汕头?论气候和电价,西北比它合适;论联系海外侨商,厦门也不差。当地官员曹安定的解释是,集齐风电、侨商、海底光缆三大条件的城市很少,再加上电网稳定性和工程师调优能力。汕头考虑过「外数中储」「外数中训」「外数中算」三种模式,单纯存储拼不过别人,跨境训练有合规风险,最后选了「外数中算」里的词元出海。
他给这件事的定性是:「词元出海本质上应该是中国的人工智能服务能力出海。」
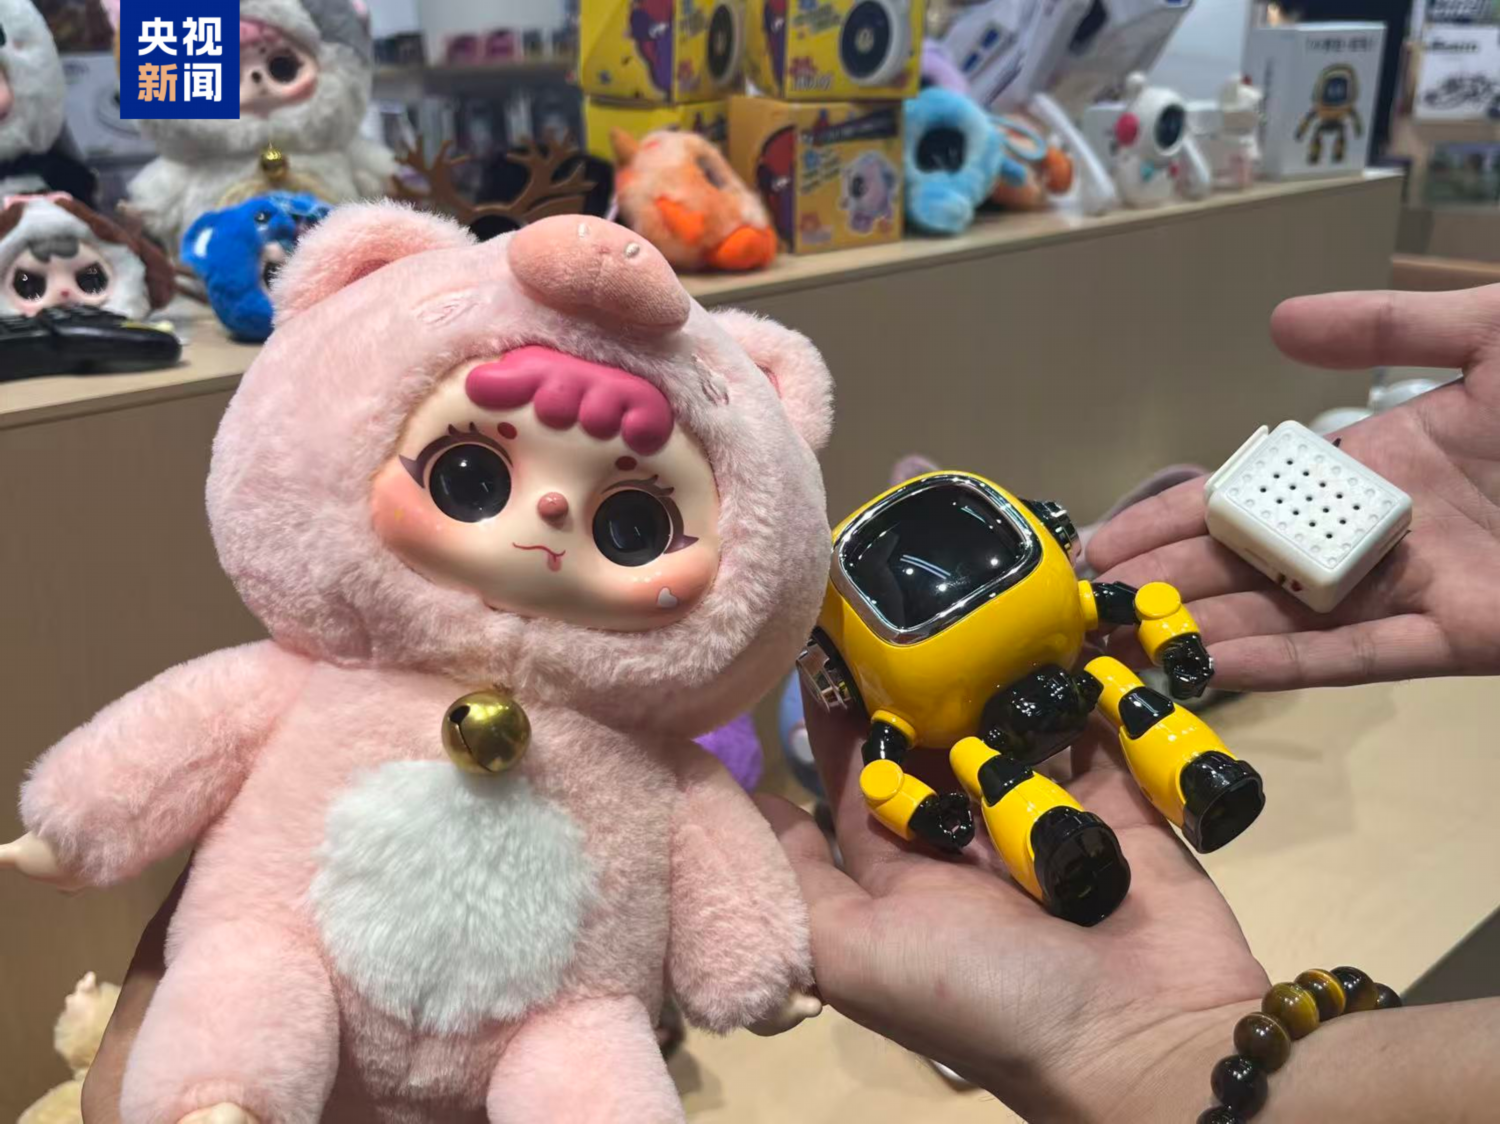
配套动作也在铺:算力券、词元券补贴,海外人工智能服务中心已经建了 10 个,年底力争 50 个。连当地的玩具产业都被卷进来:海外用户玩 AI 玩具,背后调用的是汕头的算力。主理人的原话:「它现在占有的份额很小,但是我觉得它已经迈出了很大的一步。」
再说 55%:这个数字是从哪来的
「中国 55% Token 消耗用于短剧」不是这几天才出现的。10 月 10 日,一则帖子在社交平台传开:中国 55% 的 token 消耗用于短剧、短视频和娱乐内容生成,而美国 58% 的 token 消耗用于编程、研发和企业自动化。一进一出,对比拉满,热搜顺理成章。
有媒体顺着数字往回挖,挖到了源头。
中国的 55%,出自 A 股上市公司中文在线今年 6 月的一份《投资者关系活动记录表》。原文说的是:国内 AI token 消耗中,短剧与视频生成占 55%,电商与营销占 24%,软件开发占 15%。
美国的 58%,被帖子笼统归为「公有 API Token 用量」。追下去,来自 OpenRouter 平台的数据:2025 年末 OpenAI 模型在该平台上的编程类和技术类 token 各占 29%,加起来 58%。
把两个数字并排放好,问题就出来了:
| 中国 55% | 美国 58% | |
|---|---|---|
| 原始出处 | 中文在线投资者关系记录(2026 年 6 月) | OpenRouter 平台榜单(2025 年末) |
| 统计范围 | 一家公司视角的「国内 AI Token 消耗」 | 一个平台上的「OpenAI 模型」用量 |
| 原始分类 | 短剧与视频生成 / 电商与营销 / 软件开发 | 编程 / 技术 |
| 统计主体 | 未披露完整口径 | 未含其他平台、其他模型 |
这不是同一把尺子量出来的两个数。一家内容公司的客户结构,和一个开发者平台的 token 流向,中间隔着不知多少个口径。截至目前,还没有一份按统一标准比较中美 AI 应用场景的 token 消耗统计。
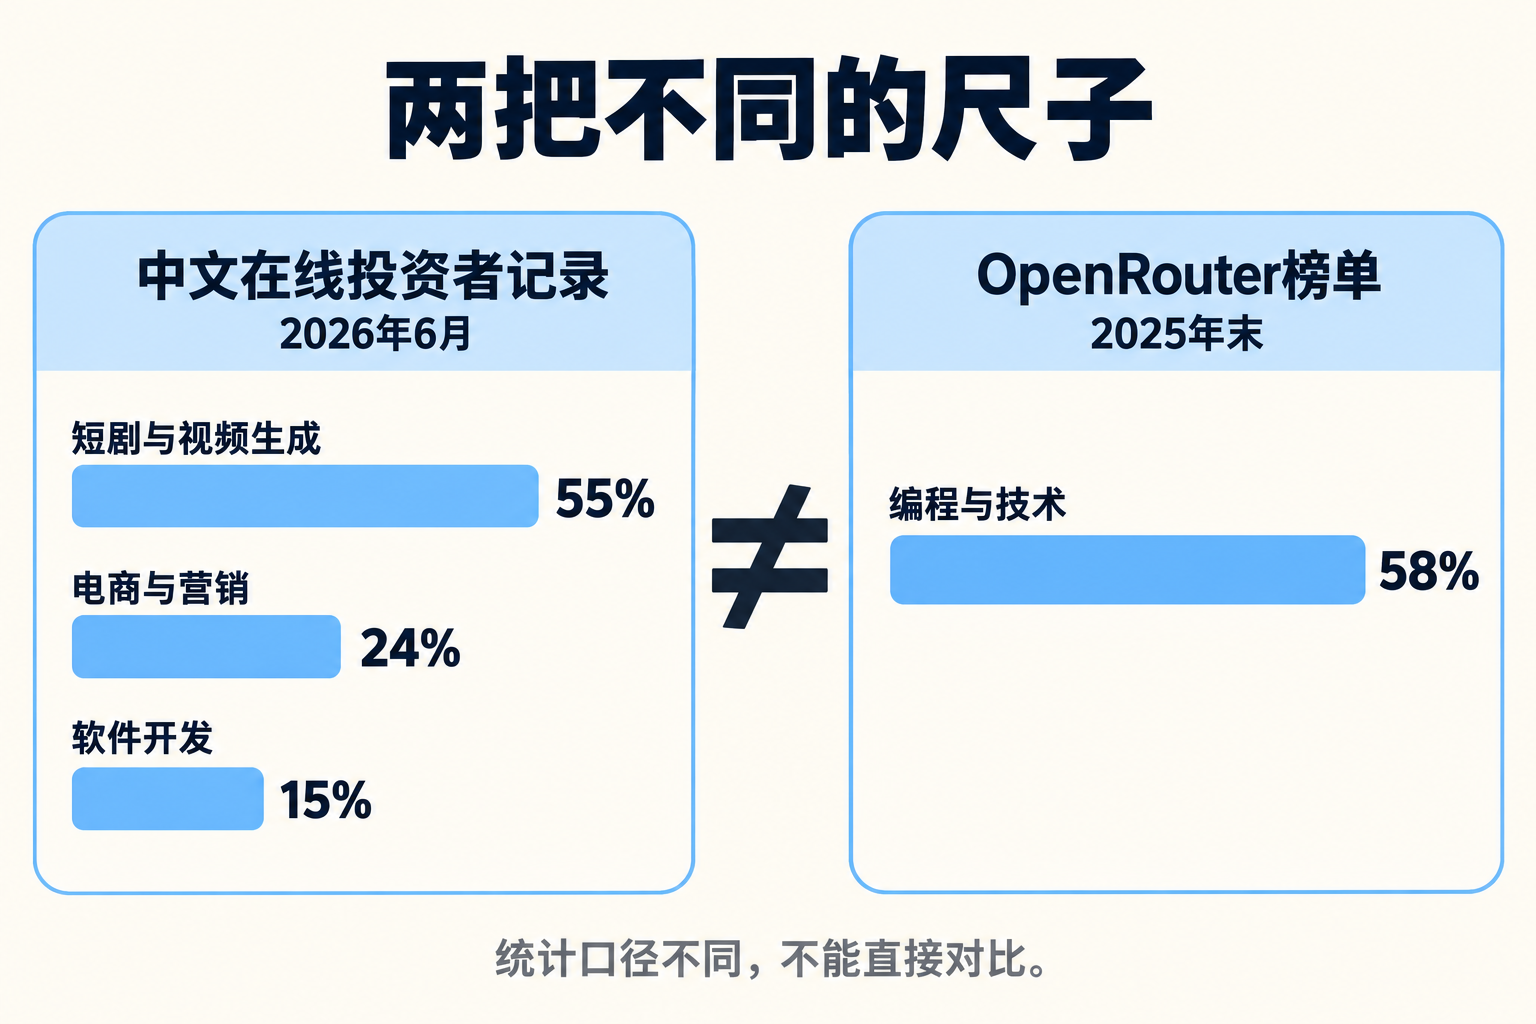
传播链路上还发生了三次偷换:「Token 消耗量」变成了「AI 算力」,「短剧与视频生成」缩水成「爽剧」,「软件开发」膨胀成「研发」。每一次改写都让对比更锋利,也更失真。
技术层面还有一层:文本 token 和视频 token 虽然叫同一个名字,计量方式并不一致。一个多轮交互的 agent 累计处理的 token 量,可能比一次视频生成任务还多。把两类 token 简单加总再下判断,本身就是会误导的做法。
短剧烧 token,冤不冤
就算口径统一、数字打折,短剧和视频生成在中国的 token 盘子里占大头,这个基本盘大概率是成立的。问题是怎么解读它。
读成「中国人只拿 AI 娱乐」,漏掉的东西不少。
红果短剧的日均使用时长已经超过抖音和微信,逼得腾讯重新押注短剧。快手财报显示,今年第二季度平台 AIGC 短视频营销素材的投放消耗同比增长超过 70%。烧 token 的不只是剧情,还有电商商家批量制作营销素材的流水线。字节旗下的海外短剧应用 PineDrama,上线不到一年全球下载破 1 亿。短剧也不是中国人的独有口味。
AI 短剧的盛行,是中国既有互联网产业能力的一种延伸。短视频平台、短剧平台、直播电商的商业化机制早就成熟,视频生成模型只是恰好切进了这些行业降本增效的需求。内容工业在哪里发达,模型就在哪里先找到活干。
这和「能力天花板」是两回事。做逆袭短剧的 token 和做客服 agent、做跨境电商素材的 token,在很多情况下是同一批模型、同一批机房。
两条新闻拼起来读
现在可以把早上那两条新闻拼回去了。
供给侧,央视报道里的汕头在把 token 当外贸品卖:跨境电商的智能体一天烧 230 亿 token,背后是 15 个国家的仓库在自动拣货、生成素材;AI 玩具卖到国外,推理调用回汕头。消费侧,热搜话题里的中国 AI 用户,把最大的一股 token 流量给了短剧和营销素材。
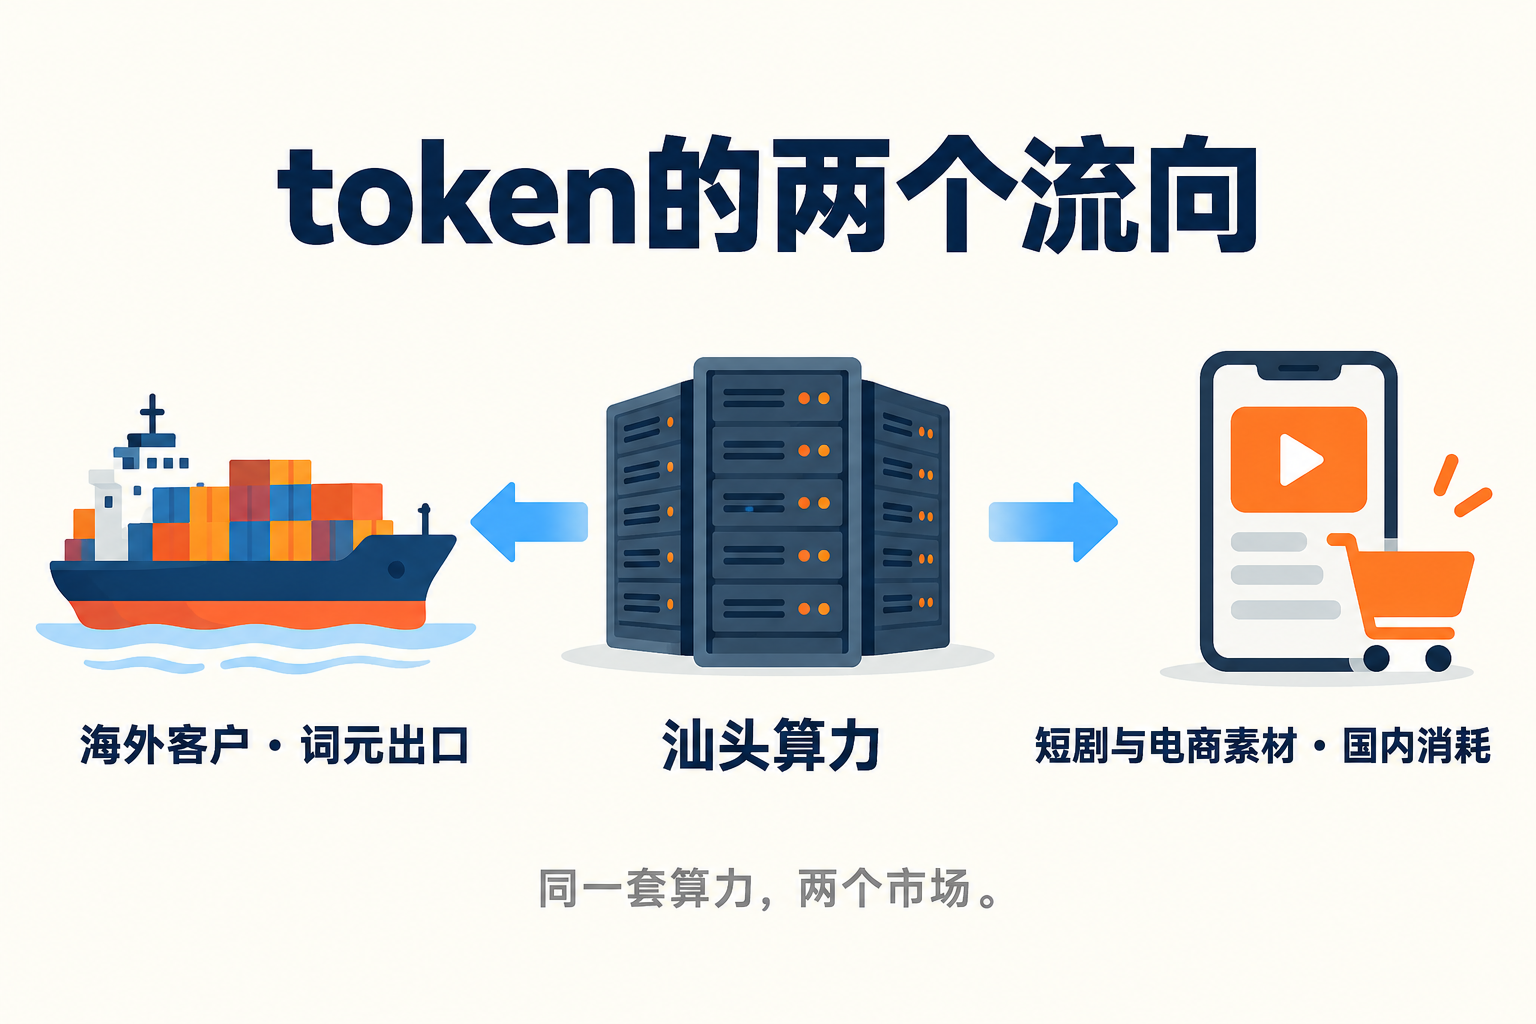
一边像是「生产力叙事」,一边像是「娱乐叙事」。但拆开看,两边其实是同一套逻辑:哪里有成熟的变现场景,token 就往哪里流。中国的内容工业和电商体系太发达了,发达到来不及等「高大上」的 AI 应用,模型能力一到位,短剧和营销素材先把它吃满。
有研究者把这组观察提炼成两种创新机制的分化:「从模型到应用」与「从应用到模型」。美国的技术突破常常先抬高模型能力,再催生工具和应用;中国则可能因为短剧、视频生成这些已有变现场景,反过来推着模型能力走。
哪种路径更好,现在下结论太早。但有一件事可以确定:评价一个市场的 AI 消费结构,标准不该是「场景体不体面」,而是效率提升最终流向了哪里。短剧降本省下来的钱进了制作公司的口袋,跨境电商一张图 5 毛降到 2 毛省下来的钱,变成了 15 个国家的海外仓。这些流向比热搜话题诚实。
词元出海也没什么宏大叙事,说白了就是把「电便宜、工程师多、产业链全」打包成按 token 计费的服务卖出去。汕头 4 月跑通闭环,到 10 月已经有上千家企业去咨询、近一两个月一堆城市去调研。生意的嗅觉比概念的定义跑得快。
写在最后
回到开头那两条新闻。
「词元出海」上了央视,官方话语开始给「卖推理服务」这种生意命名;「55% 烧给短剧」还在热搜上吵,大众对「AI 用在哪」的想象,仍然被场景的体面程度牵着走。一个产业的两面,被两条传播链各自截取了一半。
接下来一个月,有三个信号值得跟踪:
- 「词元出海」会不会出现第二个汕头:曹安定说自己分享经验几乎不保留,但也强调汕头的资源禀赋别的城市凑不齐。看下一个跑通闭环的城市拿什么组合入场
- 中文在线式的口径数据会不会被正名:如果有机构按统一标准重做中美 token 消耗统计,55% 这类数字的传播寿命就到头了
- 视频 token 的计价方式:文本和视频 token 计量不一致的问题,会随着视频生成用量暴涨变成定价体系里的真问题
token 不关心场景体面不体面,只关心谁在付费、付多少。央视报道里的 230 亿,和热搜里的 55%,记的是同一本账。
参考来源
- 「看不见的外贸」畅跑全球,词元出海为什么在这里实现?(央视网转中央广播电视总台中国之声,2026-10-27)
- 中美AI,输赢难道取决于短剧?(整点 AI,2026-10-27,含 55% 数字核查链)
- 中文在线《投资者关系活动记录表》(2026 年 6 月,经整点 AI 转述引用,未接触原始备案文件)
- 站内相关:价格战打到「零毛利」:MiniMax M3.1 Flash 把 $0.15 / 1M 写进了定价表(1020) / 中国 23 项 AI 技术入禁止出口目录(1019)
哪些内容尚未独立验证:中文在线投资者记录的原始文件未直接核对,55% / 24% / 15% 的分类口径以整点 AI 转述为准;「微博热搜」话题的具体排名与热度峰值未留存截图,仅确认话题存在与传播链路;OpenRouter 数据为 2025 年末快照,当前占比可能已变化;汕头「日均 230 亿 token」为该企业自报口径,未经第三方审计。