本文事实基于 MiniMax 官方博客(10 月 19 日发布稿)、Artificial Analysis 模型页、The Decoder 行业分析、r/LocalLLaMA 官宣帖、HN 第一首页帖(338 分 / 150 评论),以及多位 X 用户的实测推文。定价数字($0.15 / $0.60 / $0.015)与跑分(DeepSWE 73.7%、OSWorld V2 61.7、ALE 29.6、CyberGym 82%)均按官方与 Artificial Analysis 原文引用。Space Bunny 身份已由 MiniMax 官方与多个 X 账号交叉确认。
10 月 19 日,MiniMax 发布 M3.1 Flash。
API 定价 $0.15 / 1M 输入、$0.60 输出、$0.015 缓存输入,1M token 上下文,文本 / 图片 / 视频输入。输出端实测 200+ TPS,常规负载中位数稳定在 170+。Artificial Analysis Intelligence Index 42,比上一代 M3 高 13 分,与 GLM-5.3-Flash 持平,但落后 DeepSeek V4.1 Flash 1017。
模型权重 10 月 23 日开源。
Hacker News 当日把它顶到第一,338 分 150 条评论。r/LocalLLaMA 同步官宣帖。The Decoder 给出的标题是:「中国 AI 价格战无底线」。
这是 MiniMax 的 M3.1 Flash 真正的发布方式。
真正的彩蛋:Space Bunny
先说 M3.1 Flash 最值得讲的那一段,因为它比参数表重要。
在 10 月 19 日发布前,MiniMax 的一台模型以 Space Bunny 🐰 的匿名身份在 OpenRouter 上跑了 10 多天。它默默爬到 OpenRouter 调用榜前列,积累了超过 200 万亿 tokens 的真实使用数据,这是 2026 年最像「test in production」的中国模型发布。
X 上 @drh_linux(知名开源核心贡献者)以 88 赞 / 16K 曝光的转贴给出了最有代表性的一行评语:
「the smartest launch of the month wore a mask. no press release buys you eval data that clean.」
发布的同时,Vercel AI Gateway、OpenRouter、OpenCode 三处同步开放限时 0 元优惠,把已经在生产环境跑了 200 万亿 tokens 的模型,免费再开放给开发者。
这意味着 MiniMax 在发布日就有真实的 benchmark:不是闭门评测、不是 demo 视频,是 200 万亿 tokens 的盲投、16 万次用户选择、200+ TPS 的稳定运行,这才是「test in production」该有的样子。
价格:把 MiniMax M3 砍到 1/3
M3.1 Flash 的官方定价是 $0.15 / 1M 输入 · $0.60 / 1M 输出 · $0.015 / 1M 缓存输入。
对比上一代 MiniMax-M3 自己的定价($0.20 / $0.60 / $0.02),输入与缓存各降 25% / 25%,实际等效任务成本降 70%。官方原话:「usage costs by 70%」。
横向比一下同代竞争对手的输入价:
| 模型 | $ / 1M 输入 | 对 M3.1 倍数 |
|---|---|---|
| Claude Sonnet | $3.00 | 20× |
| GPT-4o | $2.50 | 16.7× |
| DeepSeek V4.1 Flash 1017 | $0.27 | 1.8× |
| MiniMax M3.1 Flash | $0.15 | 1× |
跑分上,DeepSWE 73.7%(M3.1 Flash 与第一梯队并列)、OSWorld V2 61.7、ALE 29.6(中文模型第一)、CyberGym 82%, Artificial Analysis Intelligence Index 42 与 GLM-5.3-Flash 持平,但实际任务成本只有 GLM-5.3-Flash 的大约一半。
这是一个清晰的策略选择:M3.1 Flash 不卷跑分榜第一,卷的是「质量够用 + 价格压到极致」。
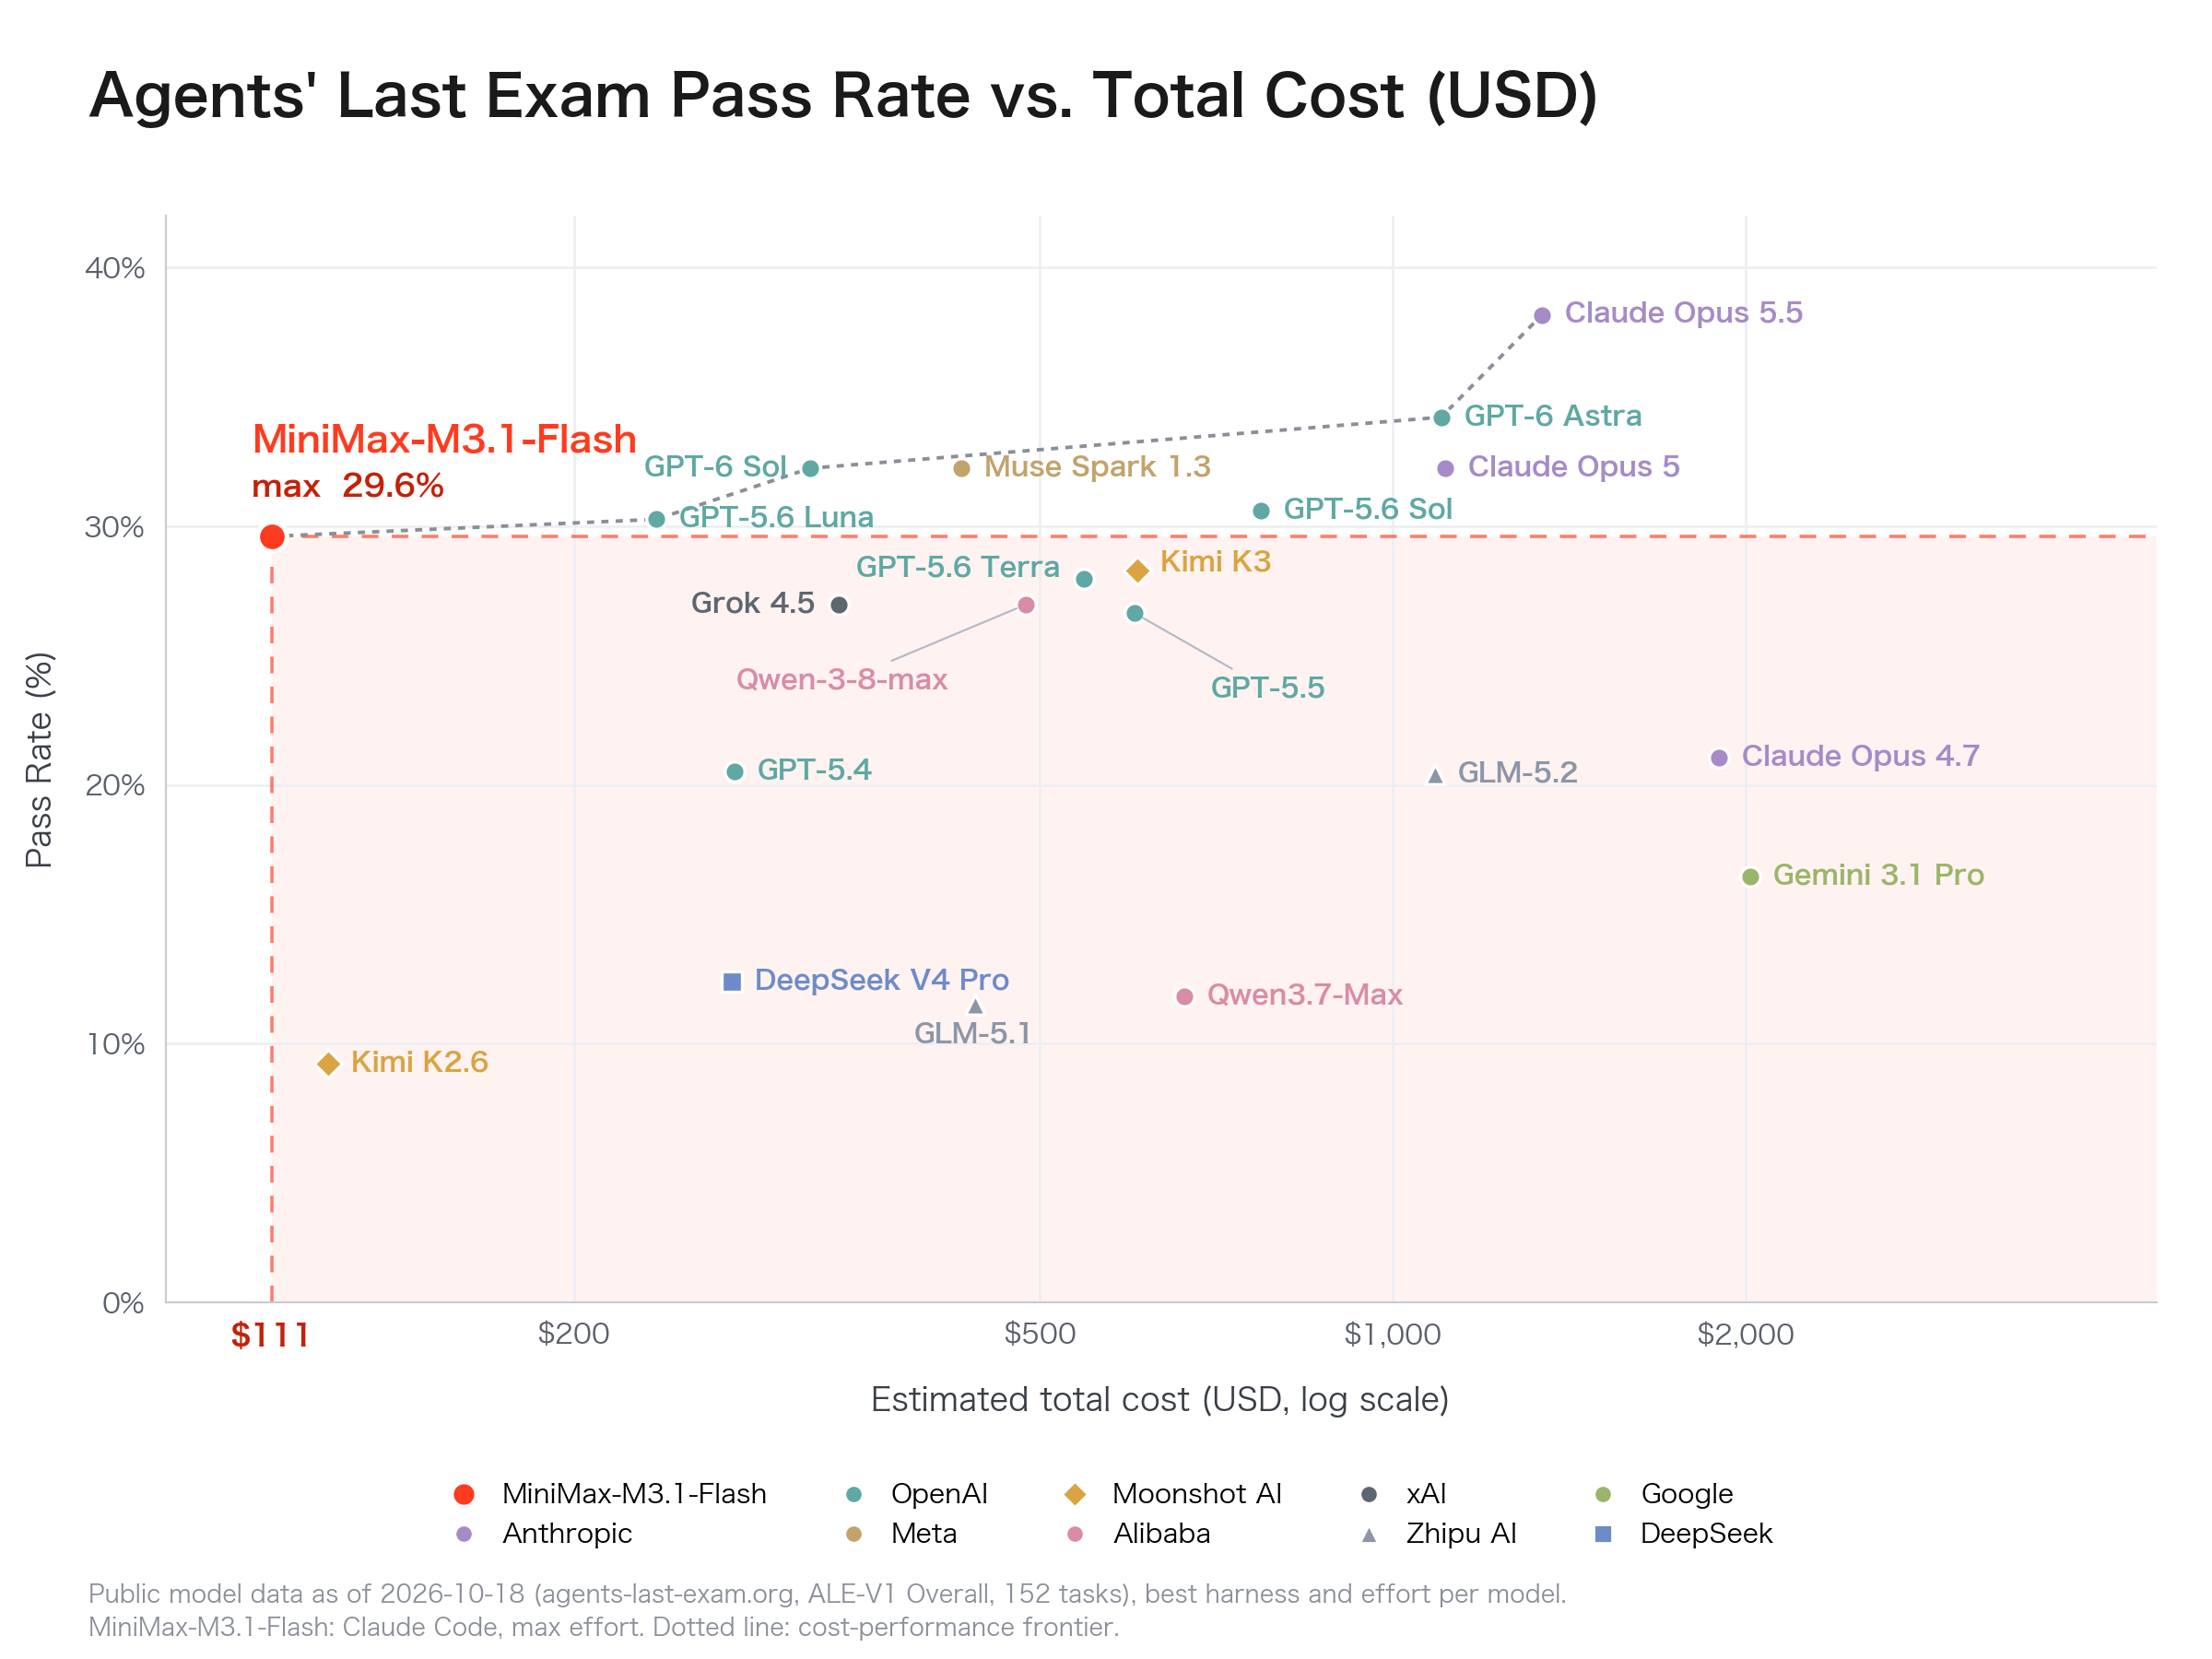
上面这张官方图比任何表格都直观。横轴是单任务总成本(对数刻度),纵轴是 ALE 通过率,虚线是「成本-性能前沿」。
M3.1 Flash 用 $111 的任务成本,拿到 29.6% 的通过率,落在前沿线上。它左侧那片红色 shading 区域就是「同样通过率、成本更贵」的部分,而 MiniMax 的点几乎贴着纵轴。
对比之下:Claude Opus 5.5 在 $2,000 附近、GPT-6 Astra 在 $1,000-1,500 区间,Qwen-3-8-max 与 Kimi K3 在 $500-800。M3.1 Flash 的任务成本是它们的 1/5 到 1/20。
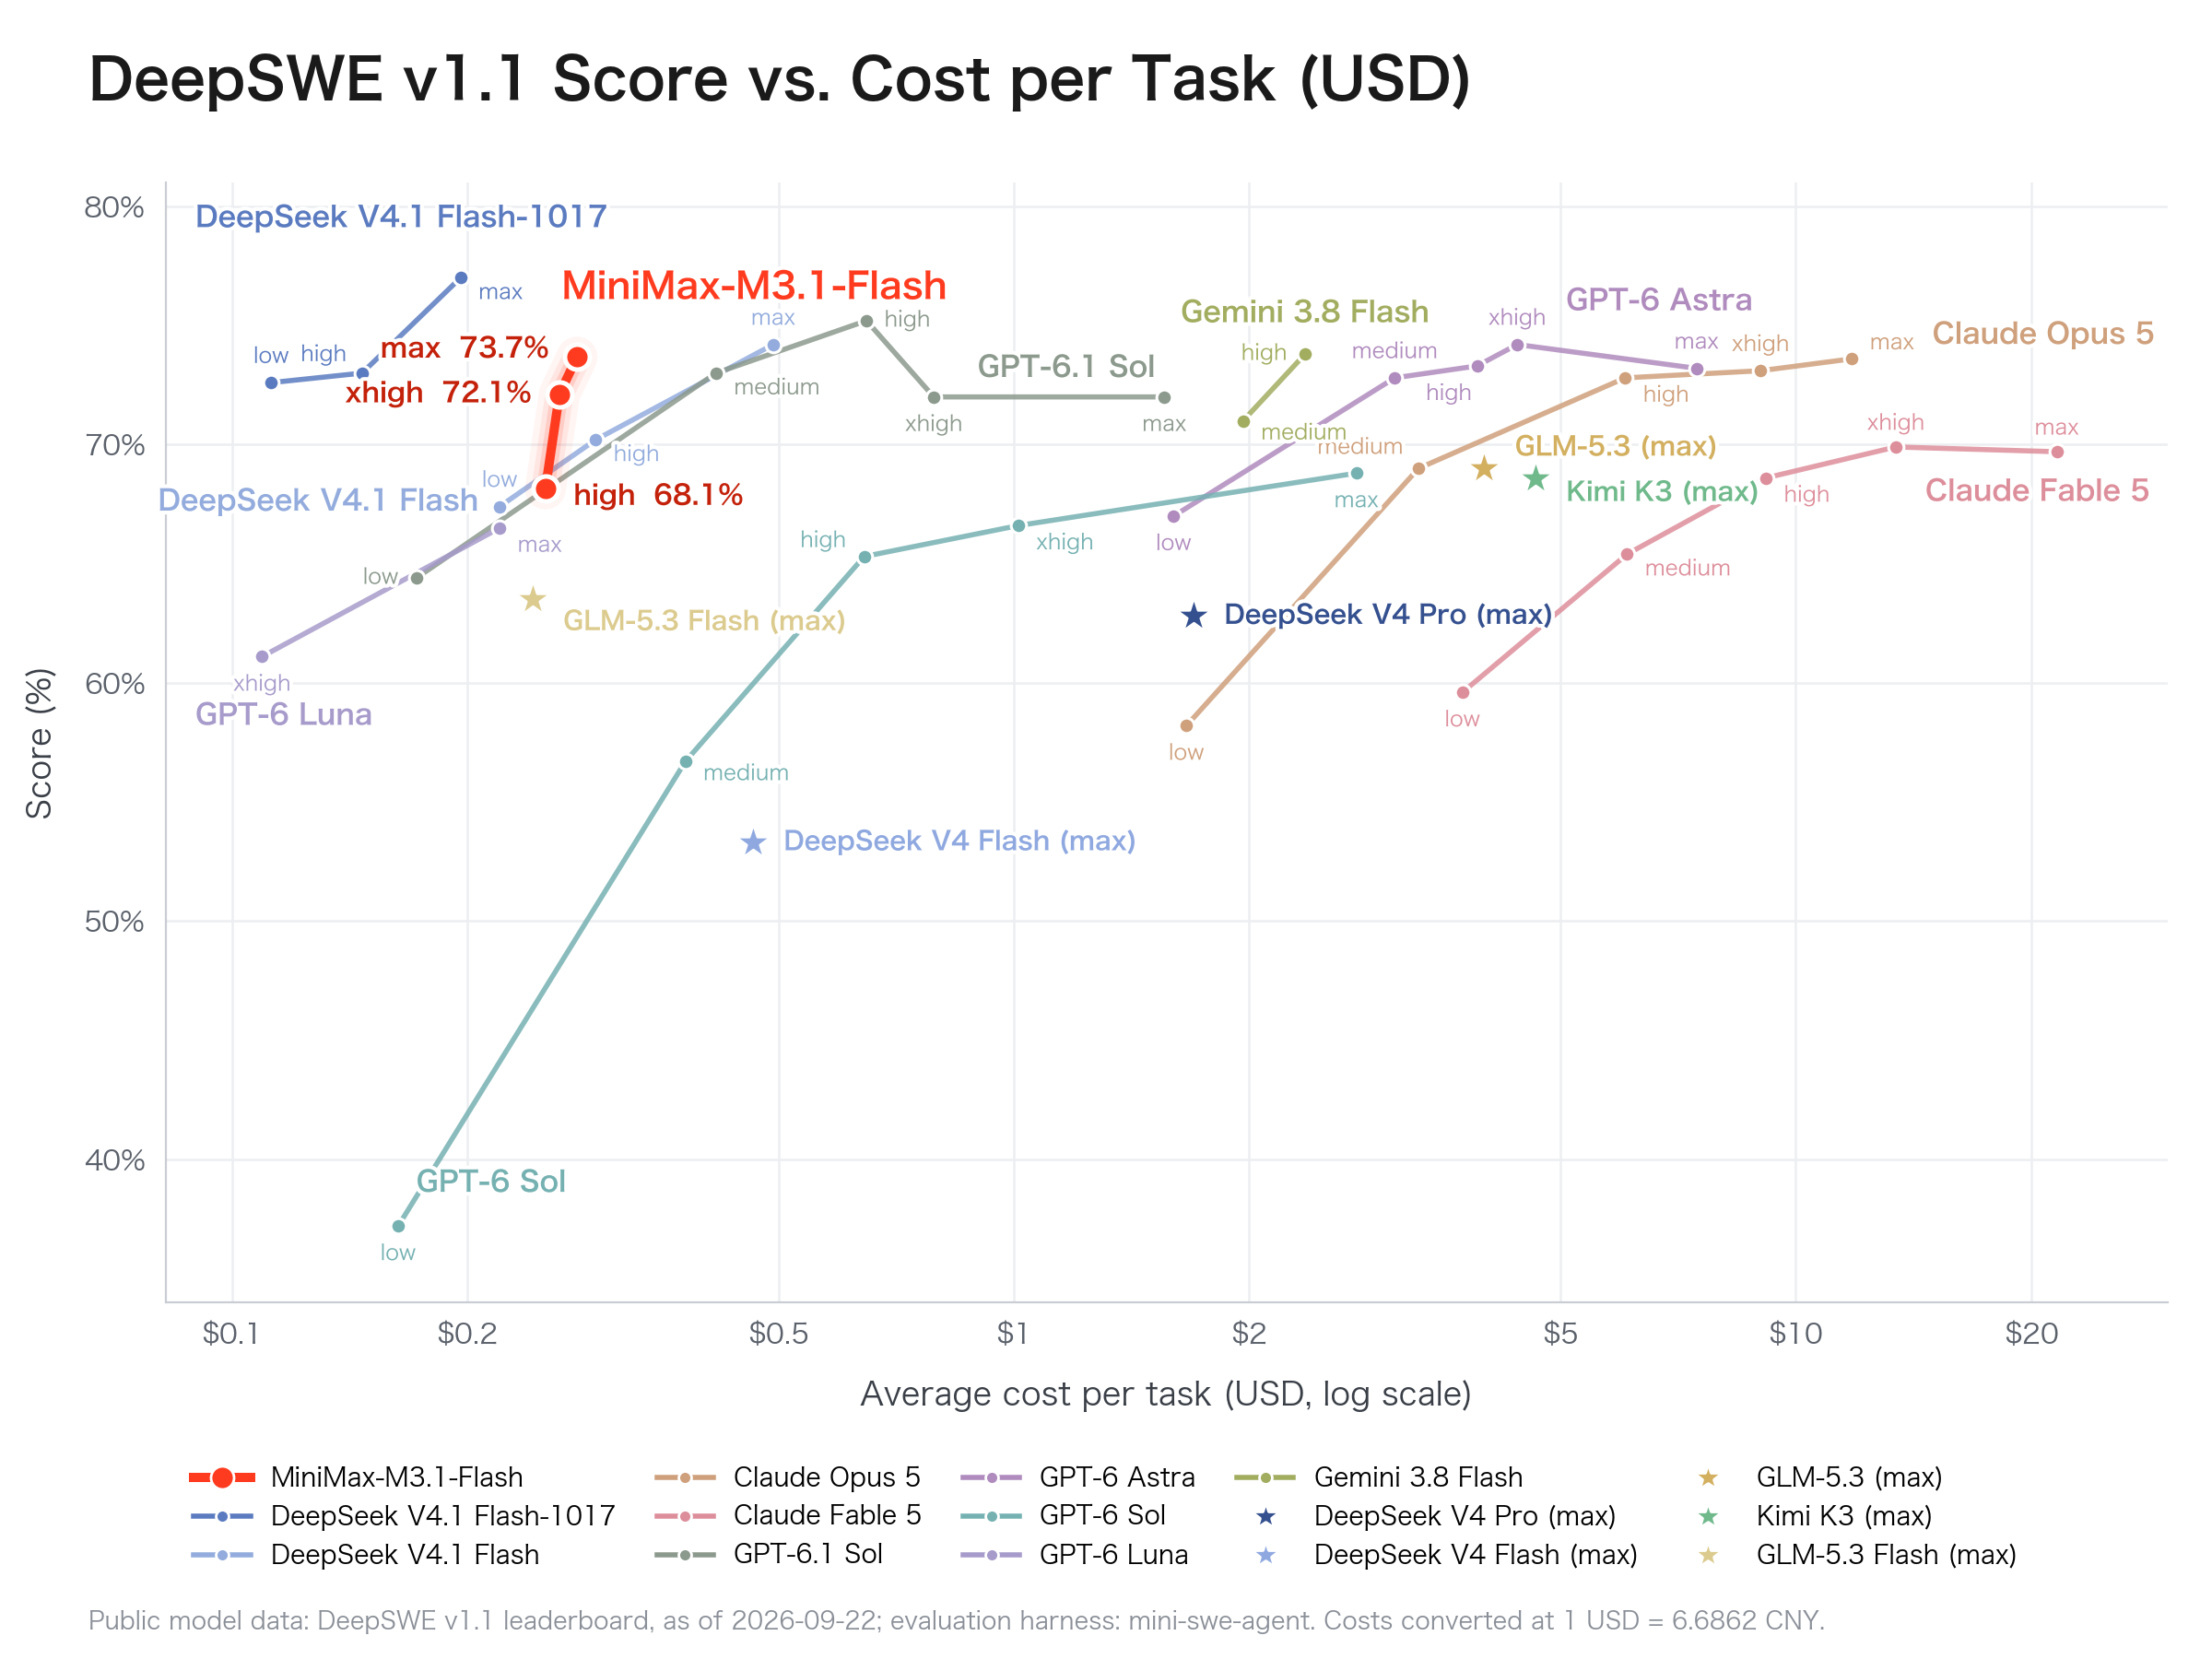
第二张图更狠。在 DeepSWE v1.1 上,M3.1 Flash 的三档 effort 分别是:max 73.7%、xhigh 72.1%、high 68.1%,而对应的单任务成本都落在 $0.2-0.3。
对照右边的曲线:Claude Opus 5 的 max 档在 $10-20 一线,Claude Fable 5 在 $5-15,GPT-6 Astra 在 $3-8,GPT-6 Sol 要 $0.5-1。
同一个基准、同一档 effort,成本差 25 到 100 倍。
跑分与价格的赛道分裂
把 M3.1 Flash 放进 2026 年的开源权重时间线,这条线更清楚:
- 2024 年:Meta Llama 3.1 405B 开源,价格战还没开始
- 2025 年 4 月:DeepSeek V3 用 1/30 的价格卷到了 GPT-4o 级别
- 2026 年 9 月:DeepSeek V4.1-Flash-1017,工具 API 5 元/千次
- 2026 年 10 月 16 日:中国商务部 23 项 AI 出口管制(1019 写过)
- 2026 年 10 月 16 日:Meta Muse Spark Open 816B / 42B 激活 / 两台 Mac Studio 跑得动
- 2026 年 10 月 19 日:MiniMax M3.1 Flash,$0.15 / 1M,10-23 开源
这一周里发生的事密度是过去一年最高的。M3.1 Flash 把中国 AI 价格战的时间线从「年降 60%」的节奏推到了「半年降 60%-70%」。
The Decoder 的判断是「中国 AI 价格战无底线」。这个判断很直白,但更准确的说法是:中国 AI 厂商愿意用低毛利换市场份额,而市场份额反过来是闭源 API 业务的关键,M3.1 Flash 的「商用便宜 1/3」战略,本质是「用开源权重抢心智,用闭源 API 收钱」。
200+ TPS 与推理架构
M3.1 Flash 的另一个杀手锏是速度。
官方数据:输出 200+ TPS(tokens per second),常规负载中位数 170+ TPS。这意味着什么,一个 1000 token 的标准回复,单卡实例在 5-7 秒内出完。
MiniMax 的官方说明是「更激进的稀疏性(aggressive sparsity)」优化,这是 MoE 模型的拿手好戏:100 个专家里只激活几个,每次前向只算 5%-10% 的权重。DeepSeek、Qwen、Mistral 都用类似路径。M3.1 Flash 把这条路径压到了 42B 激活参数的级别(总参 428B 在 preview 期间),单实例成本极低。
对 Agent 场景的直接影响是:单 agent 任务的端到端延迟从几秒压到一两秒,用户感知从「等 AI」变成「和 AI 对话」。这是 Agent 工作流能不能进入日常工作的关键阈值。
速度与成本是同一个设计的两面。前面两张官方散点图里,MiniMax 的点之所以能贴到纵轴,靠的不是单点优化,而是「稀疏激活把单次前向的 FLOPs 降下来 + 推理基础设施把吞吐做上去」的组合。官方 DeepSWE 数据里 $0.2 一任务的成本线,正是这个组合的结果。
配合 1019 的中国 AI 出口管制:护栏 + 加速的双线
把 1019 与 1020 这两天的事放在一起看,是一张有意思的镜像。
1019,10 月 16 日,中国商务部 + 科技部公告 23 项 AI 技术入禁止出口目录,但「已开源的明确豁免」。
1020,10 月 19 日,MiniMax M3.1 Flash 在中国 AI 出口管制生效后第三天发布,10-23 开源权重,这是 1019 公告里最直接受益的发布:M3.1 Flash 走的就是「开源 → 商用 API」的双轨路径,开源权重获得「公开发布」的事实标记,商用 API 不受 23 项目录约束。
两边同时在做相反方向的事:
- 中国 1019:通过管制目录给 AI 出海装护栏
- 中国 1020:通过开源 + 价格战把 AI 出海的速度拉满
这不是矛盾,是**「边界 + 加速」的双线并行**,目录管住权重出海的具体技术类别(智能体 loop、算力集群、信息处理),而开源与 API 是被鼓励的方向。
写给开发者的实操
短期三件事。
第一,如果你的工作流跑的是「单 agent 长任务」而不是「复杂多步推理」,比如批处理数据、批量文档解析、客服场景的单一任务 agent,M3.1 Flash 的 $0.15/$0.60 + 200 TPS 几乎无对手。官方 DeepSWE 数据显示,同一档 effort 下它的单任务成本在 $0.2-0.3,Claude Opus 5 的同一档要 $10-20。建议等 10-23 权重放出后自托管跑一次,按 $0.2/任务 的成本线做预算,比 $10 一任务的模型低两个数量级。
第二,如果你的工作流是「复杂多步 agent」(M3.1 Flash 跑的 Automation-Bench-AA、DeepSWE、OSWorld V2、ALE 这些基准测试场景),M3.1 Flash 性价比强但绝对能力仍落后 DeepSeek V4.1 Flash 1017 与顶级闭源模型。选 M3.1 Flash 还是选 GLM-5.3-Flash、DeepSeek V4.1 Flash,看你愿意为多出来的 8-15 分 Artificial Analysis Index 付多少溢价。
第三,Space Bunny 模式值得记下来。让模型匿名在生产环境跑两周再正式发布,这是 MiniMax 给所有中国 AI 厂商的一课。200 万亿 tokens 的真实使用数据 + HN 第一首页 + r/LocalLLaMA 官宣帖 + 多个 X 账号自发转推,这比花同样的钱做一波市场发布,信任度强得多。
写在最后
MiniMax M3.1 Flash 发布在 10 月 19 日,模型权重 10-23 开源。
它把 MiniMax-M3 的输入价砍到 1/3,跑分落后 DeepSeek V4.1 Flash 1017 但价格只有 1/3。Space Bunny 10+ 天匿名 200 万亿 tokens 的真实使用,发布时已经有市场验证。200+ TPS 速度让 agent 工作流进入「秒级响应」。
接下来一个月值得关注的是 10-23 权重放出后:
- Hugging Face 下载量与社区评测:是技术圈的认可还是市场圈的认可是两个信号
- 国内厂商的连锁反应:GLM 5.5、Kimi K3.1、Qwen 4.0 Max 是否也跟着打价格牌
- DeepSeek V4.1 Flash 1017 的下一代:「工具 API 5 元/千次」会不会被 MiniMax 的 $0.15 进一步逼降
这不只是 MiniMax 的事。当一家中国 AI 厂商把价格砍到上一代 1/3、跑分与第一梯队并列、还附 200+ TPS 与 Space Bunny 验证,整个开源权重阵营都在被它拖着往下走。
参考来源
- MiniMax 官方博客:M3.1 Flash 发布稿(2026-10-19)
- OpenRouter:minimax/minimax-m3.1-flash:free(1M 上下文)
- Artificial Analysis:MiniMax-M3.1-Flash 跑分页
- r/LocalLLaMA:MiniMax M3.1 Flash released, Model weights Oct 23
- Hacker News:MiniMax M3.1 Flash(338 分 / 150 评论)
- The Decoder:China’s AI price race has no floor in sight
- BestBlogs EP211 · 10-20 Daily 摘要
- 之前中国 AI 价格线:DeepSeek 1000 亿融资与估值不涨(1018) / 中国 23 项 AI 出口管制(1019)
哪些内容尚未独立验证:10-23 权重放出后实际下载量与第三方评测需写时刷新;M3.1 Flash 的「日均 token 服务量」与「商用 API 收入结构」MiniMax 未披露,「开源 + 商用双轨」的实际占比需要更长观察期。