10 月 24 日,Moonshot 正式发布 Kimi K3.1 系列的前两个模型:K3.1 Pro 和 K3.1 Pro Highspeed。API 已经上线,Pro 是多模态推理模型,带 1M token 的上下文窗口(context window,即模型一次能读进来的文本长度);Highspeed 是配套的提速版,面向对延迟敏感的场景。官方明确承诺:完整模型权重(open weights,指把模型参数文件放出来供人自行部署)将在 11 月 4 日前放出。
先把信息来源说清楚:发布事实以 Kimi 官方博客和 Simon Willison 的笔记为准;Terminal-Bench 4.0 的分数目前主要见于 AI Weekly 等媒体的援引,写作时我尽量标了口径,最终以官方博客更新为准。社区侦察的部分来自 Twitter 截图,可信度参差,下文会逐条说。
这次发了什么
K3.1 Pro 的定位是 K3 的后训练升级版,官方说法是「最能打的 3T 级开放权重模型」,主打 coding agent(编程智能体)和 agentic(智能体化)场景。Kimi 官网给的使用场景写得挺直白:复杂编程项目、3D 建模、金融研究。1M 上下文这个数字不算新,K3 就有,但配合新的 thinking effort 分级,同一句话给模型「想多久」的空间就不一样了,这个后面说到侦察链再展开。
同发的 Highspeed 值得单独一提,官方口径是速度做到 Pro 的 2-3 倍。旗舰配提速版的打法,DeepSeek 用过(V4.1-Flash),OpenAI 和 Anthropic 也在各自产品线上实践过。道理不复杂:代理场景里大部分调用不需要满血推理,延迟和价格敏感的任务走高速版,难任务才上 Pro。双版本分线这件事,今年基本成了默认配置。
Terminal-Bench 4.0:换了个考场
按 AI Weekly 援引的官方口径,K3.1 Pro 在 Terminal-Bench 4.0 上拿到 65.7%,GPT-6 Astra 是 58.2%,差了 7 个多点。不过第一名仍然是 Claude Opus 5.5 的 66.4%,K3.1 Pro 咬得很近但没过线。顺带一提,官方脚注里写着这项评测用的是 Claude-Code harness 跑的——拿竞争对手的架子测自家模型,这个细节挺诚实。
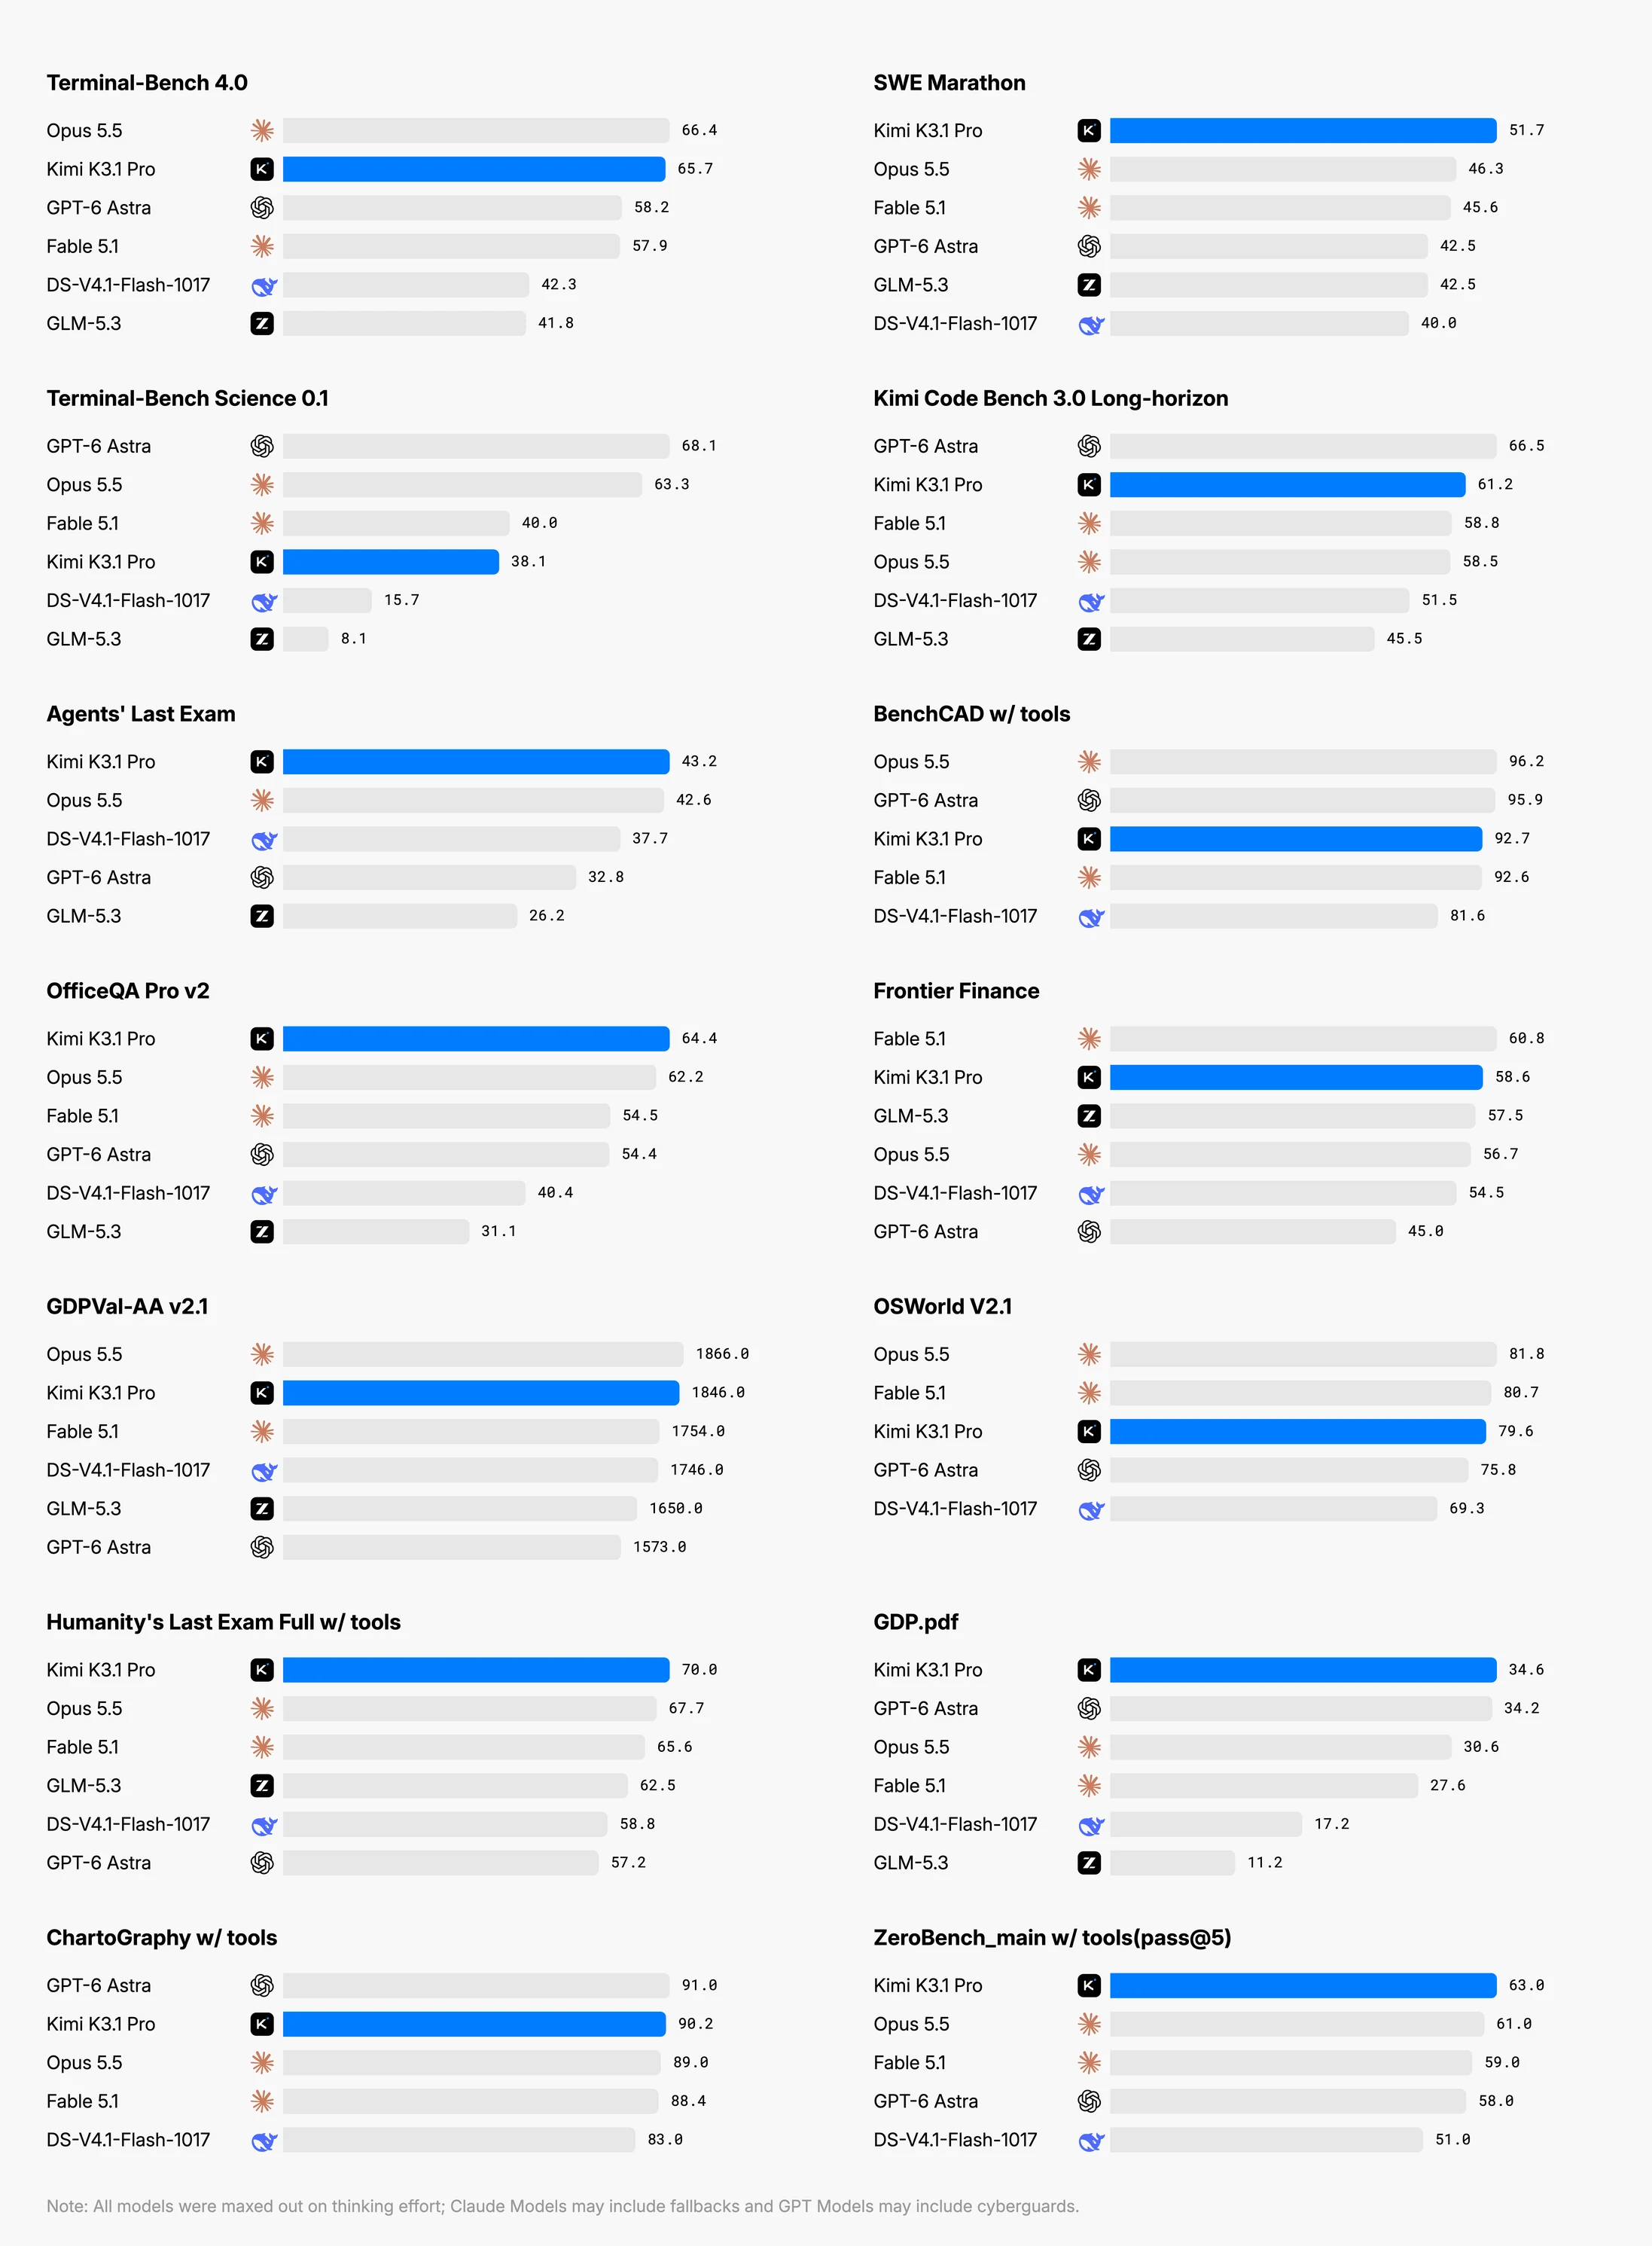
这个数字该怎么看,我觉得考场比分数重要。SWE-bench 这类基准(benchmark,即标准化测试集)的问题这几年被翻来覆去讲:题目见过太多次,刷分空间越来越大。Terminal-Bench 考的是另一件事:给模型一个真实的终端环境,让它装依赖、跑命令、调环境变量、修到测试通过为止。这更接近 coding agent 日常工作里最繁琐的那部分,也更难靠背题拿分。
当然,7 个点的领先放在单一基准上说明不了全部。SWE-bench Pro 上各家互有胜负,不同 harness(支架,指包裹模型的工具链和执行环境)跑出来的名次都可能翻盘。但至少说明一件事:在「真终端干活」这个赛道上,第一梯队不再只属于闭源头部。这是 K3 以来 Moonshot 一直想证明的事,这次算是又往前挪了一步。
复盘:一场提前一周开演的发布会
这次发布最有意思的部分,其实发生在官宣之前整整一周。
10 月 20 日前后,Twitter 上的模型侦察账号(@AiBattle_、@aitrackerbot 等)陆续发现:一个 SGLang 的 pull request 在提交 7 分钟内被关闭,但测试数据已经被人截走,里面显示 DeepInfra 在 10 月 18 日就部署了一个运行中的 Kimi-K3.1 实例;配置里还有 thinking effort(思考力度)分级,泄露截图的版本对不上,一说从 none 到 max 有七档,一说四档默认 max;图片输入支持倒是各方说法一致。
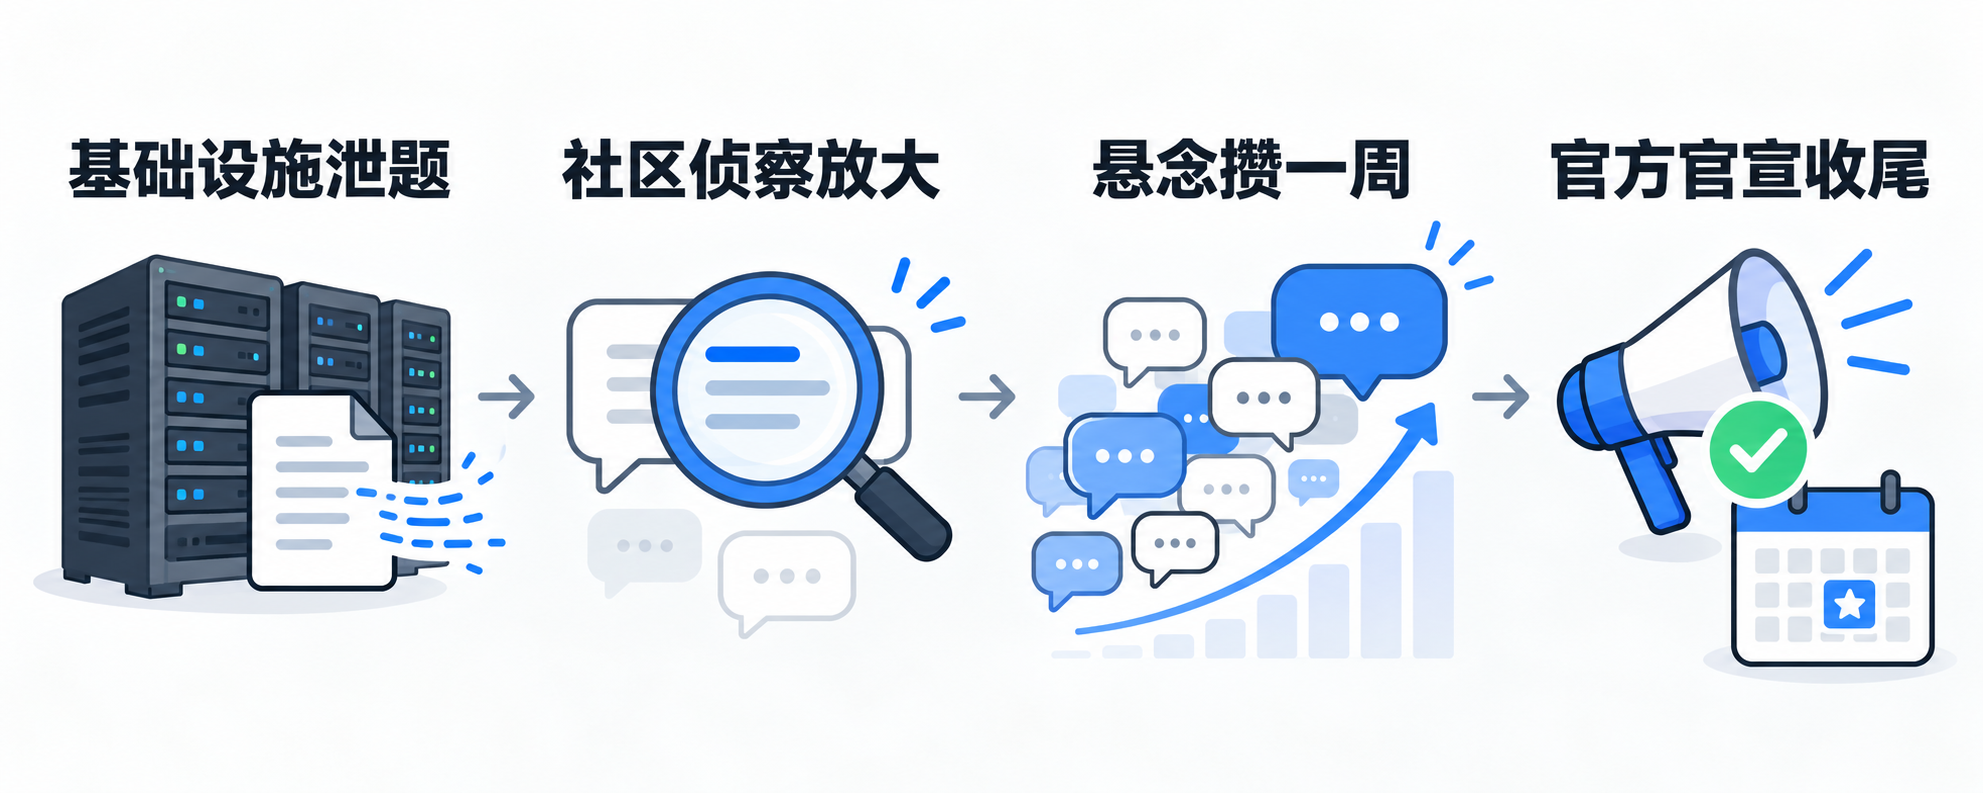
换句话说,基础设施先泄了题,社区侦察账号接棒放大,悬念攒了整整一周,等官方官宣的时候,只需要补上分数和日期。对 Moonshot 来说这一周是免费的预热期,各路博主把「K3.1 要来了」讲了一遍又一遍。中文圈的推法更直接:「Kimi K3.1 和 GLM-5.5,两大国产模型蓄势待发,就看谁先扔王炸」——智谱 GLM-5.5 也在路上,这种对决叙事对国产模型是最好的话题。
要说清楚的是,侦察链里的细节(DeepInfra 部署时间、七档还是四档)都来自推特截图,官方从未确认。当八卦看可以,当事实引用要小心。
倒计时开源:把承诺做成节拍器
11 月 4 日这个日期,才是这次发布里我最在意的部分。
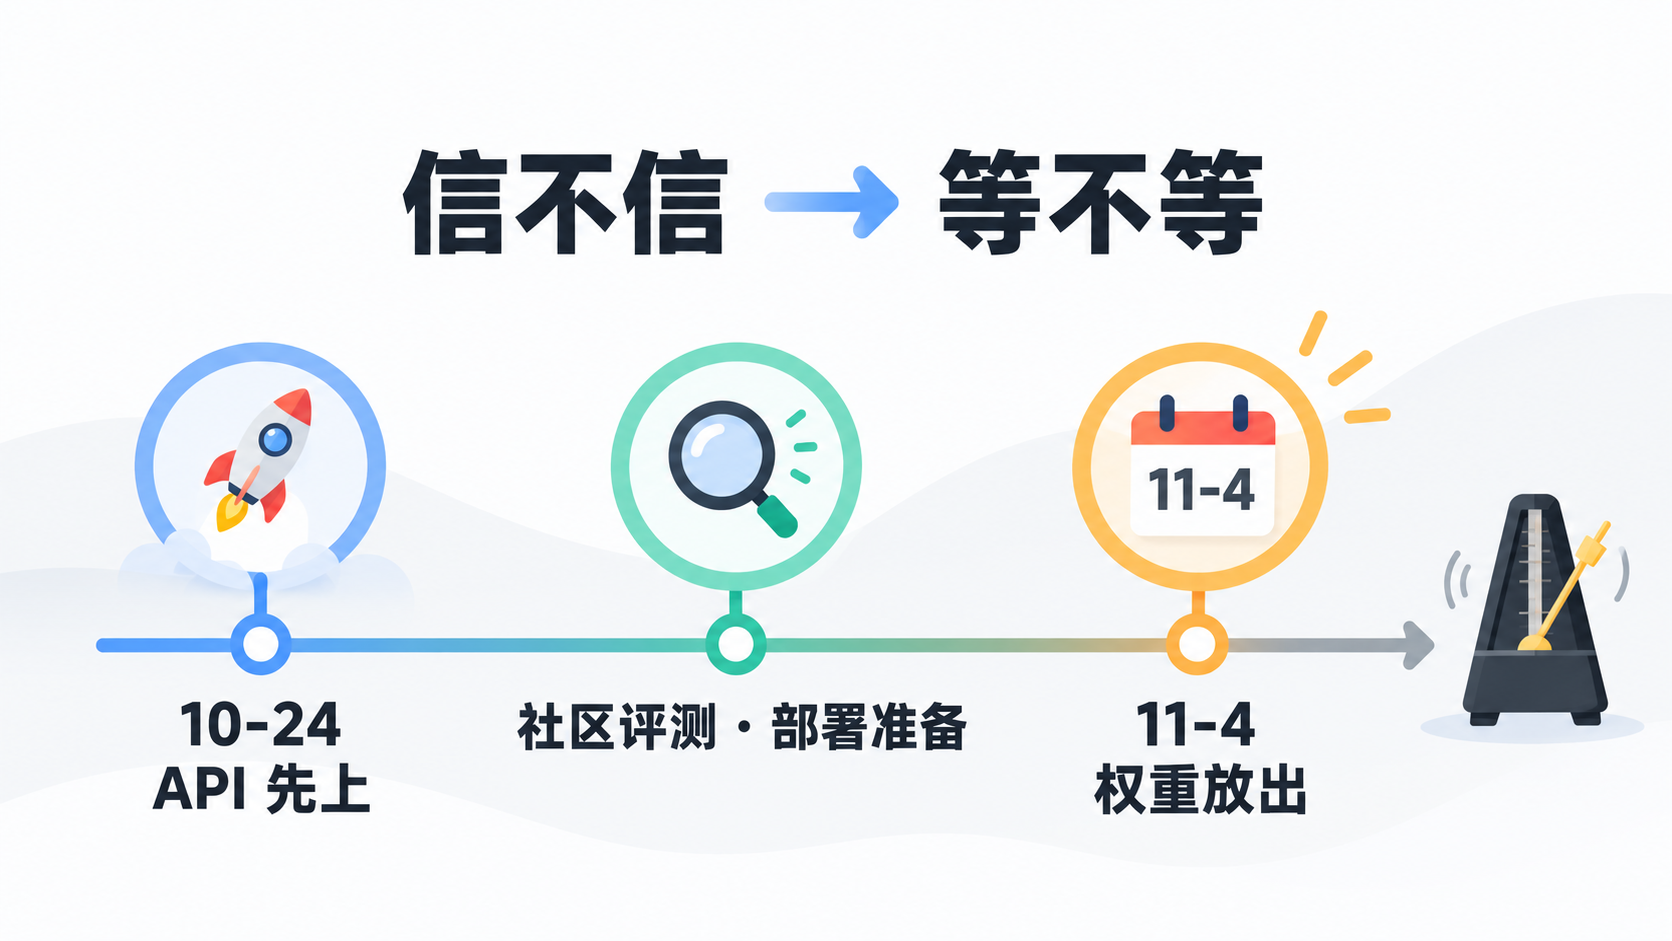
去年说到国产模型开源,语境还停留在「放个权重证明我开放」。现在 Moonshot 把它变成了一个精确到日的倒计时:API 先上,收第一批真实用户和反馈;权重后放,让社区有时间准备评测和部署;中间十天,媒体的每一篇报道都会替它把「11 月 4 日」重复一遍。Simon Willison 在笔记里也专门记了这句承诺。他的读者里有多少人会为此设个日历提醒,不好说,但传播已经完成了。
对比另一边的闭源头部:模型发布即孤岛,API 之外你什么都拿不到,基准分数只能听厂商自己讲。开源倒计时把「信不信」的问题换成了「等不等」——等得起,因为日期是确定的。开源在 2026 年的这个用法,与其说是姿态,不如说是发布节奏的一部分,顺手还当了营销工具。
有人会觉得这对「真开源」是一种消解。我倒觉得无所谓,权重真放出来的那一刻,社区拿到的实际价值不会因为动机打折扣。倒计时机制反而给了外部一个验收节点:到时候放没放、放的是不是完整权重、评测跑出来和 API 版本差多少,全都有据可查。承诺越具体,越赖不掉。
现在该不该切过去
给个实操建议。
如果你的工作流重度依赖 coding agent(Claude Code、Codex 这类),K3.1 Pro 值得测,但建议等两天再动手:一是 11 月 4 日权重放出后,本地部署版本和 API 版本的表现差异会有社区实测数据,比现在单看官方口径可靠;二是各家第三方托管(OpenRouter 等)的价格和稳定性也需要几天沉淀。已经有 1M 上下文长文档分析、图片输入这类明确需求的,可以直接开个 API 试。
反过来说,主力链路已经稳定跑在 Claude Code 或 Codex 上的,没必要为了 7 个点的终端基准迁移。基准领先和日常顺手之间隔着工具链成熟度、上下文记忆、hooks 生态这些东西,迁移成本比多数人想的高。我倾向于认为,K3.1 Pro 真正的考验不在今天的榜单,11 月 4 日之后才是:当所有人都能在本地跑它、拿它换着 harness 测的时候,分数还剩多少。
写在最后
把这篇里的几个概念收拢一下,因为它们其实是一套东西。
侦察链在发布前:基础设施的部署痕迹先于公告暴露,社区账号完成放大,厂家顺势收下预热。倒计时开源在发布后:API 先收真实使用,权重按确定日期放出,把「信不信」变成「等不等」。而 Terminal-Bench 这类代理基准站在最后,负责裁决——侦察链制造的预期,倒计时发出的邀请,最后都要拿到基准和实测面前对账。
所以与其把这次发布看成「又一个模型放榜」,不如看成一次发布方式的演示:把一次性官宣拆成一段可以被公众持续检验的时间线。分数今天领先不代表什么,权重放出之后经不经得起第三方复测,才是 K3.1 Pro 真正的考试。
11 月 4 日见。
参考来源
- Introducing Kimi K3.1 Pro - Kimi 官方博客
- Introducing Kimi K3.1 Pro - Simon Willison
- Moonshot releases Kimi K3.1 Pro and says it cut its … - TNW
- Moonshot AI Releases Kimi K3.1 Pro, First Model in New K3.1 Series - Unite.ai
- Kimi K3 - OpenRouter 模型页
- AI News Today, October 24 - AI Weekly(Terminal-Bench 4.0 分数援引出处)
- Twitter 社区侦察线索:@AiBattle_、@aitrackerbot(2026-10-20 前后推文,未获官方确认)
以上来源用于核实发布口径与社区反馈,其中基准测试分数以官方博客更新为准,社区侦察细节不等同于经过验证的事实。