本文事实基于 Meta 官方博客(research.meta.ai,2026 年 10 月 15 日发布)、Hacker News 与 r/LocalLLaMA 的实时讨论数据(发稿前经 HN Algolia API 刷新)、The Decoder 及多家媒体转述。文中 Mac Studio 价格为按苹果上一代 Ultra 台式机定价的推算,非官方数字;Arena 评分发布时尚未公布。中国模型主导开源榜的说法援引自 The Decoder、Import AI 及 X 上开发者的公开表述。
816B 总参数、42B 激活、100 万 token 上下文,权重开放下载。
10 月 15 日,Meta 发布 Muse Spark Open,官方博客标题起得毫不谦虚:The Most Capable US Open-Weight Model to Date,迄今最强的美国开源权重模型。Hacker News 当天把它顶到了第一名,发稿前是 593 分、334 条评论。r/LocalLLaMA 的官宣帖 922 分,评论区则被另一种情绪刷屏:美国开源模型,终于有人接招了。
但这个模型真正值得写的,不是参数,是它选择落地的方式:两台 Mac Studio。
「跑得动」的账本
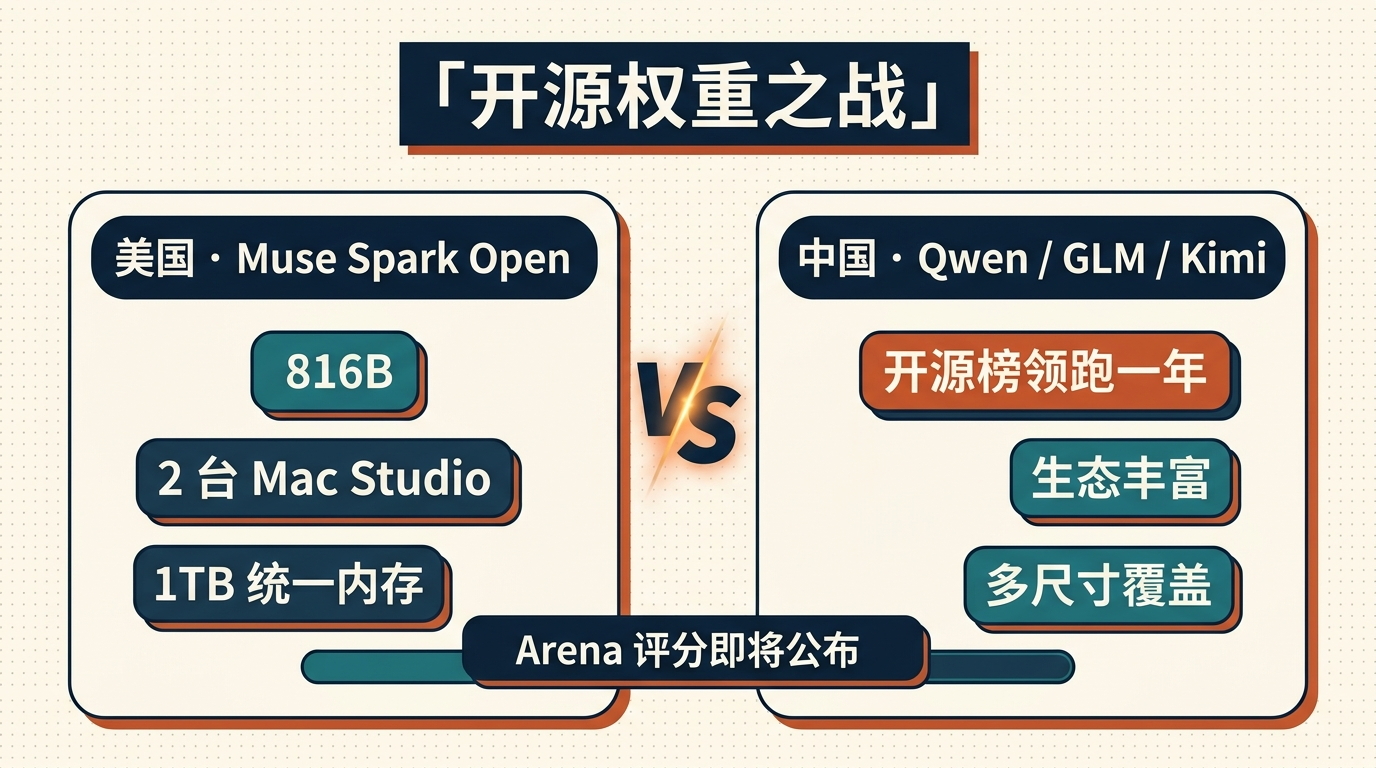
先看规格。Muse Spark Open 是原生多模态的 MoE 模型,总参数 816B,每个 token 只激活 42B。这意味着「跑起来」的第一道门槛卡在内存上:816B 参数哪怕量化后也得几百 GB 放得下。
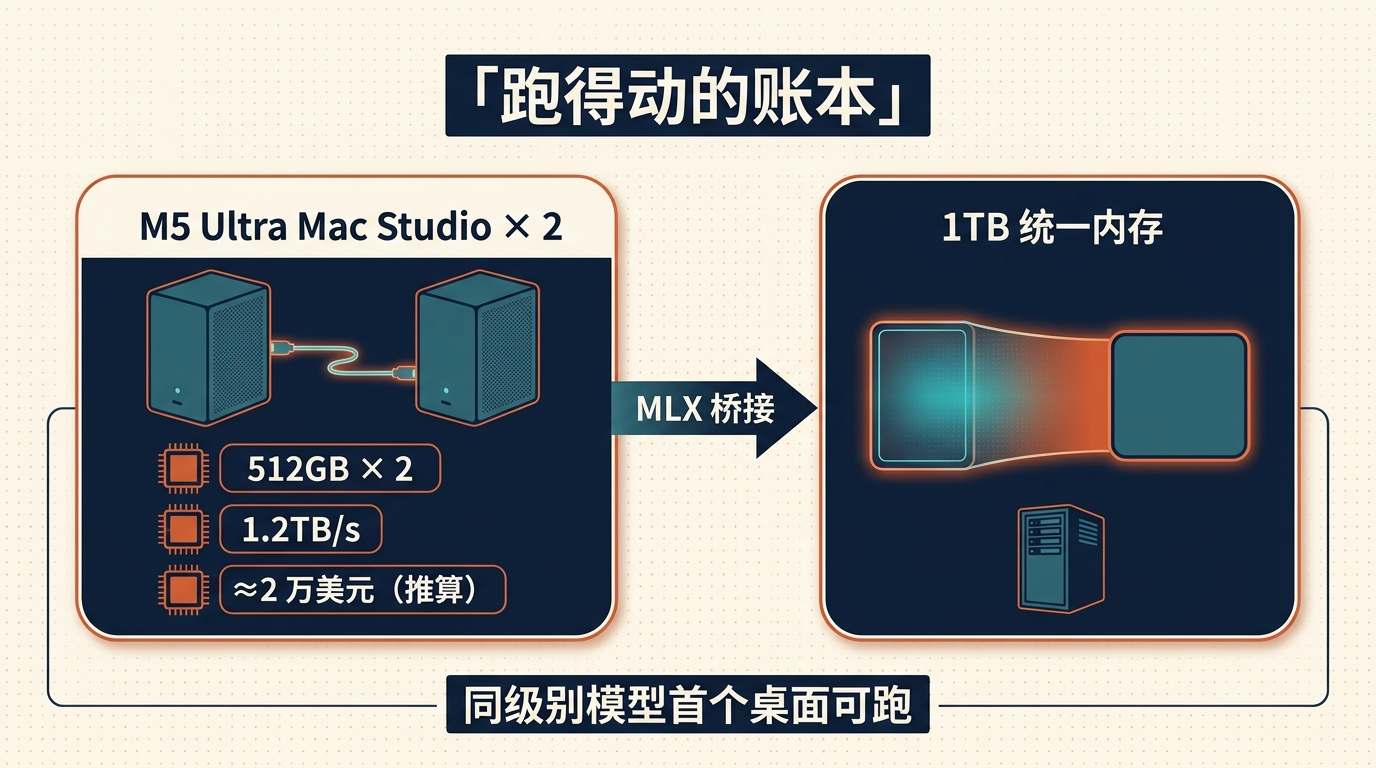
Meta 给的答案是 Apple 的统一内存架构。M5 Ultra 芯片的整合 GPU 可以用到每台 Mac Studio 512GB 内存,内存带宽 1.2TB/s,正好够读每个 token 需要的那一小片权重。两台 Mac Studio 用 MLX 框架连起来,等于一台拥有 1TB 统一内存的机器。官方博客的原话是:两台 Mac Studio 表现得像一台超算。
这是同级别模型里第一个宣称能在桌面上跑的。Meta 还给了一组不像是公关稿的实测案例:用 Muse Code 驱动这套本地配置,给开源 Mastodon 客户端 Ice Cubes 交付了真实的 iOS 改动,修 bug、加功能、走完整构建流程;另一个案例是端到端驱动 DaVinci Resolve,模型逐帧看素材,挑出最有力的镜头再裁成竖屏。
然后是钱的部分。苹果没有公布 M5 Ultra 款 Mac Studio 的定价,按上一代 Ultra 台式机 512GB 档的定价推算,单台在 9500 到 10000 美元上下,两台大概 2 万美元,折合人民币 14 万上下。这是估算,不是官方数字,但量级不会差太远。
所以「在你家桌上跑旗舰开源模型」这句话,准确的读法是:在一张价值 2 万美元的桌子上。
中国队休息了一年,美国队终于上场了
Muse Spark Open 发布的同一天,The Decoder 给它的定位是一句火药味很足的话:Meta 对 Qwen、GLM 和 Kimi 的回应。
这话有背景。过去一年的开源权重榜单,前排基本被中国团队包揽:阿里的 Qwen、智谱的 GLM、月之暗面的 Kimi 各有各的地盘。Import AI 第 476 期的标题干脆把「比中国开源模型更差」当成了美国模型的问题陈述。r/LocalLLaMA 本周另一张 4,143 分的热帖,标题就叫「太平洋对岸太安静了」,522 条评论在猜中国队伍什么时候出手。
Muse Spark Open 落地几小时内,X 上一条被反复引用的推文大概是最好的情绪采样:「美国开源模型度过了全年最好的一天。中国统治开源权重已经一年了。总算有像样的较量了。」
有个丑话说在前面:「统治」这个词来自媒体和社区,不是某个榜单的官方结论。但方向没有争议:在这之前,讨论「最强开源模型」时,候选名单里几乎没有美国名字。现在有一个了,而且 Arena 评分即将公布,成色马上见分晓。
Meta 和 Apple 的意外同盟
比模型本身更有信息量的,是发布页上并排出现的两个 logo。
Muse Spark Open 专门为 Apple 的 MLX 框架做了优化,官方明确说「两台 M5 Ultra Mac Studio 是在自家桌面跑强大模型的最佳方式」。Meta 负责模型,Apple 负责让模型跑起来的机器,两家公司在营销物料里互相抬轿。
这两家可不是传统盟友。一个的生意是把所有人的社交和注意力收进自己的 App,另一个的生意是卖装得下这些 App 的设备。但在「AI 跑在谁的硬件上」这个问题上,利益突然对齐了:Meta 需要证明开源模型不只能活在数据中心,Apple 需要一个说服开发者买高配 Mac 的理由。日本媒体对这次联手的概括很直白:AI 的主战场,可能正在回到桌面上。
同一天还发生了一件小得多、但值得记下的事:Meta 把随模型定制的 Helion GPU kernel 也开源了,在 SGLang 里对 NVIDIA 和 AMD 显卡有 1.03 到 3.95 倍的核级提速。开源的不只是权重,还有让权重跑得更快的那层代码。
权重免费,算力自备
「Meta 开源了大模型」这句话,得拆成三层来看。
第一,license 不是完全放开。Muse Spark Open 用的是 Muse Model License,带有限商用条款,官方的说法是「允许许多开发者免费使用」,哪些用途受限,要看 model card 的细则。开源权重和无条件开源,是两回事。
第二,「桌面可跑」的真实门槛是 1TB 统一内存。两台 Mac Studio 的方案确实优雅,但它定位的是工作室和小团队,不是个人玩家。同周 r/LocalLLaMA 上真正属于个人玩家的热点是什么?有人在越狱的 PS5 显存上把 Qwen 27B 跑到每秒 20 token。两个热点放在一起,就是端侧 AI 的真实光谱。
第三,云 API 同步上线。Baseten、Fireworks、Groq、Modal、Nebius、OpenRouter、Together AI 七家平台首日接入,权重下载放在 Hugging Face、SageMaker、Google Cloud 和 Microsoft Foundry。想用的人有免费的路,想省事的人有付费的路,Meta 两头都不耽误。
所以更准确的说法是:Meta 开源了模型的重量,没有开源模型的成本。护城河没有消失,它从训练成本转移到了推理成本,而推理成本,恰好是苹果和七家云平台能帮忙收的部分。
写在最后
值得关注的,接下来两周有三件事。
Arena 评分公布,Muse Spark Open 和 Qwen、GLM、Kimi 的正面成绩单会直接回答「回应是否成立」。中国团队的反应速度,r/LocalLLaMA 那张「太平洋对岸太安静了」的帖子不会安静太久。还有 Mac Studio 的销量,如果 Meta 和 Apple 的联手是真的生意,高配 Ultra 的出货数据会先于任何评测说话。
开源权重战争打了半年,第一次出现了跨太平洋的对攻。上一次这种规模的较量和开放有关,还是 Android 和 iOS 的故事。这一次谁开放得更有诚意,谁把开放变成生态,可能比谁的跑分高 2% 更值得押注。
参考来源
- Meta 官方博客:Introducing Muse Spark Open
- Hacker News: Muse Spark Open(593 分 / 334 评论,发稿前经 HN Algolia API 刷新)
- r/LocalLLaMA: Introducing Muse Spark Open(922 分)
- r/LocalLLaMA: It’s been too quiet on the other side of the Pacific(4,143 分)
- The Decoder: Muse Spark Open is Meta’s answer to Qwen, GLM, and Kimi
- Hugging Face: Muse-Spark-Open-816B-A42B 模型卡
- Wikipedia: Muse Spark(816B MoE 参数条目)
- BestBlogs EP207 · Muse opens weights(2026-10-16)
哪些内容尚未独立验证:M5 Ultra Mac Studio 的价格为按上代定价的推算,官方未公布;「中国统治开源权重一年」为媒体与社区表述,非单一榜单结论;Arena 评分发稿时未公布;Helion kernel 提速数据来自 Meta 自测口径。文中星标与热度数据为发稿时点数。